上一篇在 3090 上调整 Strata,把 prefill 分块增大到 2048 后,4K 输入的首 token 延迟降到了约 3.4 秒。不过,让模型根据报错修代码时,仍然要等二三十秒。请求期间,进程会从磁盘读取两百多 MB 数据,decode 吞吐约为 30 token/s。
这台机器当时只有 32GiB 内存。Strata 已经把一部分专家权重放进显存,剩下的主机数据是否也能常驻?内存扩到 64GiB 后,等待会缩短多少?接到编码工具上,它又能完成哪些工作?
本文继续使用同一张 RTX 3090 和 Qwen3.8-Flash-Next-GSQ-RCO IQ2_XS。把 PLE 表常驻内存后,修复请求的平均 decode 吞吐从约 30 提高到 111 token/s,请求期读盘降为零。随后固定配置跑公开编码题:HumanEval+ 通过 156/164,函数生成中位数 3.17 秒;Aider Polyglot 的文件编辑与一次反馈修复通过 112/225,任务耗时中位数 47.5 秒。
这两组编码任务的差别,正好说明了后半篇要观察什么:模型写一个函数需要多久,接上编辑、编译和报错修复后,时间又花在哪里。
64GiB 内存里,实际要放多少数据
先把内存里的数据算清楚。这套模型除了 GPU 上的权重,还要在主机侧访问两块较大的数据。
一块是显存外的专家权重,本次约 16.17GiB。GPU 的 18GiB 专家缓存保存 13432 个专家槽,其他专家权重放在主机锁页内存中,供 CPU 计算或经 PCIe 交给 GPU。
另一块是 PLE 查找表。引擎根据当前及前面的 token 组合计算行号,读取表中的记录,参与后续模型计算。当前模型的表有 320001536 行,每行 90 字节,合计 26.82GiB。mmap 模式按访问需求把文件页带进内存;--ple-io ram 在加载时触碰全表,再用 mlock 保持驻留。PLE 实现
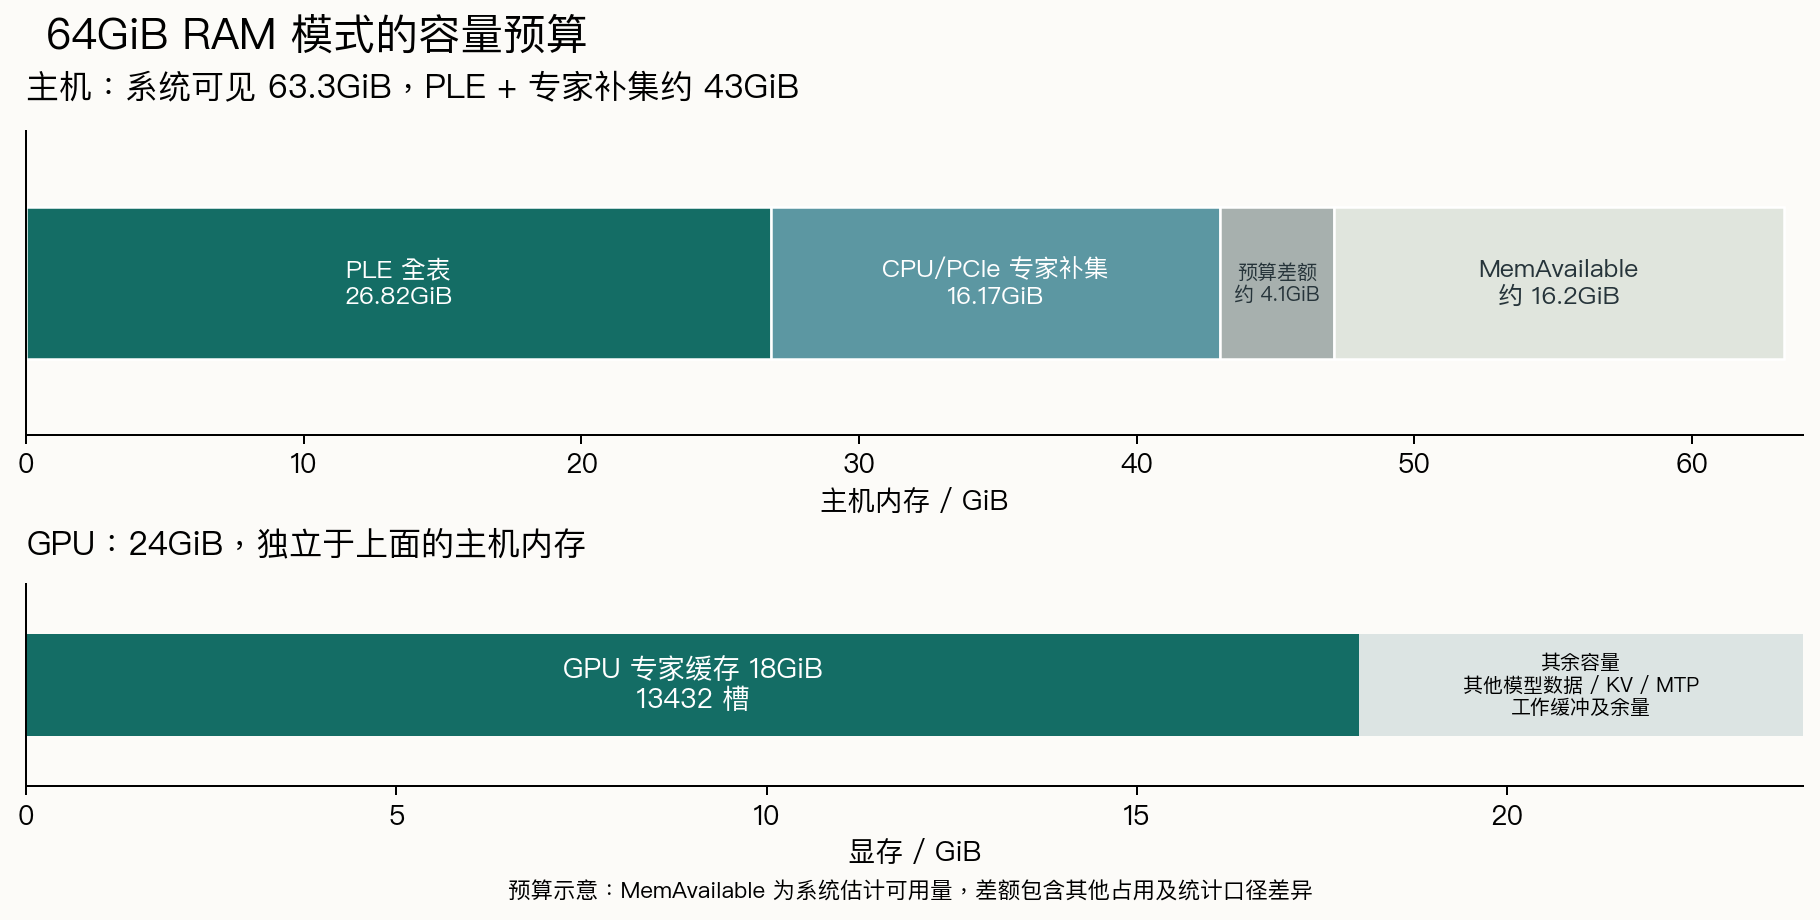
两块主机数据合计约 43GiB。这台虚拟机系统可见内存为 63.3GiB,RAM 模式加载完成后,MemAvailable 约 16.2GiB,用于系统、其他运行数据和请求工作区。本轮单请求、32K 上下文在这个预算内完成测试。
本文用加载日志核对两块数据的大小,再查看系统的 Mlocked 和 MemAvailable:前者确认 PLE 锁页量,后者观察加载后还剩多少可用内存。GPU 的 18GiB 专家缓存单独计量,其他显存用于模型其余计算、KV、MTP 和工作缓冲。
内存已经扩容,为什么还在读盘
容量对照保留同一张 3090、16 vCPU、模型与引擎,依次测试 32GiB mmap、64GiB mmap 和 64GiB RAM。每组两次独立启动,每次两轮任务,下面每项为四次请求的均值。TTFT 记录请求发出到首 token 的等待,decode 吞吐记录输出阶段的生成速度,E2E 记录请求开始到结束的完整耗时。
修复题是生成 retry_delays(attempts, base, cap):第 i 项为 min(cap, base × 2^i),同时处理非法参数、零值和 10000 次尝试。首答在大次数测试中出现溢出,再把实际报错交回模型修复。该轮输出上限为 1024 token,CPU/PCIe 使用自动分工。
| 指标 | 32GiB mmap | 64GiB mmap | 64GiB RAM |
|---|---|---|---|
| 4392-token 提取,平均 TTFT | 3.35 s | 3.73 s | 3.74 s |
| 17352-token 提取,平均 TTFT | 11.62 s | 13.11 s | 12.21 s |
| 修复请求,平均 decode 吞吐 | 30.0 token/s | 27.2 token/s | 110.7 token/s |
| 修复请求,平均端到端耗时 | 26.35 s | 26.05 s | 9.45 s |
| 每个修复请求,平均进程读盘 | 218.54 MB | 209.22 MB | 0 MB |
| 每个修复请求,平均 major fault | 1817.75 | 1736.75 | 0 |
| 修复完整且通过测试 | 3/4 | 3/4 | 1/4 |
| 达到 1024-token 输出上限 | 1/4 | 1/4 | 3/4 |
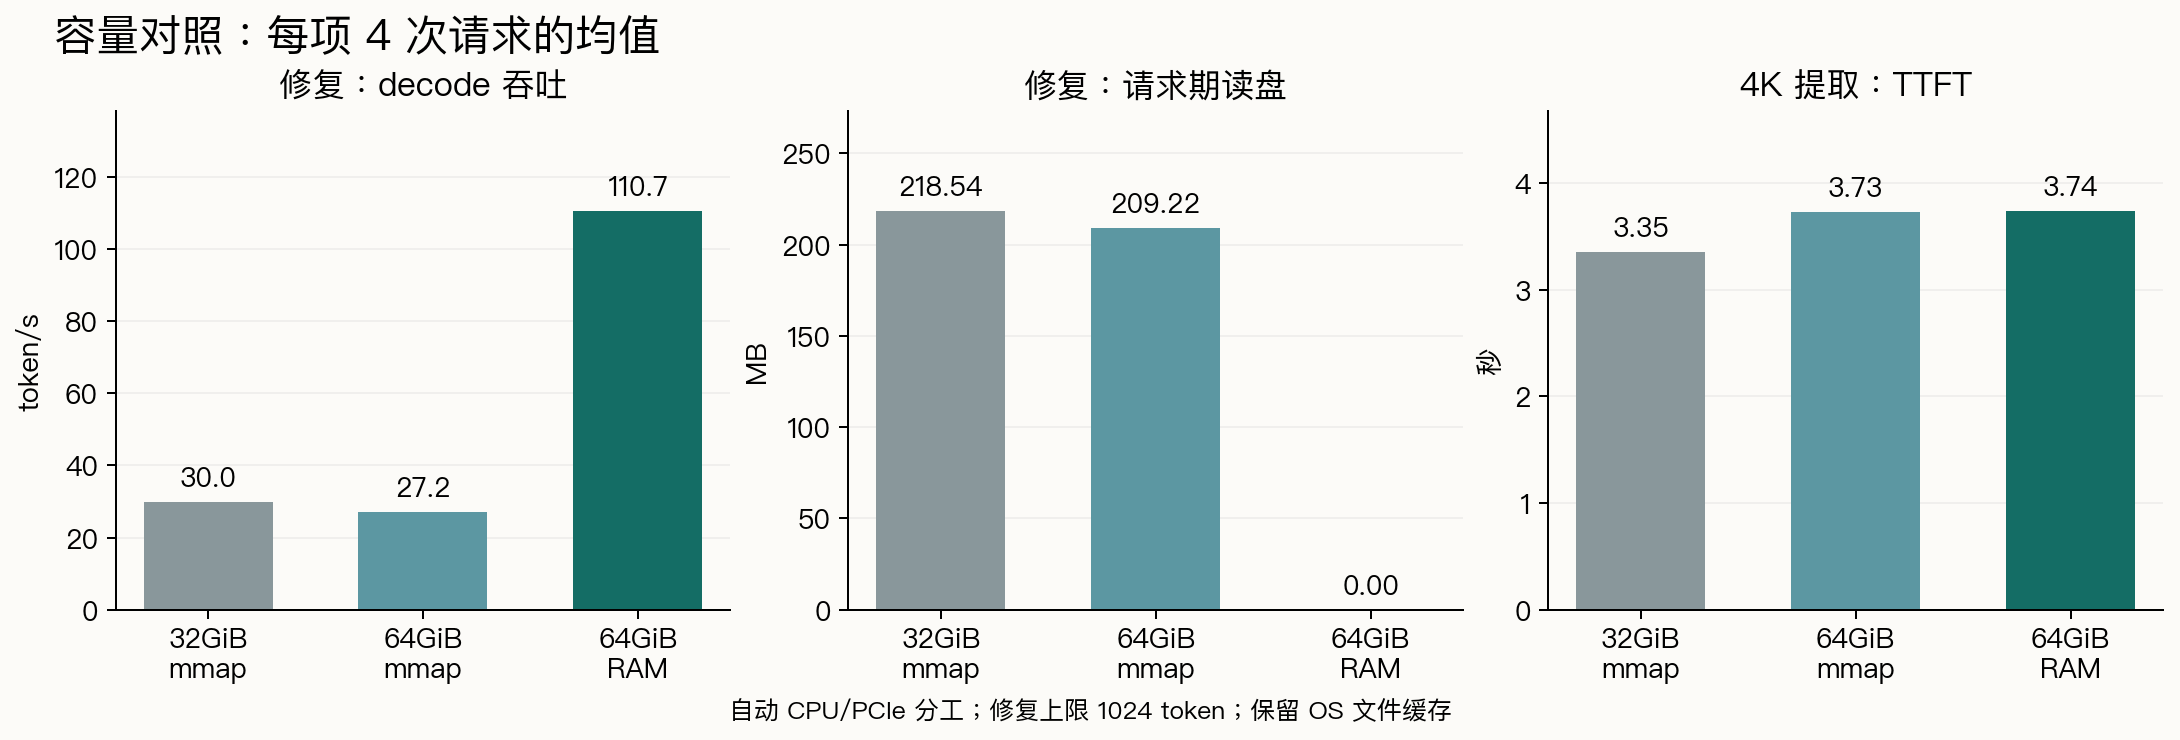
扩到 64GiB 后继续用 mmap,修复请求仍平均读取约 209MB。新增内存给文件缓存提供了空间,第一次访问尚未缓存的 PLE 页时,仍需从存储读取。切换 RAM 模式后,整张表在模型加载时预读,请求直接访问驻留页。
观测方法是分别记录请求前后的进程读盘字节和 major fault 计数。后者记录需要 I/O 才能处理的缺页。三组各 36 个请求累计读盘分别为 1494.47MB、1253.20MB、0MB,major fault 累计为 12451、10418、0。切到 RAM 模式后,这两项等待来源在请求期间消失,修复生成的平均 decode 吞吐提高到 110.7 token/s;长输入提取的 TTFT 则变化较小。
RAM 组四份修复中,三份写满 1024 token 后被截断,一份完整通过。平均 9.45 秒包含这些截断回答。下一步把输出预算提高到 2048,同时固定 CPU/PCIe 分工,观察生成能否写完,以及哪些资源仍在影响等待。三组容量实验中的自动分工取值保留在文末。
主动常驻还把读取成本移到了启动阶段。两次 RAM 模式的 PLE 装载分别用了 84.1 秒和 2.6 秒,完整加载分别为 226.3 秒和 142.2 秒,操作系统文件缓存状态不同。服务保持运行,可以把这次装载摊到后续请求中。
数据常驻以后,CPU 和 GPU 怎样分工
专家权重在主机内存中时,有两种处理方式:CPU 直接计算,再把结果交给 GPU;或者把权重经 PCIe 搬到 GPU 上计算。pcie_frac 控制未命中显存的专家如何分配。设为 1 时,尽量走 GPU 路径;设为 0.5 时,CPU 专家池承担一部分计算。
为了观察实际取舍,分别用 0.5 和 1 做三次独立启动。每次从同一份专家热度记录开始,按相同顺序执行区间合并、JSONL 日志汇总,以及两份退避修复。修复 A、B 分别使用预先保存的对话和报错,每组重放相同内容。共 48 个请求,输出上限统一为 2048;前缀复用、请求期读盘和 major fault 全部为零。
| 任务 | pcie_frac | TTFT 中位数 | decode 中位数 | E2E 中位数 | 完整通过 |
|---|---|---|---|---|---|
| 区间合并 | 0.5 | 0.53 s | 48.5 token/s | 3.77 s | 6/6 |
| 区间合并 | 1 | 0.82 s | 51.7 token/s | 4.00 s | 6/6 |
| 日志汇总 | 0.5 | 0.52 s | 60.0 token/s | 9.11 s | 6/6 |
| 日志汇总 | 1 | 0.51 s | 68.6 token/s | 7.88 s | 6/6 |
| 退避修复 A | 0.5 | 0.78 s | 76.9 token/s | 11.31 s | 5/6 |
| 退避修复 A | 1 | 0.72 s | 83.8 token/s | 17.03 s | 5/6 |
| 退避修复 B | 0.5 | 0.77 s | 97.4 token/s | 10.58 s | 3/6 |
| 退避修复 B | 1 | 0.70 s | 97.7 token/s | 7.69 s | 5/6 |
每行来自三次启动、每次两轮,共六个请求。区间合并的 12 份输出逐字相同,均为 160 token,全部通过 67 项检查。分工从 0.5 改为 1 后,该任务的 CPU 等效占用中位数从 5.26 核降到 1.70 核;日志汇总从 5.60 核降到 1.00 核。GPU 承担更多专家计算,为主机上的应用与工具执行留出了 CPU。
等待时间还受到缓存和输出长度影响。区间合并首轮的显存命中比例为 74.2%–74.6%,第二轮提高到 90.1%–94.3%。重复后,需要 CPU 或 PCIe 处理的路由减少,两种分工的影响也随之变化。
修复 A 在参数 1 下生成更快,E2E 却更长:输出 token 中位数从约 775 增到 1281。修复 B 的输出中位数则从 981 降到 608。因此,本文同时记录 decode 吞吐、完整等待和通过数;三者分别描述生成速度、使用体验和功能结果。
生成更快以后,为什么还有代码没修好
先前固定 pcie_frac=0.5,对同两份退避修复历史比较过 1024 与 2048 输出上限:
| 输出上限 | 请求数 | 自然结束 | 完整通过 | 截断 |
|---|---|---|---|---|
| 1024 token | 8 | 5 | 4 | 3 |
| 2048 token | 8 | 8 | 4 | 0 |
增加预算后,八份回答都自然结束,通过数仍为四份。失败可以发生在很具体的地方:一份代码在外层 for i in range(attempts) 中又嵌入同样的循环,每轮重复追加整段结果。输入 (5, 0.5, 4) 时,预期五项被重复五遍,返回长度变成 25;10000 次用例触发 MemoryError。完整失败回答与测试
同轮另一份代码在计算每一项时逐步翻倍,达到 cap 就结束这一项的乘法循环,再继续追加后续项。同一输入得到 [0.5, 1, 2, 4, 4],10000 次用例及其余边界检查也全部通过。完整成功回答 · 测试结果
前节的 48 请求对照统一采用 2048 上限,两种分工各有 12 次修复:0.5 组通过 8/12,1 组通过 10/12,各有两次截断。结合较低的主机 CPU 占用,后续编码测试固定使用 PLE RAM、pcie_frac=1、prefill 2048、尾部跳过关闭。
退避修复已经暴露了两类失败:预算用尽时,代码被截断;自然结束时,代码仍可能有循环和边界错误。接下来用公开题集记录更多任务的通过率和完整等待。
HumanEval+:写一个函数,通常等几秒
第一组公开题集使用 HumanEval 的全部 164 道 Python 函数题。模型收到函数签名、题目说明和示例,每题生成一份答案,之后由 EvalPlus 分别执行原版测试和 HumanEval+ 增强测试。固定版本评测说明
| 指标 | 本次实测 |
|---|---|
| HumanEval pass@1 | 161/164,98.17% |
| HumanEval+ pass@1 | 156/164,95.12% |
| 整套生成墙钟时间 | 10 分 37.2 秒 |
| 单题生成 E2E 中位数 / P95 | 3.17 / 7.52 s |
| TTFT 中位数 / P95 | 0.50 / 1.29 s |
| 后处理与评分 | 另计 50.9 s |
| 自然结束 / 截断 | 164 / 0 |
本轮每题一次、输出上限 4096,不追加修复。pass@1 按每题全部对应测试通过计分。HumanEval+ 的八道失败都已自然结束;其中五道通过原版测试,在新增测试中失败。
这批函数题通常几秒就能生成一份实现。八份 HumanEval+ 失败答案都已经写完,接下来需要修正测试暴露的逻辑和边界问题。
日常编码还经常需要修改已有文件:读懂接口、按格式写回,再根据测试报错修复。下一组把这些步骤交给 Aider,计时也覆盖完整任务。
Aider Polyglot:改文件并修复一次,通过了多少题
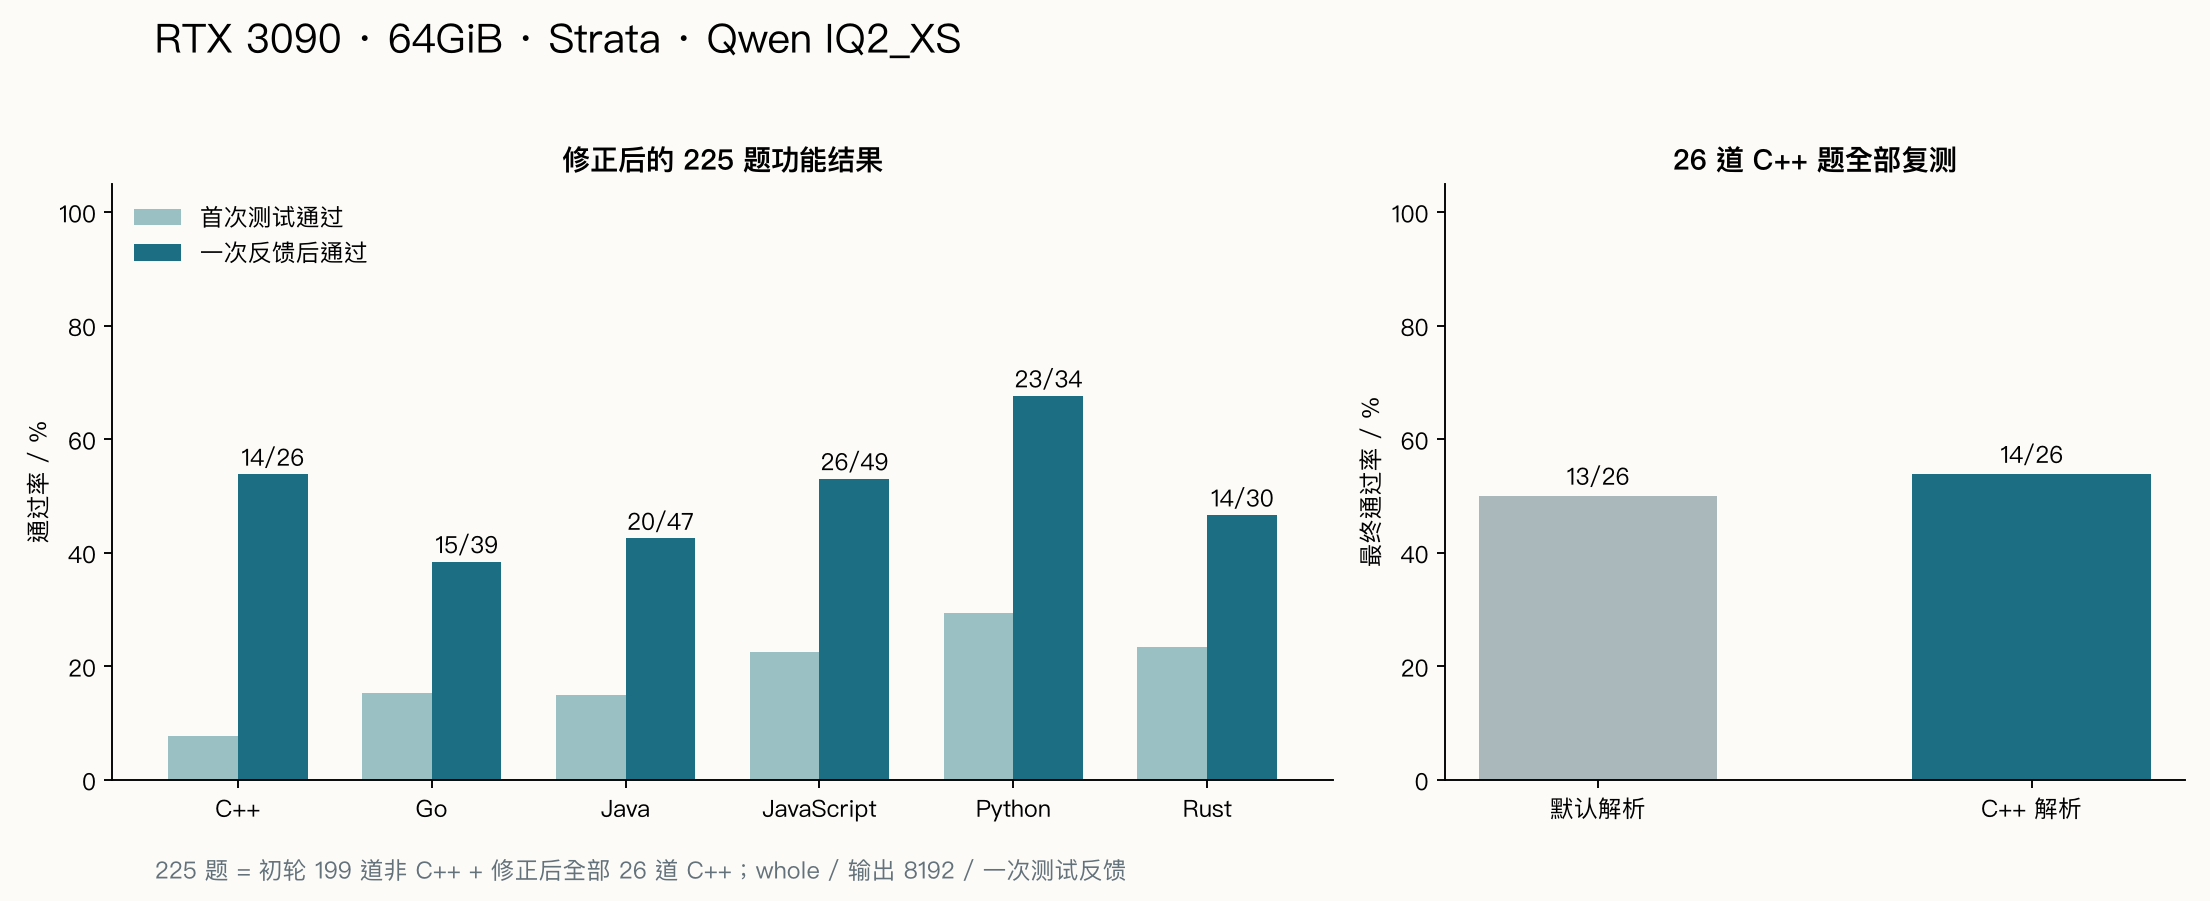
第二组使用 Aider Polyglot 的全部 225 道任务,覆盖 C++、Go、Java、JavaScript、Python、Rust。Aider 读取说明和可编辑源文件,模型输出完整修改文件,随后编译并运行验收测试。首次测试失败,就把错误反馈给模型,再修复一次。
Aider 的语法检查、编辑格式纠错和对话摘要也会调用模型。因此,“首次测试通过”可能已经经过内部纠错;“一次测试反馈”对应两次验收机会。每题 E2E 从任务开始计到结束,包含生成、摘要、修改应用、编译与测试。本轮单次输出上限为 8192。
完整初轮运行 4 小时 30 分 36 秒,首次通过 43/225,最终通过 111/225。检查日志发现,Aider 把 C++ 的 .h 头文件交给了 C 语法解析器,触发大量额外纠错。修正检查器后,全部 26 道 C++ 重跑一遍,另用 22 分 58 秒,具体过程放在下一节。
下表采用 199 道初轮非 C++ + 全部 26 道修正复测 C++ 汇总,包含复测中的新增通过与退步。
| 语言 | 题数 | 首次测试通过 | 一次反馈后通过 | E2E 中位数 | P95 |
|---|---|---|---|---|---|
| C++ | 26 | 2 | 14(53.8%) | 49.6 s | 82.5 s |
| Go | 39 | 6 | 15(38.5%) | 33.2 s | 209.1 s |
| Java | 47 | 7 | 20(42.6%) | 67.6 s | 157.7 s |
| JavaScript | 49 | 11 | 26(53.1%) | 47.5 s | 102.4 s |
| Python | 34 | 10 | 23(67.6%) | 41.3 s | 138.7 s |
| Rust | 30 | 7 | 14(46.7%) | 40.7 s | 181.3 s |
| 全部 | 225 | 43(19.11%) | 112(49.78%) | 47.5 s | 147.0 s |
一次测试反馈额外挽回了 69 题。例如 Python REST API 题,首次混淆 JSON 文本与 Python 对象,反馈后补上输入解析和输出序列化,52.1 秒完成并通过。JavaScript REST API 题则首次通过,用时 22.7 秒。
逐题汇总的 E2E 合计为 227.38 分钟,其中模型调用 185.92 分钟(81.8%)、编译测试 40.69 分钟(17.9%),其余为客户端处理。这是两轮逐题时间的累计;完整运行的墙钟分别按上面的初轮与专项记录。
C++ 的 250 次调用,怎样降到了 72 次
初轮 C++ 的不少任务会连续收到语法错误提示。检查 Aider 使用的语言映射发现,.h 被识别为 C,而这些题目使用的是 C++ 头文件。语法检查器把类、命名空间等内容标成错误,模型收到反馈后继续尝试修改。
用官方参考答案验证,26 份头文件都已通过真实编译和验收,却全部被 C 语法检查报错。将 .h 映射为 C++ 后,26 份头文件全部通过 lint;故意构造的错误 C++ 仍能被检出。固定版本语法检查实现
只修改这项语言映射,保留模型、预算和测试规则,全部 26 题按原相对顺序复测:
| 指标 | 默认头文件解析 | 按 C++ 解析 |
|---|---|---|
| 模型调用数 | 250 | 72 |
| 26 题 E2E 合计 | 66.16 min | 22.97 min |
| 单题 E2E 中位数 | 156.7 s | 49.6 s |
| 最终通过 | 13/26 | 14/26 |
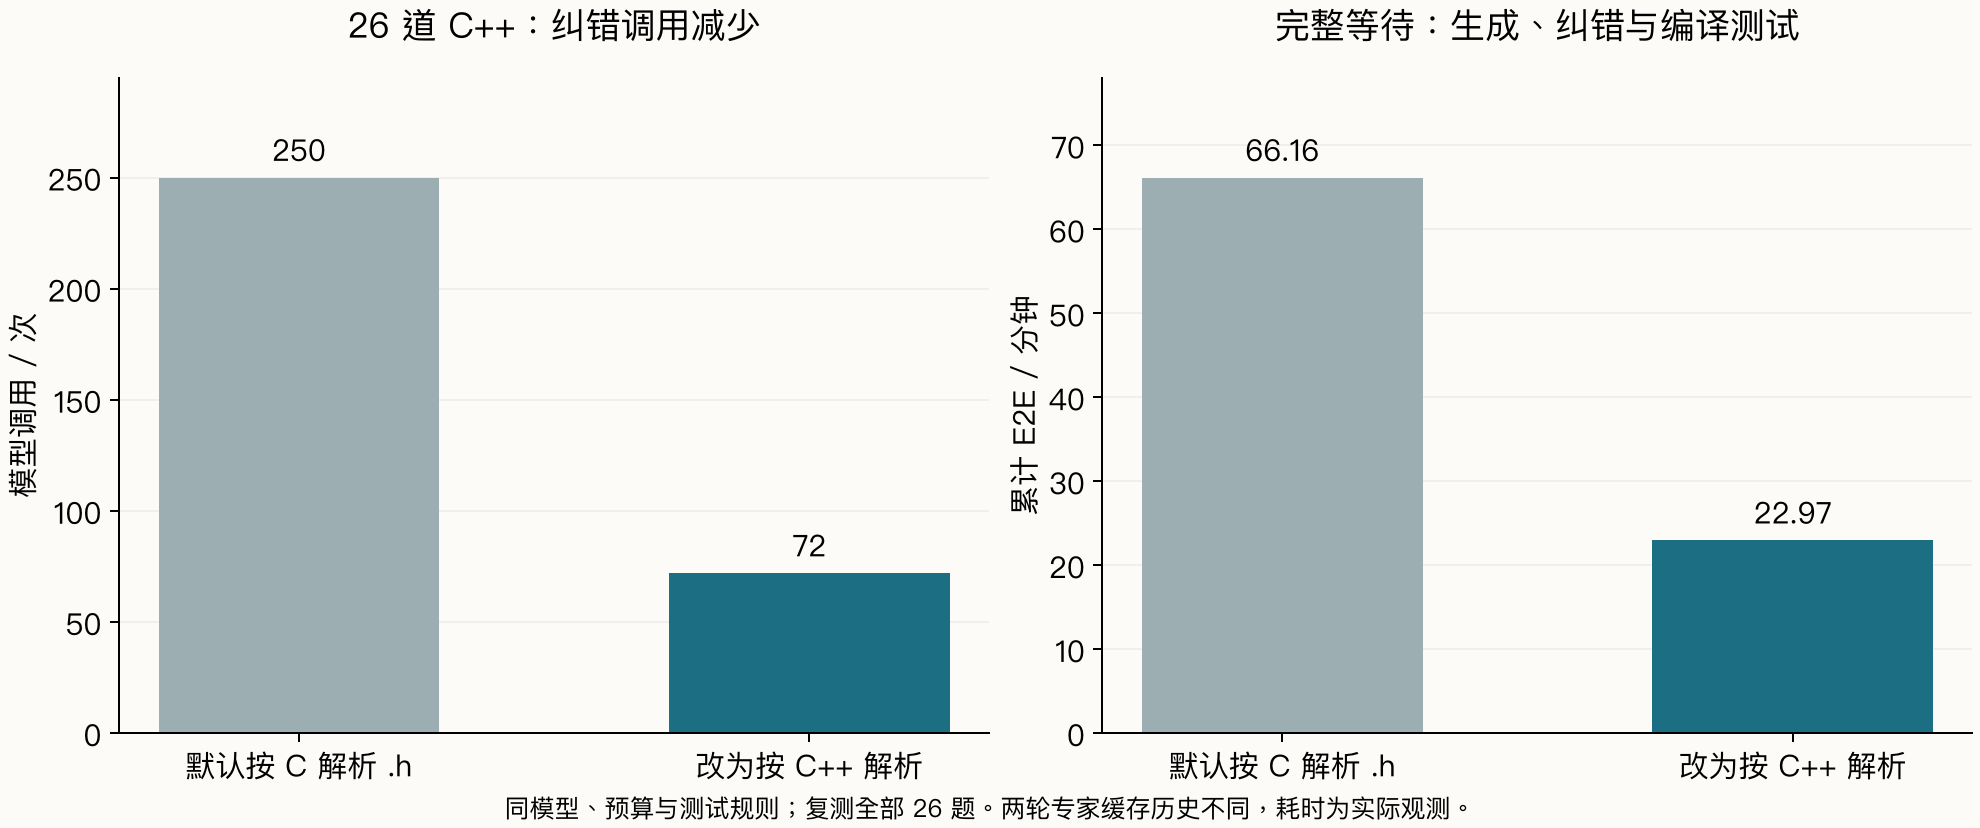
比如 space-age,两轮都最终通过,调用数从 11 次降到 3 次,E2E 从 237.8 秒降到 58.2 秒。crypto-square 也保持通过,调用数从 10 次降到 3 次,E2E 从 242.9 秒降到 47.8 秒。
复测新增通过 diamond、all-your-base、gigasecond,同时 circular-buffer、bank-account 从通过变为失败,净增加一题。工作流的主要变化是少了大量纠错调用。注意:两轮的专家缓存历史不同,耗时包含这一条件差异。
磁盘等待消失后,还会卡在哪里
Polyglot 初轮 798 次模型调用期间,引擎累计读盘 96KiB,major fault 为 1;采用修正 C++ 结果后的 620 次调用汇总中,两项均为零。这里测量的是每次调用前后引擎进程的计数差值,范围覆盖模型请求;加载阶段和编译器的文件访问另计。
读盘量降下来以后,下面几道题把剩余等待表现得很清楚。
输出很长,任务仍未通过。 JavaScript scale-generator 两次调用都生成满 8192 token,整题耗时 173.6 秒,最终未通过。第二次调用的 decode 为 107.3 token/s、请求期零读盘,输出中反复解释音名转换。生成速度足够快,重复内容仍会消耗预算和时间。
测试反馈占满上下文。 Go paasio 的并发读写计数出现丢失,随后的大量一致性检查报错生成约 933KiB 日志。Aider 把反馈交回模型时,输入达到 415070 token,引擎按 32K 上限拒绝请求。这道题既有初始实现的并发错误,也有修复阶段的反馈长度问题。
工具执行与历史压缩也需要时间。 初轮单独统计的对话摘要约 45.05 分钟;汇总后的编译测试约 40.69 分钟。完整任务时间包含这些操作,生成吞吐只是其中一个环节。
定位这类等待时,先用 Aider 的逐题记录拆出模型调用、摘要和编译测试,再用引擎日志核对输出长度、结束原因及请求期读盘。重复输出对应生成预算,超长报错对应反馈处理,额外纠错对应工具配置。GPU 计算与 PCIe 搬运的完整时间占比,仍需兼容的采集器补测。
与 GPT-6、Claude 相比,等待和费用怎样取舍
Polyglot:同一套文件编辑题
先看同一套 Aider Polyglot 225 题。下表把完成率与时间放在一起:逐题累计记录工具处理任务的耗时,整轮墙钟还包含任务之间的调度等开销。本文本地结果来自 199 道初轮题目与 26 道 C++ 复测的汇总。
| 模型与设置 | 首次通过 | 修复后通过 | 逐题累计处理时间 | 整轮墙钟时间 | 该轮费用 |
|---|---|---|---|---|---|
| 本文 Qwen IQ2_XS / 3090,推理关闭 | 43/225(19.11%) | 112/225(49.78%) | 3 h 47 min 23 s | 初轮 4 h 30 min 36 s;C++ 专项另计 22 min 58 s | 本地运行;电费、硬件摊销待测 |
| GPT-6 Sol,medium | 126/225(56.0%) | 199/225(88.4%) | 46 min 42 s | 51 min 56 s | 作者未公开 |
| GPT-6 Luna,medium | 85/225(37.8%) | 173/225(76.9%) | 1 h 9 min 55 s | 1 h 15 min 11 s | 作者未公开 |
GPT-6 两行来自 ORGAL 的 2026-09-23 实测。对方同样使用 whole 编辑、两次验收和单请求串行;模型开启 medium 推理,输入/输出预算和评分容器也更大,详细配置见文末。Sol 比本文本地多通过 87 题,Luna 多 61 题。对这套文件编辑任务,公开服务记录的完成率更高,整轮等待也更短;费用一栏等待作者补充账单或完整计费 token 记录。
Terminal-Bench:新版 Claude 的长任务参考
新版 Claude 的时间和费用参考采用另一套题集。Terminal-Bench 4.0 衡量长流程终端任务,覆盖软件、科学计算等领域;Vals AI 用 Mini-SWE-agent 跑 66 题、重复三轮,取通过率均值。下表采用其 2026-10-13 榜单,时间与费用均按单任务口径展示。实测与方法
| 模型 | 榜单通过率 | 单任务耗时(Duration) | 单任务 API 费用(美元) |
|---|---|---|---|
| Claude Opus 5.5* | 65.15% | 1 h 04 min | $13.20 |
| Claude Sonnet 5.5* | 64.14% | 1 h 22 min | $16.51 |
| GPT-6 Astra | 59.60% | 35 min 42 s | $9.58 |
| GPT-6 Sol | 44.44% | 34 min 56 s | $5.79 |
带星号的 Claude 两行含供应商回退:Opus 有 22/198 次尝试由旧版服务,Sonnet 有 4/198 次。将这些尝试全部计失败,通过率分别为 58.08% 和 62.63%。费用包含这些实际运行。回退记录
在这次长任务测试中,Sonnet 的每题费用高于 Opus,说明任务最终花费还取决于模型走了多少轮、生成多少内容。选服务时,把完成率、任务等待和实际费用一起记录,才容易判断它适合接手哪类工作。
本文 Qwen 尚未运行 Terminal-Bench。选个人编码工具时,可以先用 Polyglot 观察小文件修改与报错修复,再用长任务测试观察持续执行能力;本地与云服务的直接复测沿用同一套工具和预算。
注意:Terminal-Bench 时间沿用榜单 Duration,表示任务完成墙钟;页面未说明该列采用均值还是中位数。费用为 API 使用成本,运行环境另计。指标定义
这台机器适合接手哪些编码工作
这台 64GiB / 3090 已有一套可继续使用的配置:PLE RAM、prefill 2048、pcie_frac=1、tail skip=0。数据驻留后,请求期读盘接近零;更多专家交给 GPU 计算,也给编译和其他工具留出了 CPU。按本轮结果,个人使用可以从以下任务开始:
| 工作 | 本轮依据 | 使用方式 |
|---|---|---|
| 写一个边界明确的 Python 函数 | HumanEval+ 156/164;生成中位数 3.17 s | 提供签名、输入输出和边界例子,生成后运行测试 |
| 修改已有小文件 | Polyglot 最终112/225;E2E中位数47.5 s | 提供相关接口,检查修改差异,以验收测试决定是否采用 |
| 根据报错修复 | 一次反馈额外挽回69题 | 回传最相关的错误与失败用例,修复后执行回归测试 |
| 跨文件检索、依赖升级、持续多轮开发 | 本轮尚未测试 | 下一步用自己的小仓库任务验证 |
本轮函数题使用 4096 输出上限,Aider 使用 8192。32K 总上下文预留 8192 输出后,输入预算为 24576 token,系统提示、文件内容、历史和测试反馈共同使用这部分空间。回传报错时,保留相关接口、失败用例和关键错误;完整长日志另存文件,按需读取。
本文会让这台机器先完成一个函数或一处局部修改,运行测试后再决定是否继续修复。遇到重复输出,就收缩任务;遇到大段报错,就整理反馈。内存常驻已经解决了这一轮最明显的 I/O 等待,接下来改善个人编码体验,更值得投入的地方是任务拆分、工具配置和测试反馈。
注:环境、计时和复现
横向参考查询于 2026-10-15。GPT-6 Sol/Luna 数字来自评测作者的公开报告,本文尚未复跑该 API;对方使用 whole、tries=2、并行数 1、medium 推理、temperature=1、131072-token 输入和 65536-token 最大输出,评分容器为 16 CPU/12GiB。本文采用推理关闭、temperature=0、32K 总上下文、8192 最大输出和 4 CPU/6GiB 评分容器,另有同步摘要与 C++ lint 修正。GPT 的累计时间沿用作者 Aider duration,本地累计时间为逐题 E2E;整轮墙钟单列。
新版 Claude 参考采用 Vals AI Terminal-Bench 4.0 的独立实测,表中已标出供应商回退。该套题每题最多运行 8 小时,无步骤数和费用上限;通过率取三轮均值。榜单费用按美元/任务记录。两套题集分别展示;新版 Claude 的同协议 Polyglot 成绩与费用仍待补测。
硬件为 RTX 3090 24GiB、Xeon Gold 5318Y 虚拟机的16 vCPU,扩容后系统可见63.305GiB。Strata 0.1.43固定提交为
7695859aa13afb248bdb4d36f9b2e95707db079d,驱动580.126.09,构建包含sm_86;模型为Qwen3.8-Flash-Next-GSQ-RCO IQ2_XS。引擎使用18GiB/13432专家槽、7 workers、32K/int8 KV、MTP 4/minP 0.5,关闭尾部专家跳过和prompt/conversation缓存。固定分工与公开题集测试使用prefill CPU share=0,自适应专家缓存保持开启。正式请求在模型loaded后开始,加载与预热另计。
PLE 全表按页对齐后为 28800139264 字节,与系统
Mlocked观测一致;CUDA 锁页专家补集另行计量。容量实验保留操作系统文件缓存,自动分工校准在0.35–0.60间变化;每任务每组四次。0.5/1固定分工每任务每参数六次,来自三次启动。CPU等效占用为进程CPU秒数除以请求墙钟秒数;显存命中比例按显存命中路由数除以全部路由数计算,包含PCIe路由。HumanEval每题只提交首次答案,输出上限4096;生成结束后单独评分。EvalPlus提交
26d6d00bb1fd0fa37f39c99d5290da67891d1c5e,HumanEvalPlus v0.1.10。参考程序原版与增强测试均164/164通过。题集公开已久,训练数据重合和题集上限会影响跨模型解释。Aider提交
5dc9490bb35f9729ef2c95d00a19ccd30c26339c,Polyglot题库提交7e0611e77b54e2dea774cdc0aa00cf9f7ed6144f。采用whole完整文件编辑、最多两次验收,保留默认lint与格式纠错;摘要阈值2048 token,由同一本地模型同步完成。该同步安排保证请求串行、耗时归属明确,也属于复测协议的一部分。题序固定为seed 20261015的打乱顺序。公开题集使用temperature=0、top_p=0.95、reasoning_effort=none。P95采用线性插值,表示本轮不同题目的时间分布;固定seed后的输出仍可能变化,重复整轮可以观察波动。Polyglot的199+26统计是逐题汇总,原始完整轮次与C++专项墙钟分别保留。非流式Aider调用没有客户端TTFT记录。
Polyglot官方参考程序225/225通过;初轮657份、专项130份验收及构建文件核验通过。头文件修正后,参考lint审计还有C++预处理宏和Rust生命周期两处解析提示,两份参考实现均通过编译验收,其他默认lint行为在本轮保留。全部失败、上下文拒绝和复测退步均进入统计。
生成程序在无网络、非root、4 CPU/6GiB的容器中评分。所有模型输出与测试日志保留;早期自建评分器遗漏的OverflowError已修正并重评。内存/分工实验与两套公开题集各自保留原始记录、配置和统计口径。
独立Nsight诊断受到采集器2024.6与驱动接口兼容限制,CUDA事件仅覆盖请求前约3.2秒,完整请求约17.5秒;带采集的长输入另有停滞,根因待定位。诊断样本独立保存。本文没有给出完整GPU/PCIe等待占比。
本轮为单请求实测,尚未测试多人服务和真实仓库持续开发。本文尚未实测公共 API;本地电费、硬件摊销及同协议 API 账单保持待填。日常服务已恢复并完成健康及对话检查。
HumanEval逐题数据 · 重放协议 · HumanEval证据包
Polyglot逐题数据 · C++对照数据 · 重放协议 · Polyglot证据包