第一篇:在3090和32GB内存上试用 · 第二篇:专家缓存、CPU与GPU分工
前两篇完成了 Strata 的安装和机制分析。这次继续用同一台 RTX 3090 / 32GB 内存的机器,给 Qwen3.8-Flash-Next IQ2_XS 跑实际对话、代码生成,以及收到错误反馈后的代码修复,看看参数调整能换来多少等待时间的改善。
在 4K 输入样本(4392 token)上,优化前后的平均 TTFT(首 token 延迟)从 9.06 秒降至 3.37 秒,降低约 63%;平均 prefill 吞吐量从 486 token/s 提升至 1316 token/s,达到原来的约 2.7 倍。两项指标均取各配置两次测量的算术平均值。随后补做的 24 次隔离对照表明,长输入的主要收益来自更大的分块及对应的流式搬运;固定 256 时,CPU 分担开关的胜负随轮次变化。
代码任务按 decode 吞吐量统计:充分预热的短代码最高为 149.7 token/s,代码修复任务为 5.2–22.1 token/s。质量方面,前者通过全部功能测试,后者出现了输出截断和边界错误,具体结果见后文。
这些结果让后续方向变得具体:先用分块和线程分工改善当前机器,再围绕内存容量与随机读等待,争取让新任务也稳定地快起来。
这轮改了哪些设置,最后留下了什么
测试环境固定为 RTX 3090 24GB、16 vCPU、32GB RAM 的 Linux 虚拟机。模型、量化、32K 上下文、int8 KV 和单请求方式保持一致。10 月 13 日各组在模型加载后运行短预热,再开始计时;代码同时跑功能与边界测试。10 月 14 日的分块隔离对照改为完整输入预热,方法和结果单列。
本文的“代码修复任务”分两轮:先让模型实现指数退避函数,要求正确处理 10000 次重试;首次回答触发浮点溢出后,把真实的 OverflowError 回传,让它修复同一个函数。下表中的修复结果,指这第二轮回答。
| 调整 | 实测效果 | 最后取舍 |
|---|---|---|
| prefill 从 256 增到 2048 | 4K 输入两次确认的平均首字时间 9.06 → 3.37 秒;五个字段提取正确 | 保留 2048,并通过 17K 输入验证 |
| 专家工作线程从 15 减到 7,后台线程放到空闲 CPU | 7 个 worker 加主线程使用 CPU 0–7,后台使用 8–15;单项筛选的区间合并为 79.9 token/s | 采用这套分工继续测试;本轮只试了 15 和 7,最优线程数尚未确定 |
| MTP 从 4 增到 8 | 区间合并从候选关闭组的 71–74 降到 37–51 token/s | 保留 4 |
| 手动调整 PCIe 分配比例、MTP 门槛 | 热短题有高峰值,正反序扫描未找出稳定胜出的设置 | PCIe 自动,门槛保留 0.5 |
| 强制 PLE direct I/O | 本机随机读探测约 2MB/s;筛选任务比已预热 mmap 路径慢 | 保留自动选择 mmap |
| 默认尾部跳过与关闭对照 | 同一份合并代码,默认 90–106、关闭 71–74 token/s;收到溢出反馈后的修复,关闭组通过 1/2、默认组通过 0/2 | 日常候选关闭跳过,默认策略保留作速度对照 |
按上下文长度动态分配 KV:--kv-grow |
本版本要求全部专家在 RAM;当前 --resident-experts 只保留专家补集,引擎关闭了此功能 |
保留现有 KV 分配方式;这项开关未产生效果 |
这里的 63% 来自原配置和候选配置各两次确认的平均值。单独调整分块的筛选也得到相同方向的改善,下面展开它们的工作方式与成本。
本文按请求时间对齐观测:请求前后读取进程 CPU、实际读盘和 major fault 计数,运行中每 2 秒记录 GPU 与内存,最后关联引擎的 prefill、decode、专家缓存和草稿统计。各节分别给出这层的检查办法和本次判断。采集方法与字段说明列出实际命令及记录位置;下文的观测摘录由已有结果提取。
分块从 256 增到 2048,先省下长输入的等待
--prefill 设置一次处理的输入 token 数;这里仍然一次只处理一个请求。长输入按块处理,每层把使用同一专家的 token 聚在一起,重复利用已搬入的权重。增大分块,可以让一次权重搬运服务更多 token,也需要更大的激活和搬运缓冲。
1024 token 切换的是哪条路径
在本次单卡 CUDA、默认 CPU 分担策略下,当前块小于 1024 token 时,走路由后按需调度的路径;达到 1024 token 时,进入预先搬运专家的流式路径。判断的是当前块的实际 token 数:--prefill 2048 设置了块大小上限,输入末尾不足 1024-token 的块仍可能走小块路径。这个阈值是该版本的调度设置。阈值与默认条件
| 当前块的处理 | 小于 1024 token:先路由,再按需分工 | 达到 1024 token:预先流式搬运 |
|---|---|---|
| 如何决定搬哪些专家 | 先取回路由结果,统计每个专家服务多少 token;安排被选中的专家 | 按层、专家编号,提前列出全部未驻留 GPU 的专家并送入循环缓冲 |
| CPU 算什么 | 从未驻留 GPU、权重可在主机直接读取的专家中,优先挑选服务 token 较少的候选,交给 ExpertPool | 这条路径关闭上述 CPU 专家分担;CPU 继续做搬运提交、数据准备等主机工作 |
| GPU 算什么 | 显存中的专家,以及其他需要搬入的专家;与 CPU 专家计算重叠 | 被路由选中的专家均由 GPU 计算,驻留专家直接读取显存,其余从流式缓冲读取 |
| PCIe 上的取舍 | CPU 接手的专家省去权重 H2D 搬运,但需要传送输入激活和计算结果 | 可以提前搬下一批权重、与当前计算重叠;也可能搬到当前块没有选中的专家 |
小块路径会按路由计数挑选 CPU 候选:一个专家只服务少数 token 时,把整份权重搬到 GPU 的成本可能较高,CPU 可以直接读 RAM 里的权重计算。GPU 同时处理其他专家,最后等 CPU 结果回传后再合并。默认分担比例会依据测量调整,还会比较有、无 CPU 分担的层耗时;因此“小块允许 CPU 分担”不表示每层都固定分给 CPU 相同份额。候选选择与自动判断、CPU 结果回传
大块路径利用的是另一种条件:token 较多时,通常会覆盖更多专家,每份权重也能服务更多计算。源码提前枚举各层未驻留显存的专家,以固定顺序提交到循环缓冲。这样准备权重可以早于该层路由结果,复制下一批权重时,GPU 可以处理当前批次。计算仍按实际路由执行;预搬运范围更大,是换取流水线重叠的成本。流式分支与搬运序列
因此,256→2048 同时改变了每块 token 数、CPU/GPU 专家分工,以及权重搬运的调度方式。下面固定线程和模型,先测 CPU 分担开关,再比较更大的分块。这里的开关只控制 prefill 的专家分担,decode 继续使用自身的 CPU/GPU 策略。
固定 256 分块,关闭 CPU 分担会更快吗
10 月 14 日补做四组对照,输入仍是同一份 4392-token、120 条变更记录,要求提取五个指定字段。模型、7 个 worker、后台绑核、MTP 4、尾部跳过关闭、32K 上下文和 int8 KV 保持一致。
四组按“256 自动 → 256 关闭 → 1024 关闭 → 2048 关闭”运行,再反序重跑。每次重启引擎后,先用完整输入预热两次,再测三次,最终每个配置六次正式请求。全部关闭前缀缓存,日志确认每次都从头读取 4392 token。
| Prefill 分块 / CPU 分担 | 平均 TTFT(秒) | TTFT 范围(秒) | 平均 prefill 吞吐量(token/s) | 五字段全部正确 |
|---|---|---|---|---|
| 256 / 默认自动 | 13.28 | 11.67–14.91 | 335 | 6/6 |
| 256 / 关闭 | 16.11 | 11.72–26.14 | 292 | 6/6 |
| 1024 / 关闭 | 6.14 | 5.07–8.56 | 744 | 6/6 |
| 2048 / 关闭 | 3.54 | 3.40–3.64 | 1254 | 6/6 |
24 个正式请求都正常结束,五字段全部正确;进程 read_bytes 增量均为 0。这一轮观察的是数据已经预热后的计算与搬运,磁盘读取没有进入这些请求的计时区间。
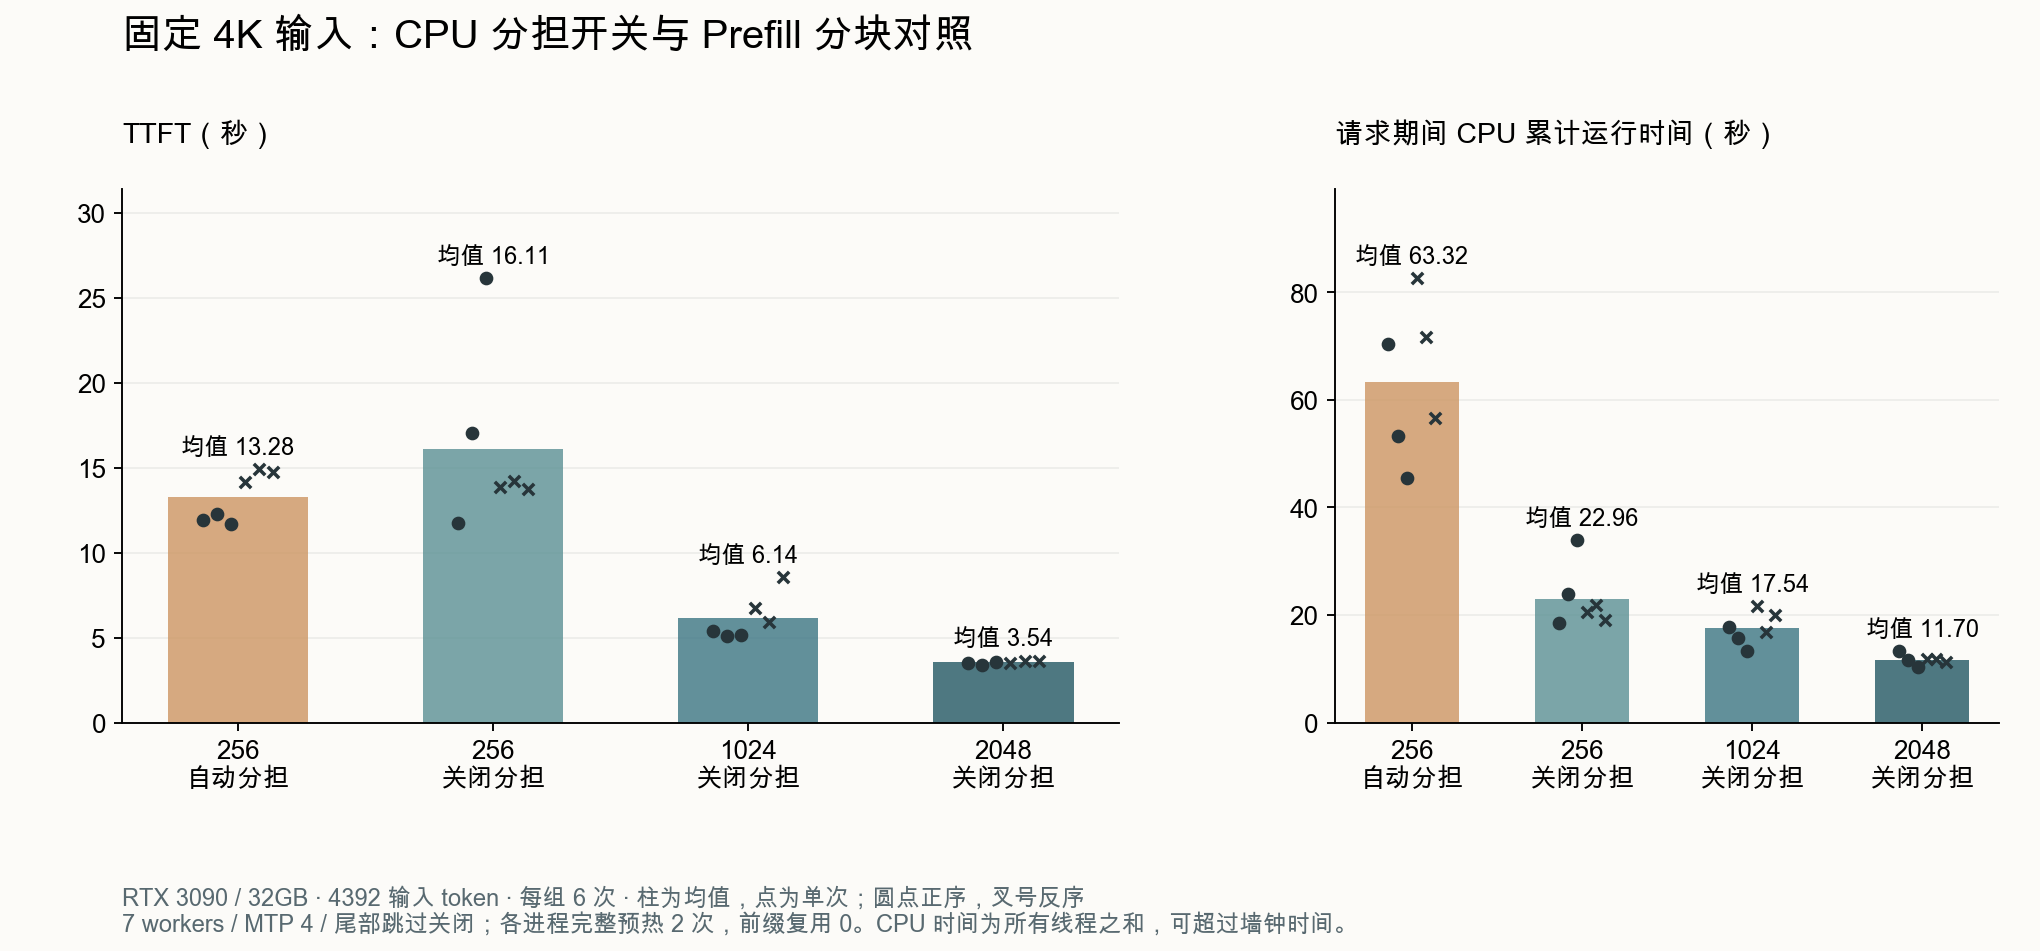
固定 256 时,CPU 分担开关没有稳定的胜出方向。 正序中,自动分担平均 11.95 秒,关闭为 18.29 秒;反序中,自动分担为 14.61 秒,关闭为 13.93 秒。关闭组正序还出现了一次 26.14 秒的长尾。两轮都保留在汇总中。
关闭分担确实减少了 CPU 用量:整个请求的 CPU 累计运行时间,平均从 63.32 CPU 秒降到 22.96 CPU 秒。这个计数相加了全部线程的运行时间,包含 prefill 与 decode;它说明 CPU 忙了多久。应用等待的 TTFT 则受到 GPU 专家计算、权重搬运及两边等待共同影响。
提速主要来自更大的分块和流式搬运
在 CPU 分担统一关闭后,256→1024 的平均 TTFT 从 16.11 秒降到 6.14 秒,减少约 62%;正序、反序都出现改善。这一步同时增大了批量,并从路由后按需搬运切换到预先流式搬运。
继续把 1024 增到 2048,平均 TTFT 从 6.14 秒降到 3.54 秒,再减少约 42%。这两组完整块都使用流式路径,末尾小块的 CPU 分担也统一关闭。更大的批量继续摊薄专家权重搬运和逐块调度的开销;2048 六次测量也集中在 3.40–3.64 秒。
这组结果支持把长输入优化的重点放在 分块大小及其对应的搬运流程。CPU 分担适合根据主机与负载保留自动测量,单独关闭它在本机没有带来稳定提速。256→1024 中批量与流式调度各自占多少,仍需固定块长、只切换流式阈值的额外对照;本轮测得的是这两项合在一起的收益。
本轮逐请求数据和完整复现附件保留正反序、预热、响应、配置、资源采样与五字段评分。
怎样观察 prefill 是否拖慢首字:先核对日志中的 prompt tokens / reused / read,再对齐客户端 TTFT 与引擎 prompt_ms。本轮 2048 组平均 prompt 时间为 3.505 秒、TTFT 为 3.542 秒;256 自动组分别为 13.249 秒和 13.281 秒。首字前的时间主要落在引擎 prompt 阶段。24 次正式请求全量读取输入、实际读盘增量为零,增大分块后这段时间明显缩短,说明当前热输入的 prefill 流程确有优化空间。要把时间继续拆到某个 kernel、复制或 event wait,需要 CUDA 时间线。
回看整套优化前后的指标
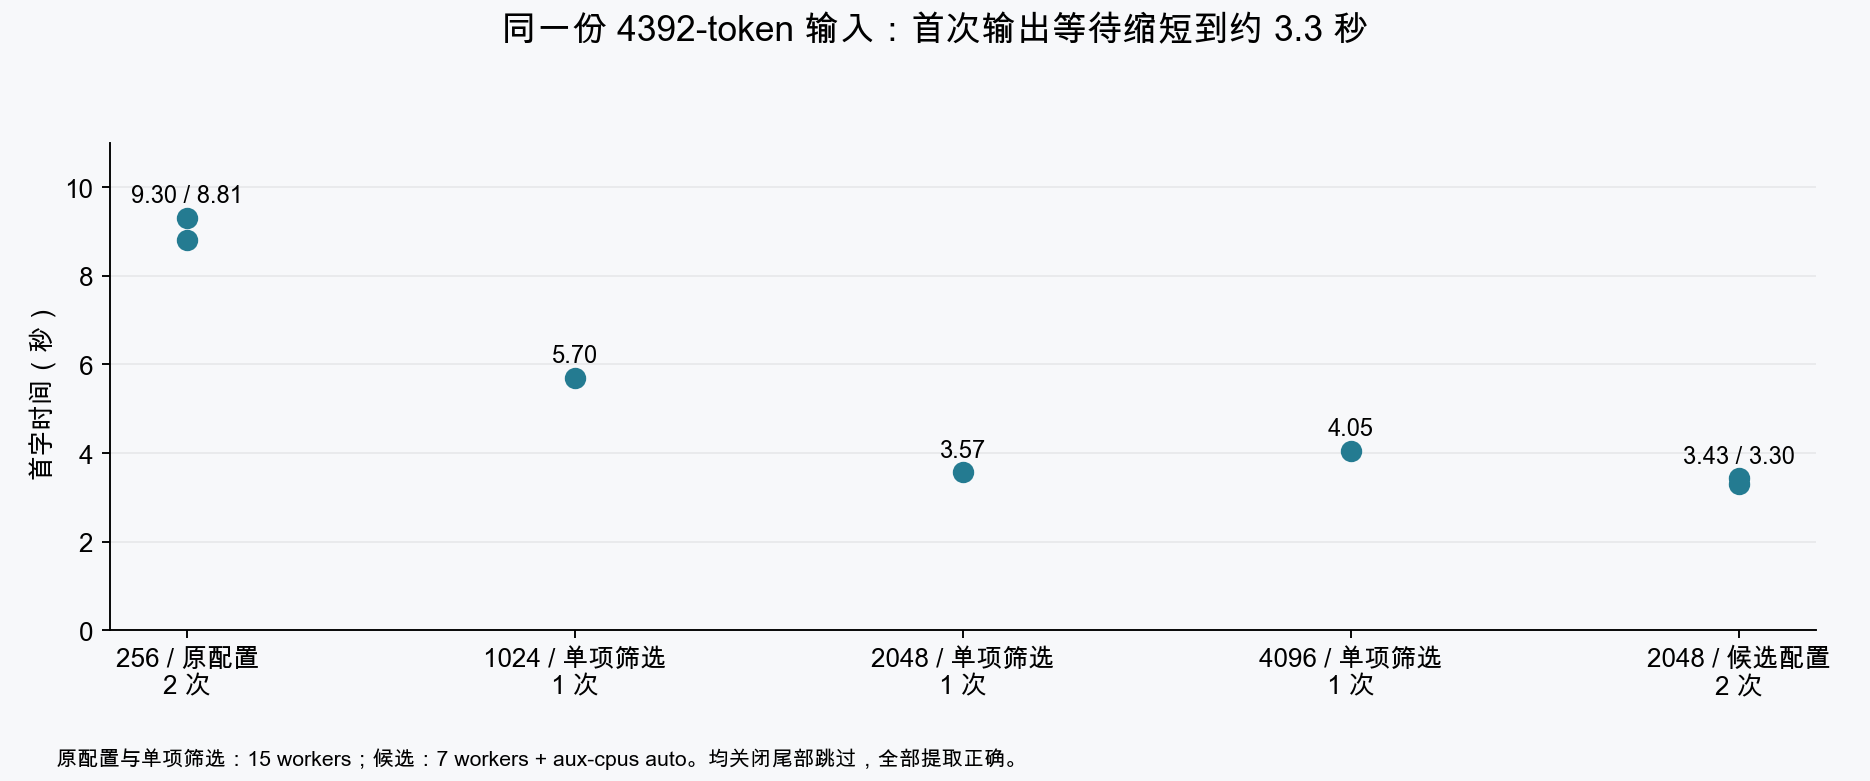
10 月 13 日先做了分块筛选,再比较原配置和候选配置。以下保留这轮结果;原配置使用 15 个 worker,候选使用 7 个,前缀缓存设置保持服务默认,与上面的隔离对照分别统计:
| 配置 | TTFT(秒) | Prefill 吞吐量(token/s) |
|---|---|---|
| 原配置,256,两次确认 | 9.30 / 8.81 秒 | 473 / 500 |
| 只改 1024,一次筛选 | 5.70 秒 | 774 |
| 只改 2048,一次筛选 | 3.57 秒 | 1240 |
| 只改 4096,一次筛选 | 4.05 秒 | 1091 |
| 候选配置 2048,两次确认 | 3.43 / 3.30 秒 | 1287 / 1344 |
分块增大后,显存怎样重新分配
四组启动日志中的专家缓存总分配都为 18.00GiB、13,432 个槽位。Prefill 的工作缓冲从这块空间里临时借用槽位,借出的槽位在处理输入时用来放缓冲数据;完成后回填原专家,再交给 decode 使用。
当前 --resident-experts 模式会在 RAM 中额外保留这些借出槽位对应的专家,以便 prefill 使用并在结束后回填。日志给出的分配如下:
| Prefill 分块 | 最大块规划借用的显存 / 槽位 | 借用后可保留专家的显存 / 槽位 | 固定在 RAM 的专家 | 全部加载后空闲显存 |
|---|---|---|---|---|
| 256 | 0.26GiB / 199 | 约 17.74GiB / 13,233 | 15.28GiB | 444MiB |
| 1024 | 0.72GiB / 537 | 约 17.28GiB / 12,895 | 15.74GiB | 444MiB |
| 2048 | 1.15GiB / 861 | 约 16.85GiB / 12,571 | 16.17GiB | 444MiB |
| 4096 | 2.03GiB / 1512 | 约 15.97GiB / 11,920 | 17.05GiB | 442MiB |
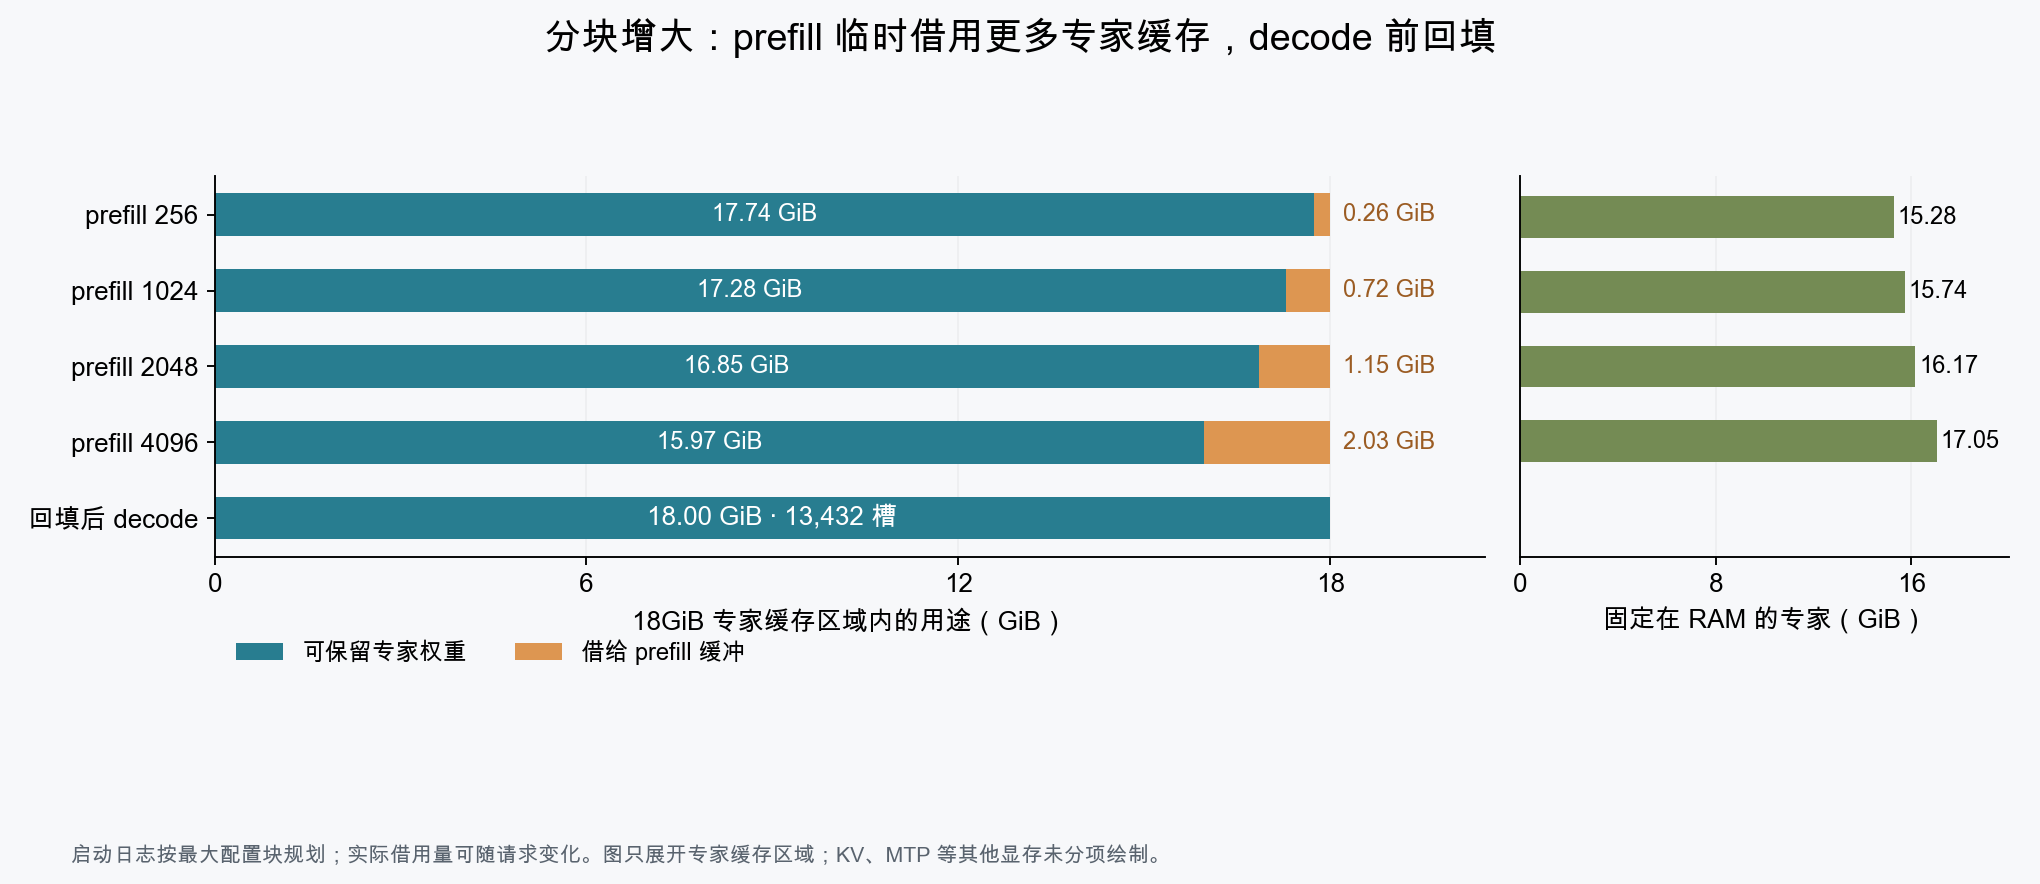
256→2048 的具体成本,是 prefill 多借约 0.89GiB 显存,RAM 中的专家副本也多约 0.89GiB。 借用期间,GPU 可保留的专家空间减少;回填结束后,decode 仍可使用完整的 18GiB 专家缓存。因此,分块变化影响 prefill 的专家驻留和回填工作,decode 的缓存容量保持原规模。RAM 副本与借用规划、回填与驻留表恢复
4096 相比 2048,又多借约 0.88GiB 显存,固定在 RAM 的专家也增加约 0.88GiB;本次 4K 样本的 TTFT 从 3.57 秒变成 4.05 秒。2048 在这次筛选中同时取得更低的 TTFT 和更小的缓冲、RAM 占用,因此保留它继续验证。
表中借用量按配置的最大块规划,实际请求可以借用更少;“借用后可保留专家的显存”按 18GiB 减去借用量估算。最后一列是模型和工作区全部加载后的空闲量,含 KV、MTP 等其他分配的影响;这些分配在现有日志中没有逐项计账。图只展开有明确记录的 18GiB 专家缓存区域。分配数据与日志来源
候选配置再用 17352-token、480 条记录验证:TTFT 42.16 秒,端到端延迟 42.98 秒,五个字段全部正确。返回结果带 JSON 代码围栏,调用方按 JSON 解析前需去掉围栏。
这次长输入读取约 272MB,prefill 吞吐量为 412 token/s。4K 与 17K 的输入访问了不同的数据范围,等待时间也随之变化。
怎样观察显存和专家缓存是否有压力:启动时核对 expert cache ... slots、prompt path borrows 和全部加载后的空闲显存;请求时再读 decode expert cache hit rate 与 blob reads from the file。本次 2048 留下约 444MiB 空闲显存,工作缓冲通过借用缓存获得空间,4K 和 17K 验证均完成。这里的主要取舍是 prefill 缓冲与专家驻留共享 18GiB,4096 多占空间却在筛选中更慢。
缓存命中还要和其他读取一起看。例如后文那次 61.29 秒的日志代码,decode 专家缓存命中率为 95.4%、专家文件读取为 0,进程仍读取 366.20MB。这条专家数据路径已经从 GPU/RAM 取得权重,剩余文件读取需要从 PLE 等数据继续追查。请求指标与日志索引
给后台线程留 CPU,MTP 保留 4
这台虚拟机有 16 个逻辑 CPU。原配置让 15 个工作线程加主线程共同计算专家。候选配置使用 7 个工作线程加主线程,把其余 CPU 留给后台工作;日志确认 --aux-cpus auto 将相关线程放到了逻辑 CPU 8–15。线程亲和说明
本轮只试了 15 和 7 个 worker,随后采用 7 个 worker 配合 aux-cpus auto 进行确认测试。选择它的目的是让专家计算使用 8 个逻辑 CPU(含主线程),把另外 8 个留给数据准备和其他后台工作。
7-worker 单项筛选的区间合并测到 79.9 token/s。其他线程数量尚未测试,而且现有轮次的页缓存和读盘量有差异,所以目前采用的是这套分工的试用配置,最优 worker 数量尚未确定。确定最优值,需要在相同数据准备条件下比较多个线程数,并分别检查后台绑核的影响。
MTP=8 的两次区间合并分别为 36.9、50.6 token/s,MTP=4 的候选关闭组为 74.1、71.2 token/s,四份代码逐字相同。整组草稿接受率分别为 65.9% 与 73.4%。更长的草稿增加了生成与验证工作,只有被接受的部分才能节省后续轮次;本轮据此保留 MTP=4。
线程分工和 MTP 都会与其他路径相互影响。后台线程需要及时准备数据,主线程需要推进调度,GPU 需要等待相应输入。当前筛选结果支持继续使用这组候选参数,后续在减少存储等待后,可以更清楚地比较它们的计算收益。
怎样观察 CPU 分工是否有效:先用启动日志核对 participating threads、worker/host 的逻辑 CPU 和 strata aux cpus,再比较同题的 CPU 累计时间与请求延迟。本次日志记录 8 个参与计算线程,主线程在 CPU 0、worker 在 1–7,后台线程分配到 8–15。256 分块的开关对照中,CPU 累计时间为 63.32 / 22.96 CPU 秒,TTFT 却未随 CPU 用量降低而稳定改善。分工设置已生效;线程排队、主线程调度和 stager 等待各占多少,仍需逐线程调度记录定位。
怎样观察 MTP 是否划算:同题同时检查 draft_n_accepted / draft_n、decode 用时、输出长度、读盘和验收结果。本次 MTP=4 的确认组累计接受 2974/4052 个草稿 token,MTP=8 为 3304/5012,对应 73.4% / 65.9%(各 16 个正式请求,含代码修复)。结合前面的同输出代码对照,本次加长草稿没有带来速度收益,保留 4。该组包含不同答案与 I/O 状态,数字反映整组运行效果。
kv-grow 为什么没有启用
--kv-grow 让 KV 状态按实际到达的上下文长度占用显存,尚未使用的空间先交给专家缓存;上下文增长时,专家缓存再让出空间。本版本为这条路径设置了一个条件:所有专家在系统内存中都有可用副本,这样 GPU 让出任意专家槽位后,CPU 仍能处理对应专家。
这台 32GB 机器使用 --resident-experts:RAM 主要保留 GPU 没有驻留的专家,以及 prefill 借用区域的备份。它满足当前低内存运行方式,但不满足 kv-grow 的全专家 RAM 条件。源码明确排除了这两种模式的组合,测试日志也输出 --kv-grow is off。所以这项试验实际仍使用原来的 KV 分配方式。启用条件
这一层的观测结论:日志明确给出 --kv-grow is off,本次没有进入动态增长路径。当前看到的是功能启用条件未满足;KV 增长过程的显存压力,需要在满足条件的运行方式下另测。
GPU 和 PCIe 忙在哪里,现有数据能看到什么
GPU 活跃、PCIe 有流量,都需要放回同一个请求时间段里看。本文用 nvidia-smi 每 2 秒记录 GPU 利用率、功率、温度与时钟;10 月 14 日反序四组另加每秒一次的 PCIe 收发活动采样。以下是实际记录:
| 观察项 | 本次数据 | 这一层的判断 |
|---|---|---|
| 慢代码期间 GPU 活动 | 日志代码耗时 61.29 秒,GPU 利用率采样均值 97.7%,平均功率 173.7W;同期读盘 366.20MB | GPU 持续活跃,同时存在数据读取;具体等待落在计算、复制还是同步上,需 CUDA trace 定位 |
| 启动 PCIe H2D 校准 | 分块对照八次启动为 3.8–22.8GB/s,各次取四次探测中的最好值 | 启动校准存在明显波动,用于引擎初始分配;请求中的链路饱和情况需要同期复制字节量与耗时 |
| 请求期间 PCIe 活动 | 反序组保存 rxpci / txpci 的每秒采样,和请求 Unix 时间对齐 |
已记录链路活动;完整 H2D 时长、排队及与 kernel 的重叠比例尚未采集 |
例如,1024 正序启动探测为 3.8GB/s、反序为 14.5GB/s,对应三次 TTFT 均值却是 5.20 秒 / 7.07 秒。这些是两个不同阶段的测量。排查某个慢请求时,要把它自己的复制、计算和等待串起来,启动探测适合检查环境和校准过程。八次启动探测与原日志索引
目前已经看到分块和搬运流程的组合收益;PCIe 带宽饱和、GPU 计算饱和均保留为待定位项。下一步细化观测应记录 H2D memcpy、kernel、event wait 的实际起止时间,并检查哪段等待决定了请求完成时间。
读盘减少以后,同一道题快了多少
先对尾部专家跳过,按“关闭 → 默认 → 默认 → 关闭”运行四组,每组重启引擎,并运行相同七个任务。结果如下:
| 运行顺序 | 七个请求总耗时 | 请求期间进程实际读取 |
|---|---|---|
| 关闭 A | 425.8 秒 | 2.60 GB |
| 默认 A | 242.4 秒 | 1.74 GB |
| 默认 B | 90.1 秒 | 0.46 GB |
| 关闭 B | 59.4 秒 | 0.23 GB |
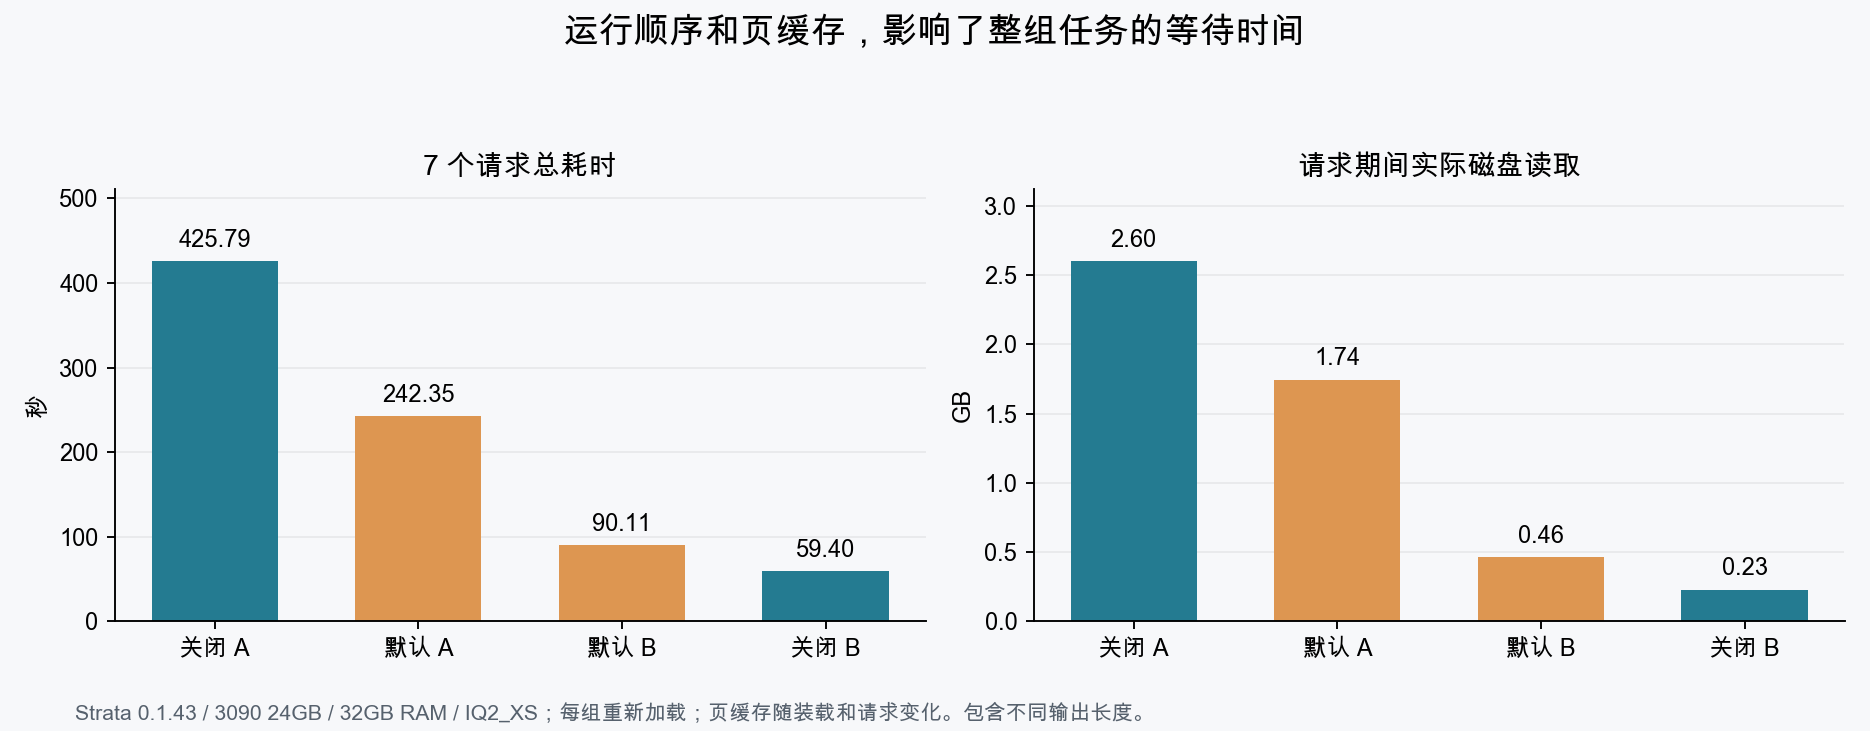
同一道区间合并题,四组输出逐字相同,耗时从 66.3 秒逐步降到 2.7 秒,进程读取量从约 345MB 降到约 2MB。读取减少与等待缩短同时出现,存储和缓存状态成为这台机器的重要优化方向。模型加载和运行都会改变页缓存状态;重启引擎之后,请求遇到的数据位置仍会不同。
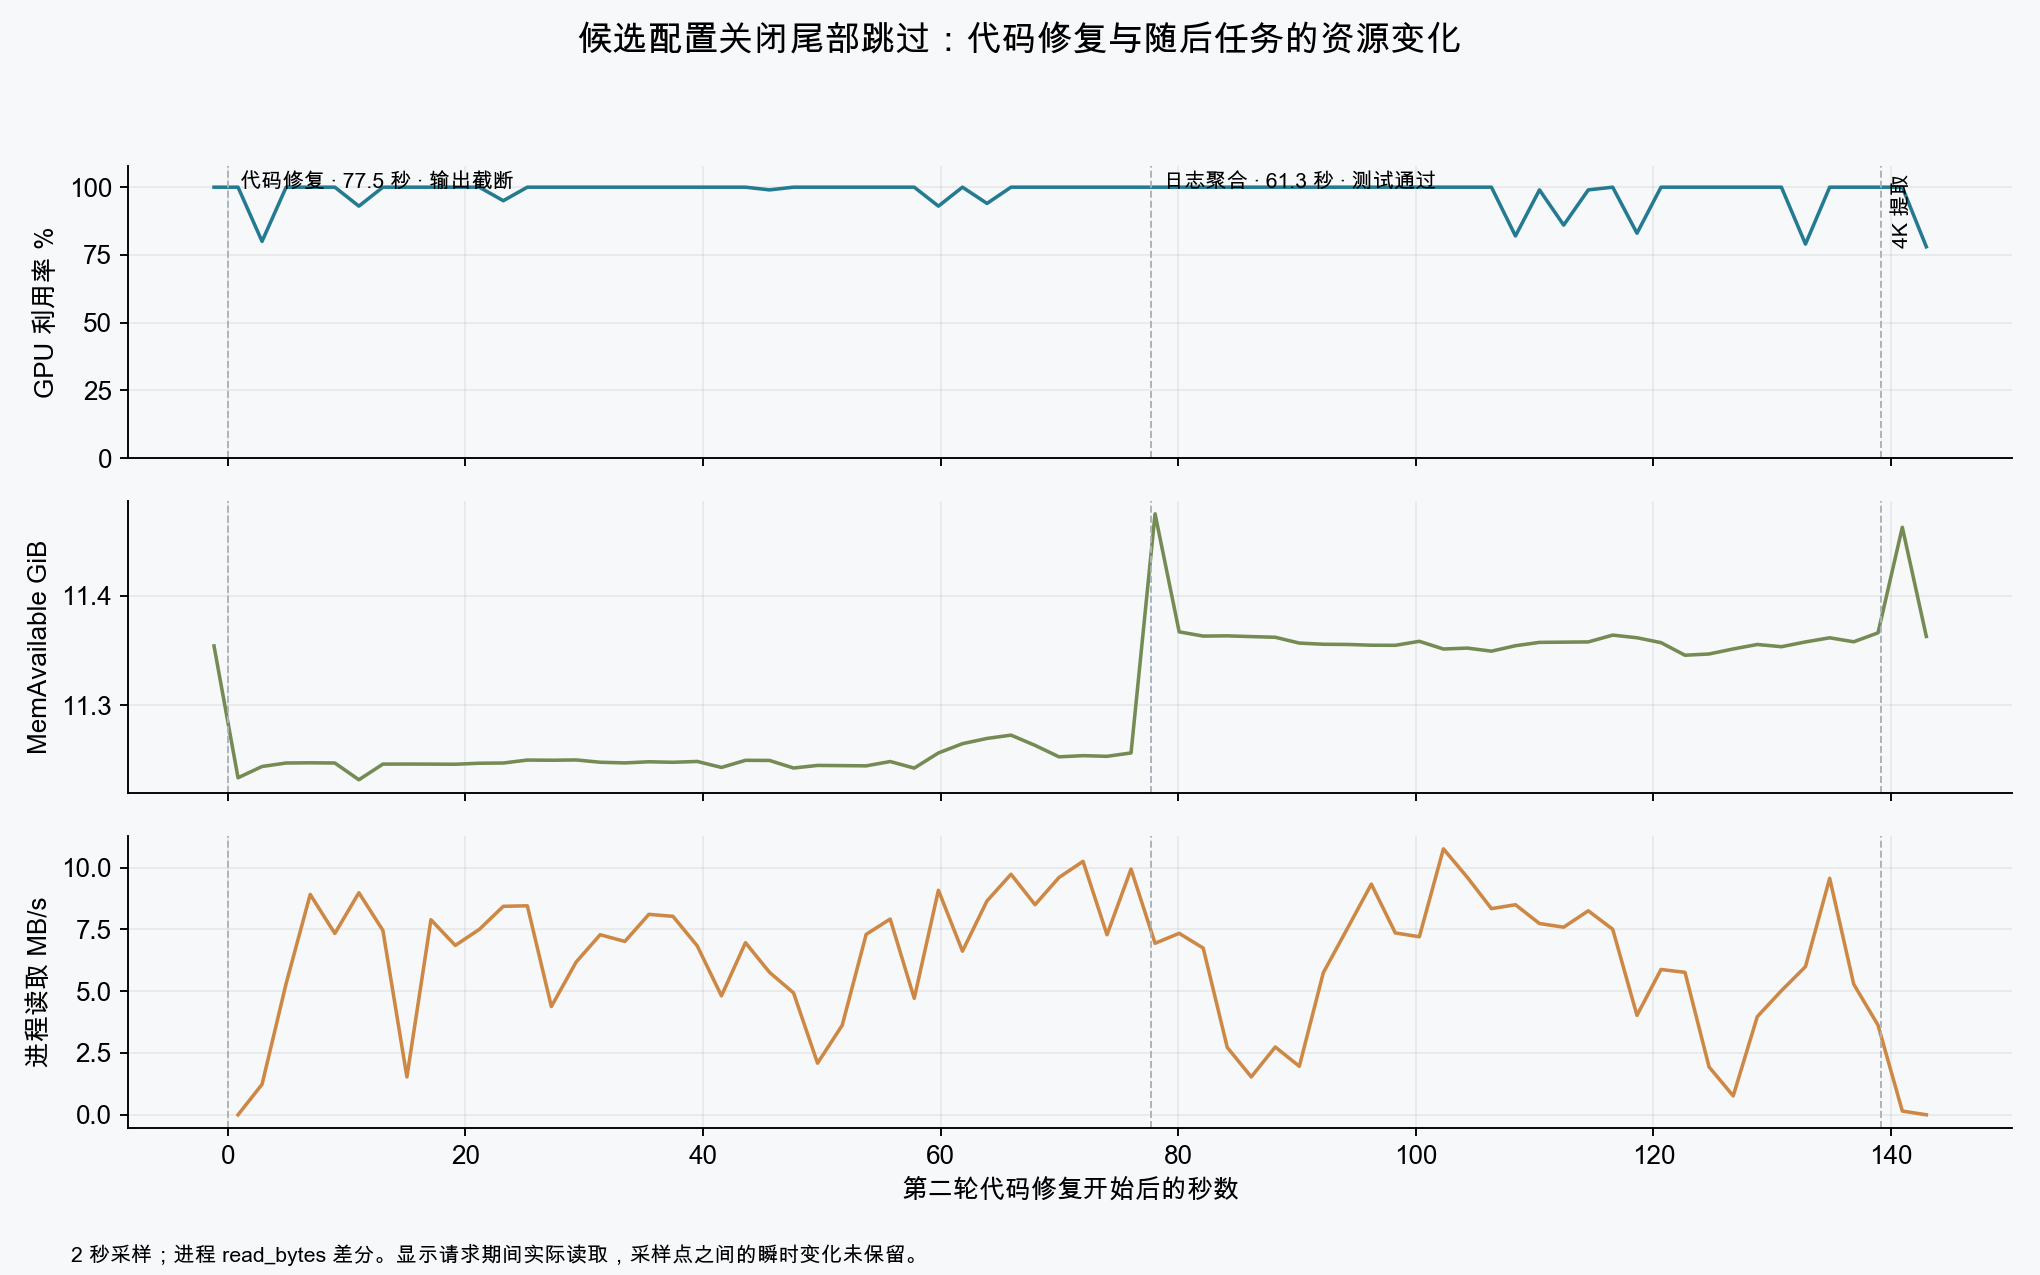
图中候选配置关闭跳过的第二轮修复读了约 533MB,随后日志聚合又读了约 366MB。后一份代码通过测试,但 751-token 输出仍用了 61.3 秒。这些区间的 GPU 利用率采样多处接近 100%,进程仍持续读取存储;判断等待需要把这些指标与请求时间一起看。
这份模型还有约 28.8GB 的 PLE n-gram 表。当前模式在 RAM 中固定了约 16.17GiB 的专家补集,PLE 走 mmap,由操作系统缓存访问过的页。32GB RAM 需要在运行数据与文件缓存之间分配空间。模型数据布局
相关请求的日志记录专家 blob 文件读取为零,而进程仍有实际存储读取;结合 PLE 的 mmap 路径,证据主要指向 PLE 表与文件页缓存。逐文件 I/O 归因是下一步验证内容。
mmap 让访问过的数据页留在系统缓存里。新任务访问其他页时,需要由存储补齐;内存空间也会影响这些页能保留多久。本机 direct 路径的随机读探测约 2MB/s,最终配置保留引擎自动选择的 mmap 路径。对这种零散读取,关键指标包括每次读的等待和同时在途的请求数,顺序读带宽只能描述另一类负载。
怎样观察 RAM 与磁盘是否影响请求:在请求前后读取 /proc/PID/io 的 read_bytes 和 /proc/PID/stat 的 majflt,并用同时间段的 /proc/meminfo 检查可用内存。read_bytes 描述实际存储读取量,major fault 描述需要存储取页的缺页事件;再把它们同耗时关联。
| 已记录的请求 | 完整耗时 | 实际读盘 | Major fault 增量 | 请求期间可用 RAM 最低采样值 |
|---|---|---|---|---|
| 区间合并,关闭 A | 66.29 秒 | 344.78MB | 2800 | 12.31GiB |
| 相同输出,关闭 B | 2.75 秒 | 1.96MB | 16 | 12.15GiB |
| 候选关闭组,第二次代码修复 | 77.53 秒 | 533.02MB | 4382 | 11.23GiB |
| 紧接着的日志代码 | 61.29 秒 | 366.20MB | 3009 | 11.35GiB |
本机确有需要优先处理的文件取页与缓存覆盖问题。 相同输出的区间合并中,读盘和 major fault 大幅减少,等待同时缩短;长代码也反复出现读盘与缺页。可用 RAM 约 11–12GiB 是请求期间的快照,专家补集加 PLE 全表约 43GiB 的总驻留需求仍超过本机 31.3GiB。这解释了为何机器能运行,访问不同数据时又会补页。
本轮尚未记录每个文件、每次块 I/O 的提交到完成时间,所以 PLE 的具体读取占比、存储延迟在请求中占多少,留给逐文件与块 I/O 时间线核验。对照中 4K 热输入的 24 次请求读盘为零,说明这部分请求可以转向检查计算与搬运。表中请求数据
尾部跳过省下的时间,对应怎样的质量
这一版本的默认策略,会省去部分未驻留显存、在当前窗口内始终只排第 8–10 位的专家贡献。STRATA_ROUTE_TAIL_SKIP=0 恢复这部分计算。驻留显存的专家继续计算;跳过后保留其余路由权重。固定版本的跳过条件
最终对照换成相同候选配置:prefill 2048、7 个工作线程、后台线程使用空闲 CPU、MTP=4。每项两次,下面同时列速度和读取量。
| 任务 | 关闭:decode token/s | 默认:decode token/s | 关闭 / 默认读取量(MB,两次) |
|---|---|---|---|
| 对话首轮 | 11.1 / 10.4 | 10.9 / 42.9 | 113 / 75;69 / 8 |
| 对话追问 | 31.2 / 7.0 | 10.6 / 44.7 | 14 / 96;68 / 5 |
| 区间合并 | 74.1 / 71.2 | 90.1 / 105.8 | 小于 1;小于 1 |
| 日志聚合 | 72.2 / 12.4 | 67.1 / 108.8 | 16 / 366;21 / 6 |
区间合并的四个回答逐字相同、67 项测试全部通过,读取量都小于 1MB;这组观测中,默认策略用 1.96–2.28 秒完成,关闭后为 2.66–2.67 秒。这组低读盘、同输出的观测与减少专家工作量的预期一致。对话和较长代码还叠加了不同输出及存储等待,波动就大得多。
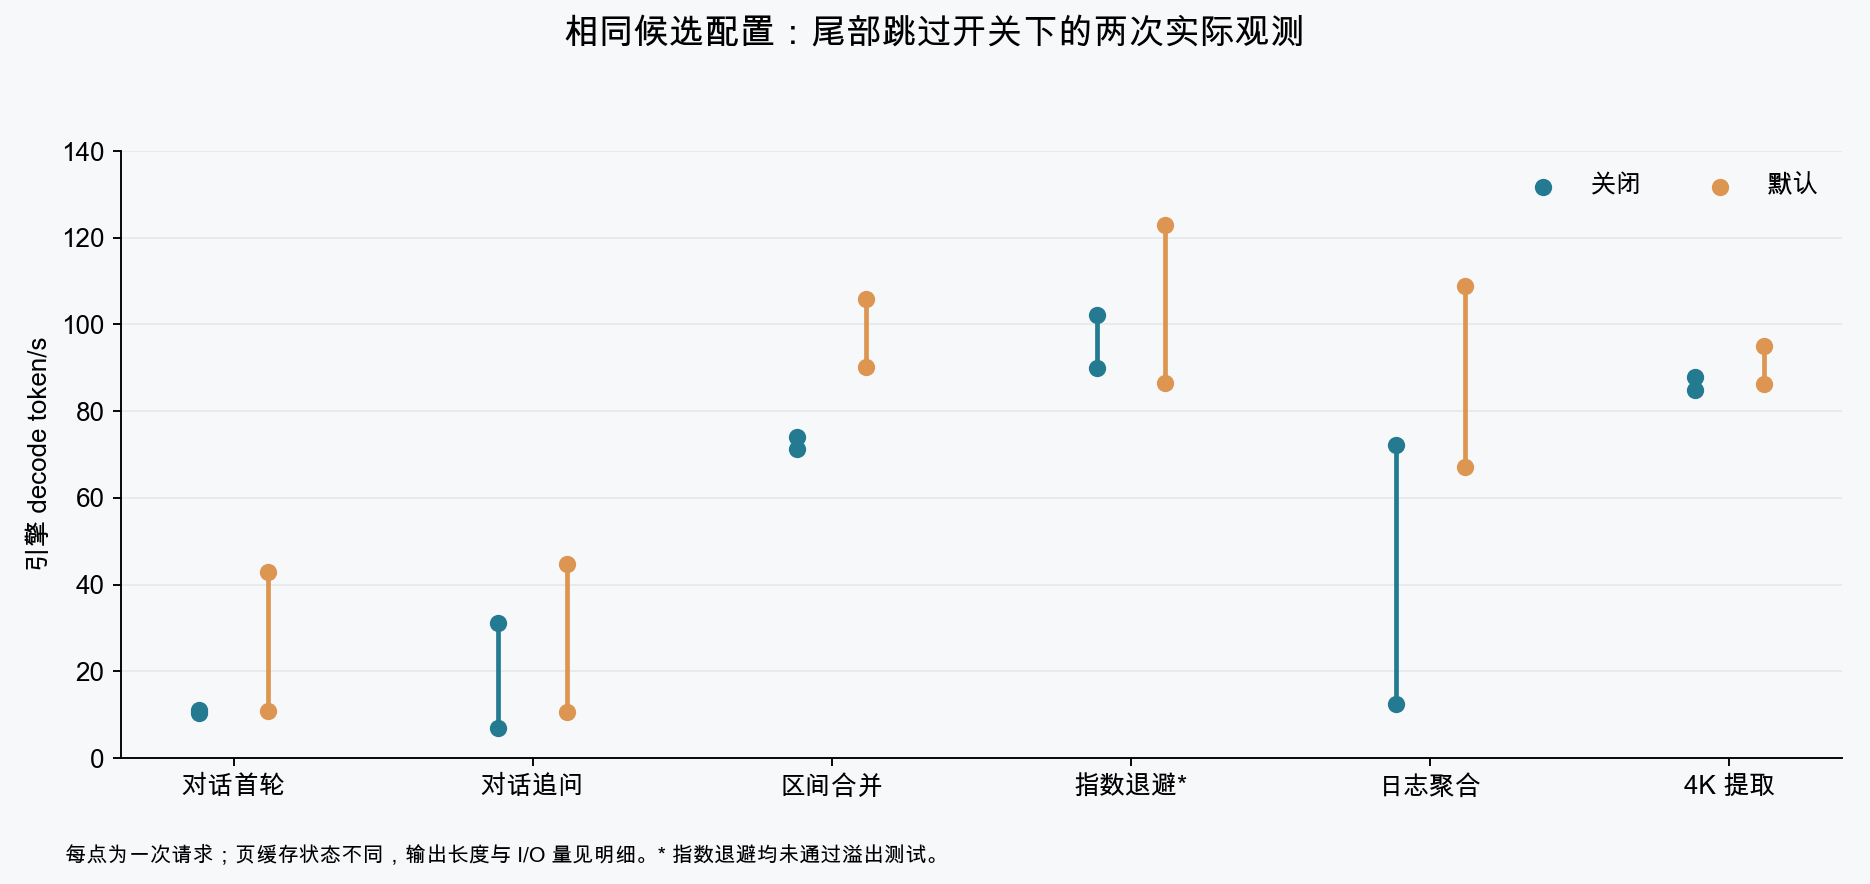
速度上的差异已经出现,接着检查这些设置生成的代码。
初始四组和最终确认四组,共有 12 遍完整题集。区间合并与日志聚合每遍都通过测试;指数退避每遍都在同一项边界失败。
模型反复使用了这样的表达式:
min(cap, base * (2 ** i)) |
当 base=0.5、i 很大时,乘法在截断到 cap 之前就会触发大整数转浮点溢出。题目已经明确要求处理 10000 次;关闭尾部跳过后,这个错误仍然存在。
接着把真实报错交给模型,保持函数签名和边界规则,并允许输出 1024 token。结果开始分化:
| 配置 | 两次修复通过原有 14 项测试 | 实际表现 |
|---|---|---|
| 原配置,关闭跳过 | 2 / 2 | 第一份代码在后来追加的“大次数、base=0”测试中失败 |
| 候选配置,关闭跳过 | 1 / 2 | 一次修复成功;一次到 1024 token 截断 |
| 候选配置,默认策略 | 0 / 2 | 一次截断;一次在 attempts=0 时返回 None |
| 候选配置,MTP=8,关闭跳过 | 1 / 2 | 一次修复成功;一次截断 |
追加的零值测试来自对修复代码的检查,独立保存,不回改事先冻结的 14 项评分。第一份修复把整数幂换成持续倍增的浮点数,避免了原异常,却留下 0 * inf 的问题。修好一个例子以后,仍需要回归边界条件。
三次截断的响应都没有独立的 reasoning 内容。输出额度花在了代码和大量推演注释上,函数尚未完整写完就触及上限。应用收到的是待完成的代码。
对话中的时间计算在这 12 遍中都正确;其中一次把完成时间叫成了吞吐量。工单 JSON 中的时间、配置和后续措施一致,但 cause 字段把“已证实发生的配置变化”写得像“已证实的故障原因”。这些是答案本身需要检查的地方。
本轮候选配置关闭跳过后,得到过一次通过全部边界检查的修复;默认策略两次都未通过。每个配置两次修复,适合展示具体失败方式。总体质量差异还需要更多独立代码题覆盖。
怎样观察速度优化是否带来输出问题:保存 SSE 的 finish_reason、输出 token 数、content/reasoning 和完整代码,再运行事先固定的测试。尾部开关在同输出、低读盘的区间合并题上显示了速度差异,四份代码均通过 67 项测试。修复题则出现具体应用问题:候选关闭组通过 1/2,默认组通过 0/2;全部确认配置合计三次 length 截断,独立 reasoning 内容为空。这里把截断、边界失败和成功完成分别统计,直接看应用能否得到可用结果。
优化后,实际使用能期待怎样的速度
把通过任务检查的快样本、实际对话和修复任务分开,速度就容易理解了。
| 负载 | 本轮观测 |
|---|---|
| 反复运行的区间合并,117-token 输入、160-token 输出 | 最高 149.7 token/s,完整请求 1.50 秒,67 / 67 测试通过,进程读取 0MB;关闭跳过,MTP 门槛 0.7 |
| 日志聚合,166-token 输入、505-token 输出 | 最高 108.8 token/s,完整请求 5.13 秒,10 / 10 测试通过;候选默认策略,读取 5.9MB |
| 候选配置两轮容量对话与追问 | 开关两组共八次,7.0–44.7 token/s,完整请求 1.97–14.79 秒 |
| 四种确认配置的代码修复 | 共八次,5.2–22.1 token/s,32.3–118.8 秒;其中三次截断,质量见前表 |
149.7 token/s 对应反复运行的短题,解码约 1.07 秒。这个数字描述已访问数据足够热时的一次峰值。更长的代码和改变输出内容的修复,会接触到另一批数据,等待也会重新出现。
怎样判断“跑得快”是否对使用有帮助:同时报告 TTFT、decode token/s、到 DONE 的完整耗时与任务通过情况。149.7 token/s 那次请求只解码了 1.069 秒,总耗时 1.496 秒,67/67 测试通过,read_bytes 与 major fault 增量均为零。它是有效的热短题样本;实际对话和修复任务按上表分别给出范围,后续扩大题集后再统计稳定性与分位数。
更好的预期:让新任务少读盘,让快的状态维持得更久
当前机器已经展示过两种状态:重复短题解码接近 150 token/s,改变输出内容的修复任务则可能等待几十秒。下一轮最值得争取的改善,是减少新请求的数据等待,让相近任务的完成时间更稳定。
首先把内存预算列出来:
| 数据 | 当前规模 | 放置方式与需求 |
|---|---|---|
| 未驻留显存的专家补集 | 约 16.17GiB | 当前配置固定在 RAM |
| PLE n-gram 表 | 约 28.8GB,折合约 26.8GiB | 当前走 mmap;全表常驻需要这部分 RAM |
| 上述两项合计 | 约 43GiB | 还需要给系统、服务及其他工作缓冲留空间 |
这两项合计已超过当前约 31.3GiB 的可见 RAM。下一轮可以把虚拟机内存扩到 64GiB,保持 CPU、GPU、模型和任务不变,比较 mmap 与 PLE 全表常驻。64GiB 是按这份模型和当前模式提出的实验容量,加载成功、实际占用和长输入测试共同决定它是否够用。
如果主要等待确实来自 PLE 的缺页读取,那么全表驻留后,新题访问 PLE 时就能直接从 RAM 取数据。预期先体现在请求期间读盘减少、首字与完整耗时缩短,以及慢请求之间的波动收敛。CPU 专家计算、PCIe 搬运和 GPU 验证仍有各自成本,届时再测它们限制了多少速度。
| 下一轮对照 | 保持什么一致 | 期待看到什么 | 如何确认 |
|---|---|---|---|
| 32GiB mmap → 64GiB mmap | 模型、参数、CPU/GPU、题集与运行顺序 | 更多访问过的页可被保留,重复运行更稳定 | 请求读盘、major fault、首字与完整耗时 |
| 64GiB mmap → 64GiB PLE 常驻 | 同一容量与其他参数 | 新题的 PLE 访问等待减少 | 日志确认常驻;逐文件读盘与任务耗时对照 |
| 读盘下降后重新比较线程与 PCIe 份额 | 固定题目、输出验收及数据准备方式 | 找到当前 CPU/GPU 分工更合适的比例 | 相同任务重复测量,检查时间与质量 |
| 扩充独立代码任务,再测尾部开关 | 相同代码题、测试集与输出预算 | 更清楚地判断省下的时间对应怎样的成功率 | 首次通过率、反馈后通过率、截断数及完成时间 |
这些是待测预期。本文中的 149.7 token/s 是已测到的热短题峰值,108.8 token/s 是一份通过测试的 505-token 日志代码结果。它们提供了观察计算路径的参照;增加内存能把多少新任务带到相近速度,要由下一轮同题对照给出。
对实际使用,下一轮会把“重复同题”和“第一次运行的新题”分别统计,再给出完成时间的中位数和 p95。这样更容易判断每天发出的请求会等多久。
留下哪套配置继续使用
本轮保留的候选参数为:
export STRATA_ROUTE_TAIL_SKIP=0 |
它保留完整的路由专家贡献,使用通过 4K 与 17K 输入验证的分块,并为后台线程留出 CPU。模型仍是同一份 IQ2_XS;驱动、功率上限和 GPU 时钟保持原配置。默认跳过策略保留为速度对照配置。Prefill 的 CPU 分担保留默认自动策略;本轮为隔离变量而设置的关闭开关,只用于对照组。
2026 年 10 月 13 日完成实验后,候选配置已在原服务端口启用,/health 返回 loaded: true;核对了运行进程参数和尾部开关,短请求正常结束。原配置另存备份,另附恢复步骤。重启时使用保存了尾部开关的启动脚本。10 月 14 日隔离对照后已恢复这套日常配置,CPU 分担和前缀缓存回到默认设置;加载检查及短请求验证通过。
恢复服务时,本文同时核对实际进程参数、尾部开关环境变量和 /health,再发一条短请求。10 月 14 日恢复后,请求正常返回“服务已恢复”,TTFT 1.08 秒、完整耗时 1.32 秒。这项记录验证配置恢复和请求链路,单独保存在证据包,未计入 24 次性能对照。
注:环境、计时与复现
首轮实验完成于 2026 年 10 月 13 日,10 月 14 日追加 CPU 分担与分块隔离对照;64GiB 内存与 PLE 常驻对照尚未执行。
题集包括服务容量两轮对话、工单 JSON、区间合并、指数退避、JSONL 聚合和变更记录提取。代码分别有 67、14、10 项事先固定的测试;修复后追加的“大次数、base=0”测试单独保存。追问包含上一轮真实回答。
源码固定在
7695859aa13afb248bdb4d36f9b2e95707db079d;引擎 SHA-256 为6cc0dda09c0327810d590c4e15d610e8a7a8f3ab05fcfc7376da77b18054e42e。3090 使用 SM 8.6 构建,Xeon Gold 5318Y 的 16 vCPU,约 31.3GiB 可见 RAM,无 swap。temperature=0、seed=20261013、reasoning_effort=none。固定最大输出:对话 768、工单 512、合并/退避/修复 1024、日志 1200、记录提取 384 token。CPU/GPU 归约和自适应调度会带来重复间差异。
首字时间从发送请求计到首个可见内容;完整耗时计到 SSE DONE;decode token/s 取引擎
predicted_n / predicted_ms。HTTP200、DONE、finish_reason=stop共同表示正常结束;答案正确性另行检查。10 月 13 日共 139 个计分请求,其中 136 个正常结束,3 个修复请求触及长度上限;16 条短预热另计。10 月 14 日新增 24 个正式请求,全部正常结束,另有 16 次完整输入预热。合计 163 个正式请求。4K 与 17K 内容为有明确答案的结构化变更记录。
10 月 14 日四组全部设置
--prompt-cache 0 --conversation-cache-mib 0;模型加载、预热分别记录。每配置来自两次独立启动,每次连续重复三次同题,进程内保留专家自适应交换。均值为六次指标的算术平均值;本轮覆盖一份结构化输入。256 关闭组的 26.14 秒长尾保留,具体 GPU 等待位置尚未追踪。CPU 分担对照针对默认自动策略,未插桩统计逐层专家数量。每组重启模型,脚本不执行全局
drop_caches;引擎加载会按内存需求释放部分模型缓存页。读盘量取请求前后进程/proc/PID/io的read_bytes差值,模型加载的 I/O 不计入请求。该指标覆盖整个进程,尚未按文件做块 I/O 归因。资源每 2 秒采样,图中 GPU 利用率、可用 RAM 和进程读取使用相同时间轴。短于采样周期的请求可能没有独立 GPU 样本。虚拟磁盘暴露的
ROTA=1是虚拟设备属性。代码边界测试与对话逐项复核覆盖本文工作样本;没有进行 BF16 或其他量化精度的同题对照。尾部开关、模型量化和代码能力是三个不同的实验变量。
10 月 13 日逐请求汇总 CSV、固定任务、评分条件、复现与脱敏证据包。包内保留每次实际回答、配置、时间、评分与资源采样;原始本地记录单独保留。
10 月 14 日隔离对照 CSV、按配置汇总、隔离对照证据包。反序补充了每秒一次的 PCIe 活动采样,原始记录随包保存;该采样用于观察设备活动,未换算为专家总搬运字节数。
分层观测方法、观测摘录 CSV、请求与启动校准明细及提取脚本随主证据包保存。本次补充来自已有记录,没有新增性能测试;CPU时间包含全部线程与两个推理阶段,GPU为低频采样,尚无逐线程调度或CUDA细粒度trace。