上一篇比较了 CRAM 与 zram 的读写路径。CRAM 页可以保留读映射,首次写再提升到普通内存。但实验里还有一个问题:把页迁入 CRAM,有时会突然慢很多。
单页 trace 中,move_pages 用了约 462 µs,lru_cache_disable 占了 374 µs,其中 RCU 等待约 332 µs;真正的 folio_mc_copy 只有约 1.7 µs。这让人首先怀疑:是不是 LRU 算法出了问题?最近 Kairui Song 的内存回收补丁,能不能解决这个毛刺?
本文沿着这个问题继续往下查。先回移完整的 LRU 批次管理补丁,做 CRAM A/B;再拆剩下的 15 ms 长尾;最后调整后台任务的 CPU 分工,把页归还、PCP 入队出队和下一次分配的 PFN 连起来。
最后得到的结果很具体:LRU 同步、后台清理抢占前台的 CPU、新物理页的 EPT 映射,分别造成了不同阶段的等待。只移动后台发送任务,还会改变页归还的位置,进而影响下一次分配。
先分清楚:这里有三种“LRU 优化”
Kairui Song 的工作确实与内存回收有关,但“使用了 zram 的测试”不等于“优化 zram 自己的 LRU”。
| 工作 | 改动关注什么 | 与本轮迁入等待的关系 |
|---|---|---|
| Kairui Song 的 MGLRU reclaim 系列 | 扫描预算、aging、回收循环和脏页写回 | 关注哪些页被回收、回收怎样推进;本轮内核未启用 MGLRU |
| 同步 swap 设备相关的写回改动 | swap-out 时写回与 folio 状态处理 | 处在换出链上;本轮测的是 move_pages 迁入 CRAM |
| Hugh Dickins 的 fbatch 系列 | 每 CPU 的 LRU 待处理批次、引用计数和页隔离 | 直接涉及迁移前的 LRU drain 与 lru_cache_disable |
Kairui 的系列重整 MGLRU 回收路径,作者也使用过 zram 负载做测试。我们的固定配置是经典 LRU,CONFIG_LRU_GEN 未启用。因此,要处理眼前这段同步等待,应该看迁移入口和批次管理。Kairui Song 的 MGLRU v7
页可能还挂在某个 CPU 的 LRU 待处理批次里,迁移却要隔离它。旧路径先把这些批次处理完,再开始迁移。Hugh 的 26 个 fbatch 补丁改变了批次中 folio 的管理方式,让它们保持可隔离状态,并减少批次持有的额外引用;系列中的迁移改动因此可以移除 lru_cache_disable。Hugh Dickins 的 fbatch v2
这里的问题是开始迁移前,为了保证页状态一致而付出的同步成本。它与“LRU 选错了冷热页”是两件事。
完整回移后,小批迁入快了,大批长尾还在
先在普通 RAM→RAM 迁移上验证整套补丁,再把 01–26 全部回移到固定的 CRAM 分支。CRAM 的私有内存节点、页释放回调和写 fault 提升路径也要适配新的批次与引用计数规则。
A/B 两组都带同一个 CRAM 页释放修正,避免把正确性修复混进补丁收益。前台固定在 CPU 0,关闭 THP、MGLRU 和自动 NUMA balancing。每个表格单元来自三次新 guest,总计 600 个无详细 tracing 样本。
下表单位为 µs,测量范围是 move_pages 系统调用。
| 每次迁入页数 | 原版中位数 | fbatch 中位数 | 原版 P99 | fbatch P99 | fbatch 最大值 |
|---|---|---|---|---|---|
| 1 | 643.132 | 30.080 | 2453.772 | 98.668 | 142.856 |
| 16 | 670.061 | 32.564 | 16023.429 | 419.530 | 521.075 |
| 256 | 1827.658 | 607.466 | 19656.455 | 13691.034 | 15861.356 |
独立 trace 中,原版九次调用都有入口 lru_cache_disable 和 RCU 等待;回移后这两条路径都消失了。单页中位数下降约 95%,256 页中位数下降约 67%。
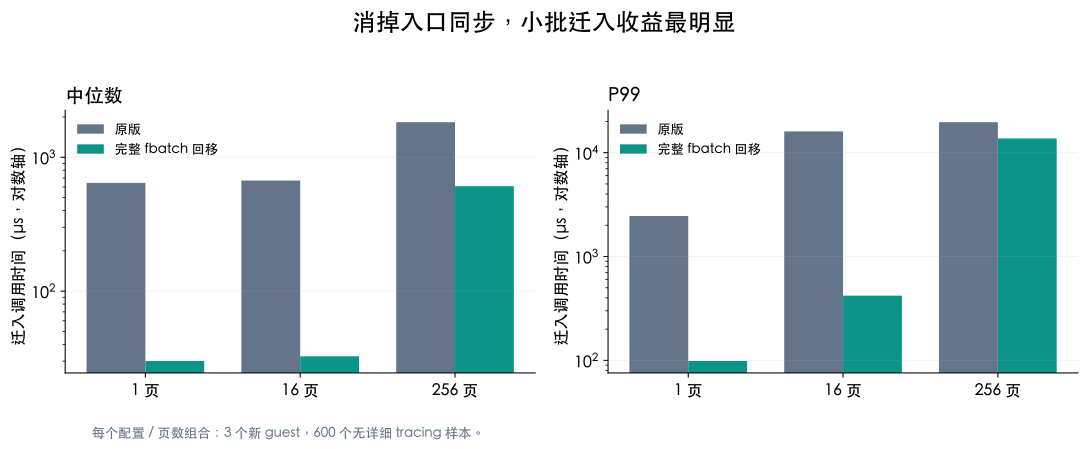
但 256 页组仍有 15.861 ms 的最大值。同步等待消掉了,剩下的长尾需要重新抓现场。
15 ms 去了哪里:前台让出 CPU,后台清理接着跑
继续运行 256 页迁入负载,捕获到一次 16.183 ms 的调用。下面是这次 trace 的时间线,各行共享同一个 guest 时钟。
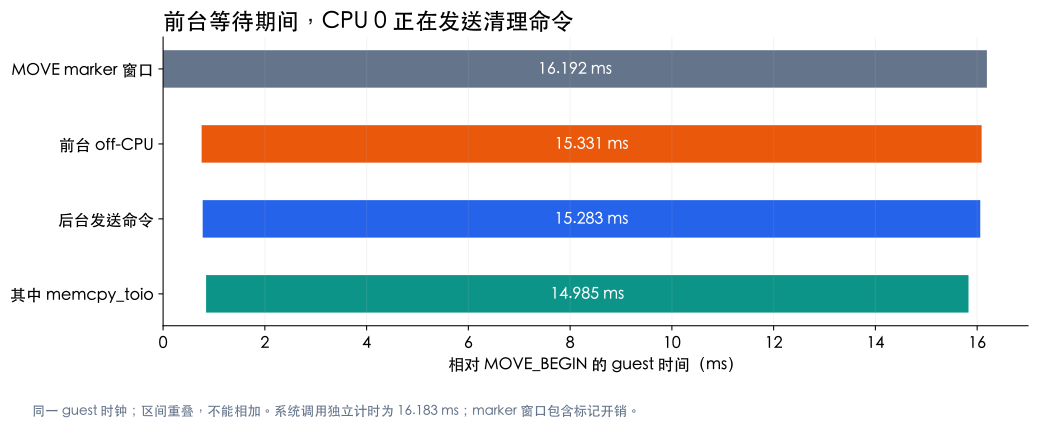
前台在 __cond_resched 处让出 CPU,切出时状态是 R+,仍然可以运行。随后 CPU 0 跑起清理 worker;前台直到约 15.331 ms 后才重新获得 CPU。
| 观测项 | 时间 |
|---|---|
| 前台迁入调用 | 16.183 ms |
| 前台不在 CPU 上 | 15.331 ms |
同期后台 cxl_internal_send_cmd |
15.283 ms |
其中 memcpy_toio |
14.985 ms |
| doorbell 等待 | 0.025 ms |
这些时间相互包含、重叠,不能相加。关键是:这次长尾的大部分时间里,前台没有执行迁入,它在等 CPU。
后台清理的是什么?是前面几轮写入提升后,留下的旧 CRAM 页。它们要完成设备清零,再归还给分配器。这里并不是把当前 DRAM 页“后台同步回 DRAM”。
新一轮迁入与旧页清理,本来可以是两个任务。但固定实现把 overflow worker 排到调用 CPU,前台也固定在 CPU 0。即使 guest 有两个 vCPU,后台工作仍然会排到 CPU 0。前台在可调度点让出执行机会,清理任务就接着跑。
所以这里不存在“向设备写一次,就必须切走前台一次”的规则。实际发生的是两个任务共享同一个 CPU,而清理任务一次占用了较长时间。
memcpy_toio 为什么要 15 ms:2040 字节,510 次 MMIO 往返
继续拆后台清理命令。驱动已经做了批处理:一次清理最多携带 127 个地址范围。
本次 payload 包含 8 字节头部和 127 个 16 字节描述符,总共 2040 字节。这些描述符告诉设备清理哪些地址;如果每个范围是 4 KiB,它们描述的是 508 KiB 页空间。真正写进 mailbox 的仍然只有 2040 字节。
这个 x86 实现的 memcpy_toio 使用 rep movsl,每次写 4 字节。在本轮模拟路径里,宿主 trace 对应到了:
2040 / 4 = 510 次 MMIO 写 |
对一次 15.267 ms 的完整 payload 周期,按互斥的宿主时间区间拆分如下。
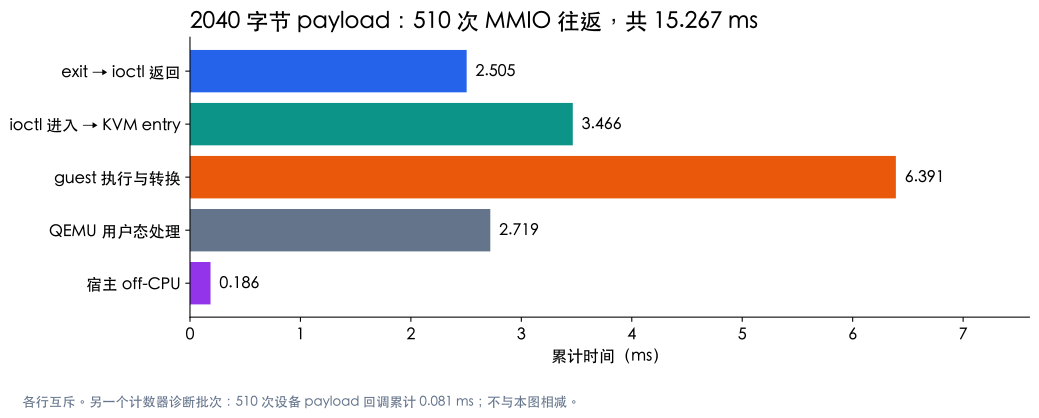
| 阶段 | 累计时间 |
|---|---|
| KVM exit 到 ioctl 返回 | 2.505 ms |
| ioctl 进入到 KVM entry | 3.466 ms |
| KVM entry 到下一次 exit,含 guest 执行与转换 | 6.391 ms |
| 两次 ioctl 之间的 QEMU 用户态处理 | 2.719 ms |
| 宿主线程不在 CPU 上 | 0.186 ms |
| 合计 | 15.267 ms |
另开一批诊断,在 QEMU 设备 payload 回调里加计数器:510 次回调累计约 0.081 ms。它测的是设备回调本身,上一张表里的 QEMU 用户态阶段还包含分发等工作。
这解释了为什么两千字节也能写得很慢:这条模拟路径把 payload 拆成了 510 次需要返回用户态的访问。设备回调的数据处理只是其中一小段。驱动已经在按地址范围批量发命令,但一个批次的 payload 仍然有很多次 MMIO 访问。
把发送搬到 CPU 1:大毛刺少了,P99 却升高
接下来只改变后台发送的 CPU,保持 QEMU、前台负载和同一轮内核镜像不变。每组六次新 guest,每次 1000 轮,每轮迁入 256 页。
负载的完整循环是:准备普通页 → 迁入 CRAM → 读与校验 → 局部写触发提升 → 校验页回到 node 0 → 下一轮。表格只计迁入系统调用。
| 配置 | 中位数 | P99 | 最大值 | ≥10 ms 次数 / 6000 |
|---|---|---|---|---|
| 发送留在 CPU 0 | 0.588 ms | 0.955 ms | 18.674 ms | 16 |
| 发送移到 CPU 1 | 0.572 ms | 1.987 ms | 10.182 ms | 1 |
超过 10 ms 的调用从 16 次降到 1 次,说明移走发送任务确实减少了那类大毛刺。但 P99 从约 1 ms 变成约 2 ms。
继续抓这批约 2 ms 的迁入,发现它们与之前的 15 ms 等待不同。一条 1.968 ms 调用中:
folio_mc_copy用了 1.026 ms,其中copy_mc_to_kernel约 0.912 ms。- 前台不在 CPU 上只有 0.015 ms。
- 真正复制指令
rep movsb对应 39 次EPT_VIOLATION。 - 这 39 次 fault 对应本轮首次观察到的目标 GPA;没有返回用户态 QEMU。
另一条 3.242 ms 调用有 80 次同类 EPT fault;一个较快样本的复制只有约 0.108 ms,目标 EPT fault 为 0。
这里需要分清两种 exit:
| 位置 | 事件 | 本轮处理路径 |
|---|---|---|
| 写 mailbox payload | EPT_MISCONFIG / KVM_EXIT_MMIO |
返回 QEMU,处理模拟设备寄存器访问 |
| 向 RAM 后备的 CRAM 目标页复制 | EPT_VIOLATION |
KVM 处理目标内存映射,没有返回 QEMU 用户态 |
前一类拖慢后台命令,后一类出现在真正的页复制上。把前一类工作移走后,后一类成本变得明显了。
发送和归还拆开:CPU 1 发命令,CPU 0 归还页
检查代码才发现,上一步移走的不只有发送:发送完成后的 folio_put 也一起在 CPU 1 执行了。
这会影响空闲页放在哪里。Linux 的 PCP 是每 CPU 的空闲物理页列表。CPU 1 归还的页可以进入 CPU 1 的 PCP;下一轮前台仍在 CPU 0 分配,不能直接从自己的 PCP 取到这些页。
于是做三组对照,三个配置使用同一个新镜像:
| 配置 | 发送 CPU | 设备清零后归还 CPU | 中位数 | P99 | 最大值 |
|---|---|---|---|---|---|
| local | 0 | 0 | 0.583 ms | 13.032 ms | 19.443 ms |
| remote | 1 | 1 | 0.576 ms | 1.888 ms | 5.613 ms |
| split | 1 | 0 | 0.580 ms | 0.903 ms | 7.153 ms |
每组同样是六次新 guest、共 6000 个迁入样本。split 在清零命令完成后,由 CPU 0 执行归还,再复用批次缓冲区。
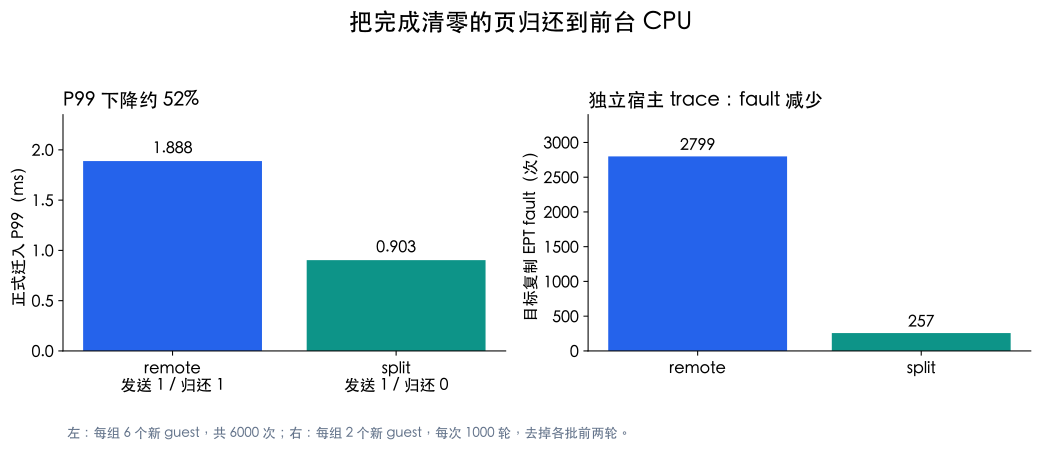
与 remote 相比,split 的中位数基本相同,P99 下降约 **52%**。六次独立 guest 的 P99 都向同一方向变化;最大值则是 5.613→7.153 ms。
独立的宿主 trace 每组两次,每次完整运行 1000 轮。去掉各批前两轮后,目标复制 EPT fault 从 2799 次降到 257 次。这说明变化不仅体现在调用时间上,实际复制路径中的映射 fault 也减少了。
不过,看到 fault 减少,还差最后一环:CPU 0 后来取到的,究竟是不是刚刚归还的那些物理页?
沿着 PFN 跟一遍:归还的页,确实被下一批复用了
再开四个干净 guest,顺序为 remote、split、split、remote。每次 256 轮 × 256 页,共跟踪 262144 次目标页分配。
这次给每个 PFN 的每次分配加上代次,把以下事件串起来:设备清零完成后的归还 → PCP 入队 → PCP 出队 → alloc_cram_folio 返回 → 下一次复制。宿主 EPT 事件通过目标 GPA 与 guest PFN 对上。
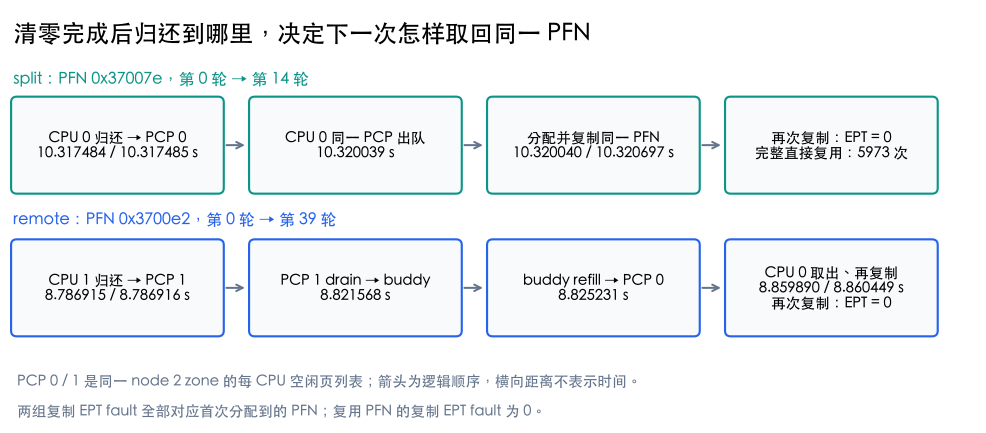
以 split 中的 PFN 0x37007e 为例:
| guest 时间 | CPU | 事件 |
|---|---|---|
| 10.317484 s | 0 | 设备清零完成,准备 folio_put |
| 10.317485 s | 0 | 页进入 CPU 0 PCP |
| 10.320039 s | 0 | 同一 PFN 从同一 PCP、同一链表出队 |
| 10.320040 s | 0 | alloc_cram_folio 返回这个 PFN |
| 10.320697 s | 0 | 复制下一批内容,目标复制 EPT fault 为 0 |
它在第 0 轮首次分配时有一次 EPT fault,第 14 轮再次使用时没有。
remote 中也能复用旧页,但路径更长。例如 PFN 0x3700e2:CPU 1 归还 → CPU 1 PCP → drain 到 buddy → refill 到 CPU 0 PCP → CPU 0 在第 39 轮取出。它再次复制时同样没有 EPT fault。
两组汇总如下,各有 131072 次目标分配。
| 目标页来源 | remote 次数 | split 次数 |
|---|---|---|
| CPU 0 普通归还后直接 PCP 复用 | 123826 | 123825 |
| 设备批量清零归还后,从 CPU 0 PCP 直接复用 | 0 | 5973 |
| 设备批量归还后,经 buddy 补回 CPU 0 PCP 再复用 | 4174 | 0 |
| 工作负载首次分配到的 PFN,由 buddy 补入 PCP | 3072 | 1274 |
5973 次直接复用都有完整的归还、入队、出队、分配和复制记录,目标复制 EPT fault 全部为 0。两组的复制 EPT fault 则全部对应工作负载首次分配到的目标 PFN:remote 为 3072 次,split 为 1274 次。
PCP 入队放在链表头,分配也从链表头取。把页归还到 CPU 0,相当于把已经清理、已经用过的物理页放回前台正在取页的列表;归还到 CPU 1,则要等这些页经其他路径回到 CPU 0。
这里的“node 2 的 CPU 0 PCP”,是 CRAM 节点所在 zone 的 CPU 0 空闲页列表。它不是 CPU 数据 cache,node 2 也不是 CPU 2。
现在 CPU 各在做什么
把最终 split 配置展开,就容易理解了。
| 阶段 | CPU 0 | CPU 1 |
|---|---|---|
| 迁入 | 前台分配 CRAM 目标页,复制 DRAM→CRAM | 可以发送前面批次的清理命令 |
| 首次写 | 提升页,复制 CRAM→DRAM | 可以继续处理已有后台工作 |
| 延迟清理 | 交换清理缓冲区,等待发送完成 | 向设备发媒体清零命令 |
| 清零完成 | 归还页到 CPU 0 PCP | 通知发送完成 |
| 下一轮 | 从自己的 PCP 复用目标页,再复制新内容 | 继续发送其他清理批次 |
这轮实验回答了三个不同的问题。
小批迁入时,旧路径先花时间等待 LRU 批次同步;完整 fbatch 回移后,单页中位数从 643 µs 降到了 30 µs。
持续进行“迁入→写入提升→再次迁入”时,旧 CRAM 页的清理会与下一轮迁入同时发生。清理与前台共用 CPU 0,产生了约 15 ms 的可运行等待;把发送放到 CPU 1,减少了这类大毛刺。
发送完成后,如果页也归还到 CPU 1,CPU 0 下一轮会使用更多此前未用过的目标 PFN。在本轮 RAM 后备的 KVM 模型里,这些新 PFN 带来了复制 EPT fault。发送留在 CPU 1、归还放回 CPU 0 后,前台可以直接复用已用过的页,P99 从 1.888 ms 降到 0.903 ms。
后台任务在哪里执行,影响的不只有当前这次等待;页最终归还到哪里,也会影响下一批分配和复制。
数据与复现
正文图表使用的汇总数据、绘图脚本和PFN 路径 Mermaid 源码一并保留。
实验附件包包含补丁、C probe、guest 初始化脚本、QEMU 启动脚本、分析脚本、正式逐样本 CSV、逐页示例和构建元数据。附件中的 README说明目录、运行方法和 trace 口径。实验机路径已经替换,QEMU 启动脚本通过环境变量指定本地文件。
最终 CPU 对照的启动参数如下,其他 QEMU 参数保持一致:
local: cxl_compression.flush_cpu=-1 cxl_compression.release_cpu=-1 |
-1 表示沿用对应的当前执行 CPU,具体以附件补丁实现为准。这两个参数来自本轮实验补丁。
注
- 模拟条件。 guest 使用 2 vCPU、512 MiB 普通内存和 512 MiB RAM 后备 CXL CT3。设备没有真实硬件压缩。实验运行在嵌套虚拟化环境;本文讨论这套模型中观测到的调度、迁移和映射成本。宿主 trace 可见 L1 KVM,未采集 L0 时间线。
- 版本与补丁。 CRAM 基础 commit 为
9fa5ffee4fd4726e31f05deebb938cccfa0b460f,QEMU 为a078aaedd382eedd121a037ffa992bb9db964acb。fbatch 回移包含 v2 的 01–26,排除额外调试 hack,并适配 CRAM。两组共同修正 free 回调的零引用计数处理,使用folio_ref_unfreeze(folio, 1);CPU 实验在此基础上增加发送/归还 CPU 参数。DEBUG_VM=y,THP、MGLRU 和自动 NUMA balancing 关闭。 - 各轮口径。 fbatch A/B、首次 CPU A/B、三组 CPU 对照、PFN 诊断是不同轮次。各自只比较同轮、同镜像配置;跨轮数值分别保留。fbatch 表按原分析脚本的
floor(p×(n−1))取分位点;后续 CPU 表使用 nearest-rank。每组 6000 次也是六个新 guest 样本的合并分布。 - 计时范围。 正式分布来自关闭详细 tracing 的迁入系统调用计时;读、局部写提升、位置与内容校验发生在计时区间外。详细 trace 用于解释路径。函数时间包含子调用和函数内等待;图中重叠区间按实际时间戳绘制。原 96.789 ms 和 15.861 ms 极值没有完整现场 trace,本文拆解的是新捕获的 16.183 ms 调用。
- MMIO 分解。 15.267 ms 的互斥分段来自原 QEMU;0.081 ms 的 payload 回调统计来自单独的计数器诊断批次。KVM entry→exit 阶段包含 guest 执行和转换,不能全部命名为 VM exit 耗时。计数器 QEMU 未用于后续正式 CPU A/B。
- 逐页诊断。 四次 guest 每次 256 轮,使用每 CPU 32 MiB trace 缓冲区,与 1000 轮正式计时分开。入队、出队和分配通过 PFN 与代次匹配;EPT 用
GPA >> 12关联 PFN,不将 guest 与宿主时钟直接相减。该批去掉前两轮后的 EPT 是 2052→254;上一批完整 1000 轮宿主对照为 2799→257。 - 探针完整性。 逐页实验的 guest/host trace 没有 dropped/overrun。全局入队探针有少量 miss,但目标分配的每一代都匹配到完整入队、出队与复制记录,目标事件数量守恒;不将全局探针描述为零漏记。PCP 内联辅助函数用反汇编确认的调用点采集,偏移只适用于附件记录的固定内核。
- 正确性检查。 CPU 对照和逐页诊断各组完成页内容与位置校验;fbatch 回移还检查了立即写提升、并发写、页释放及 mlock/lazyfree 路径。split 始终在媒体命令完成后归还页。它只改变这条设备批量归还路径的执行 CPU,普通页的所有释放路径并未统一迁到 CPU 0。