在一张 24GB 显卡和 32GB 系统内存上,Strata 能完成哪些任务,回答要等多久?本文用 RTX 3090 安装 Qwen3.8-Flash-Next 的 IQ2_XS 模型,依次测试中文多轮对话、SVG 生成和长输入。
中文四轮对话每轮用了约 17–46 秒,一幅完整的鹈鹕骑自行车 SVG 用了约 70 秒。长输入最初触发引擎退出,把 prefill 分块改为 256 后,约 4K 和 16K 输入都生成了设定的 64 个正文 token。后面继续看这些任务怎样执行,以及等待发生在哪里。
专家权重放在哪里,谁来计算?
Strata 是面向 Qwen3.8-Flash-Next 等模型的本地推理引擎,提供聊天界面和兼容常用客户端的 API。本轮使用 0.1.43。项目说明
MoE 模型通过路由器为每个 token 选择一部分专家。Strata 将常用专家的权重缓存到显存,GPU 直接执行这些专家;保存在 RAM 中的专家由 CPU 计算,或通过 PCIe 搬到 GPU 计算。CPU 和 GPU 的结果再合并,继续下一层。实现说明
以一个被路由器选中的专家为例,执行路径可以展开成三种:
权重已在显存:GPU 读取权重 → GPU 专家计算 |
显存缓存命中时,可以直接使用 GPU 上的权重。走 RAM 路径时,CPU 执行专家计算会使用 CPU 算力和内存带宽;GPU 读取 RAM 中的权重会使用 PCIe 链路和内存带宽。引擎合并各条路径上的计算结果,得到这一层的输出。
这一层缓存控制的是专家权重放在 RAM 还是显存。模型还会访问 GGUF 中的其他数据,其中一张 PLE / n-gram 表与本轮的磁盘等待有关,后面结合线程栈看这条路径。
这次使用的机器和配置
实验运行在一台 Linux 虚拟机里,配置如下。
| 项目 | 本次配置 |
|---|---|
| 系统 | Ubuntu 22.04.4 LTS,内核 5.15.0-161 |
| GPU | RTX 3090,24GB 显存,SM 8.6 |
| CPU | Xeon Gold 5318Y,16 个来宾 vCPU,暴露 AVX2 / AVX-512 |
| RAM | 32GB 级别,来宾实际约 31.3GiB;没有 swap |
| 驱动与编译工具链 | NVIDIA 580.126.09;CUDA 12.8.93 |
| 模型 | 原版 Qwen3.8-Flash-Next,IQ2_XS |
| 上下文与 KV | 32768 token;KV int8 |
| 请求设置 | parallel 1,temperature 0,reasoning_effort none |
| 其他设置 | 视觉关闭,保留安装配置中的 MTP 和自适应专家策略 |
安装和 ModelScope 下载
安装按项目的 docs/AI_SETUP.md 进行,模型明确选择 ModelScope。用于这次安装的主要命令如下,假设已经进入固定版本的源码目录;数据目录可以按自己的磁盘位置修改。
./setup.sh --yes --build --family qwen --model IQ2_XS \ |
下载仓库是 ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF。IQ2_XS 的两个 GGUF 分片合计 68,026,093,024 bytes,约 68.03GB,下载后通过 ModelScope 提供的 SHA-256 校验。
本次配置建议预留 130GB 空闲磁盘空间。 安装后的模型数据实际占用约 112GB,组成如下,GB 按十进制计算:
GGUF 保存量化权重;专家 pack 是安装器提取、整理生成的专家权重文件,供引擎加载和计算。MTP 数据用于多 token 预测:先提出后续 token 的候选,再由主模型验证,接受符合结果的部分。数据与推测解码说明
| 内容 | 实际磁盘占用 |
|---|---|
| 两个 GGUF 分片及少量元数据 | 68.03GB |
| MTP 数据 | 6.93GB |
| 专家 pack 及相关文件 | 37.00GB |
| 模型数据合计 | 111.96GB |
130GB 的预算覆盖上述模型数据,并为源码、引擎、Python 环境和安装过程留出余量。这是本次 IQ2_XS 配置的空间预算,其他量化版本可按下载文件和生成 pack 的大小重新估算。
安装结束后,在 Strata 源码目录启动服务:
.venv/bin/python serve/server.py --engine strata \ |
模型加载完成时,/health 会返回 loaded: true。请求测试从这一就绪状态开始计时,模型加载耗时单独记录。官方安装说明
服务保持监听 127.0.0.1。最简单的验证可以通过同机 API 完成:
curl http://127.0.0.1:8080/health |
服务就绪后,先测四轮中文对话,再生成和修改 SVG。
多轮对话能否保留上下文和纠正数据?
为检查上下文和指令跟随,测试设置了一组假设的排障数据:首字要 240 秒,CPU 利用率 15%、GPU 利用率 10%,存在 D 状态线程和缺页。第一轮让模型给出排查方向,第二轮补充线程栈,第三轮把题目中的磁盘读速率从 80MB/s 纠正为 20MB/s,最后要求整理成 JSON。
每一轮都把前面的用户消息和实际助手回答一并传回,保持同一段对话。
| 轮次 | 任务 | 首字时间 | 全部完成 |
|---|---|---|---|
| 1 | 给出排障方向 | 15.97s | 46.26s |
| 2 | 补充缺页和线程栈 | 7.24s | 26.91s |
| 3 | 纠正 80 → 20MB/s | 6.68s | 17.38s |
| 4 | 输出严格 JSON | 9.72s | 23.53s |
四轮都完整结束。最后的 JSON 包含 facts、hypotheses、next_steps 三个字符串数组,保留了纠正后的 20MB/s、CPU / GPU 利用率和 D 状态栈。后续请求也报告了前缀 token 复用。
诊断回答中,模型将缺页现象解释为“内存严重不足”,并进一步推断随机小 I/O 延迟高;最后给出的动作是检查缺页、验证 I/O 延迟和排查线程同步。它给出了方向,但验证步骤比较笼统,实际排障时还要补上对应的采样工具和数据。
更早的一次 MoE 问答还给出了“全部专家必须放在 GPU 显存”的错误回答。Strata 的实际运行路径使用 RAM 和显存共同保存专家,这个问题的回答需要纠正。
让它画一只鹈鹕骑自行车
接下来用 Simon Willison 的趣味测试:
Generate an SVG of a pelican riding a bicycle
通过文本接口让模型返回 SVG 代码,再用浏览器渲染,便能直接看到图形效果。原始测试项目
首轮约 2.17 秒开始输出,69.81 秒完整结束,共生成 1881 token,低于设置的 4096 上限。代码能解析为 SVG,并实际在 Chrome 中渲染。
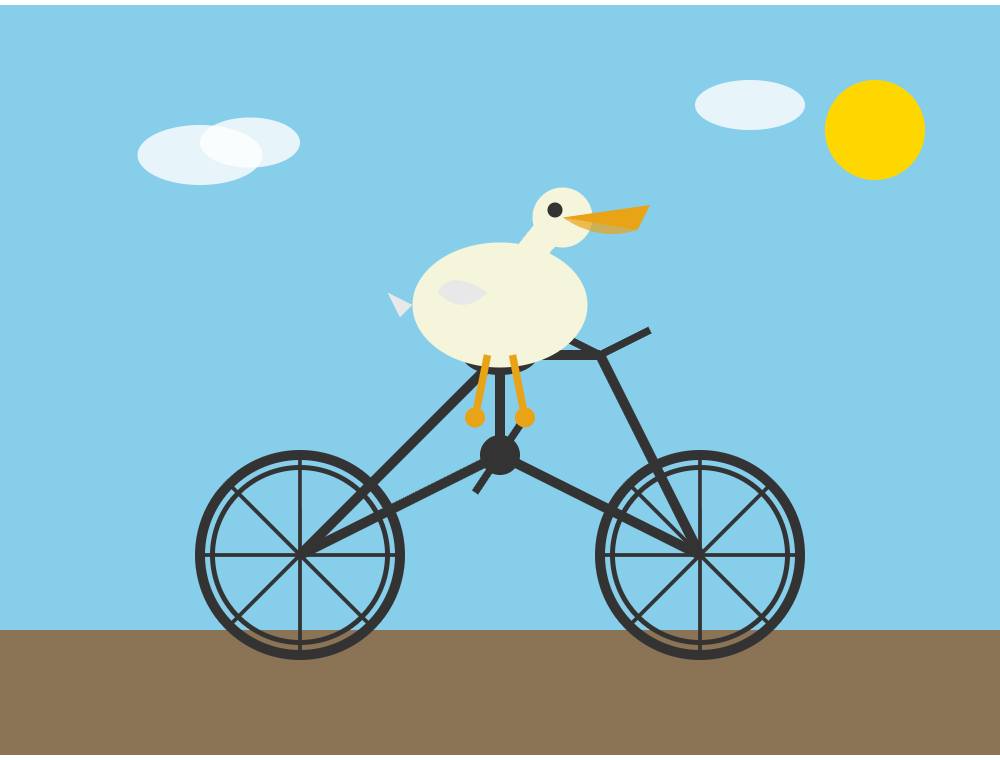
画面能辨认出鸟和自行车。不过,左侧脚停在 (190,165),下方踏板的端点是 (190,195),两者没接上;翅膀也没有接触车把。嘴和喉囊是简单的卡通表达,整体还谈不上精细。
两次修改都返回了原图
根据渲染结果,在同一段对话中反馈:脚要踩住踏板、翅膀要接触车把,并保留车轮和白天背景。第二轮约 30.62 秒完成,但回答与首轮逐字相同,SVG 哈希也相同。
第三轮进一步指出它没有执行修改,给出脚与踏板的坐标,并要求黄昏背景。约 31.06 秒后,仍然拿到了同一份回答。
两轮日志中的输出速度分别约为 94 和 105 tokens/s,生成的代码与首轮完全相同,脚、翅膀和背景都保持原样。
新会话和明确坐标得到了一份修改结果
先让原对话停止画图、只回答四个汉字,模型能正确响应。随后把原 SVG 和明确的修改要求放进一条新的用户消息:
左脚移到下方踏板端点,翅膀延伸到车把,天空改成黄昏橙紫渐变,车轮坐标和尺寸保持不变。
这次约 11.59 秒开始输出,45.92 秒完成,生成 2049 token。左脚和腿的端点、翼尖、天空和太阳位置都有实际变化,车轮圆形的坐标与尺寸保持。
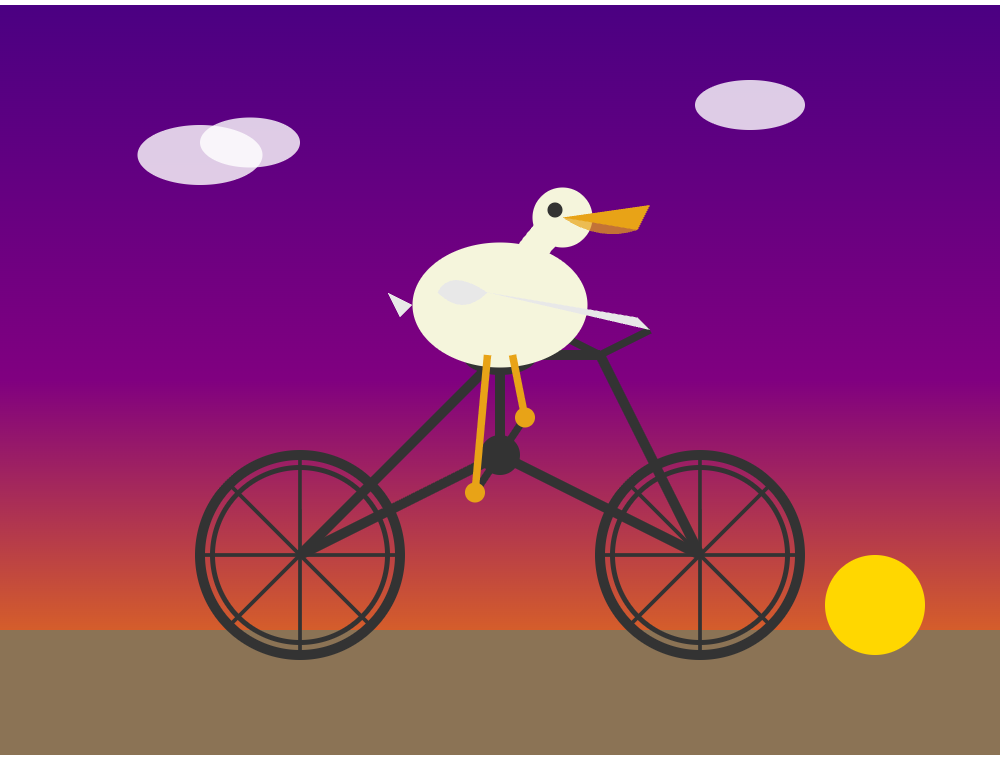
这张图的腿仍很生硬,但脚和踏板已经接上,翼尖伸到了车把,天空也变成黄昏渐变。这个案例中,把原代码和具体坐标集中放进一条新消息,得到了一份执行了修改的结果。
两张图片均由 Strata 生成 SVG 后经浏览器渲染。可以下载 首轮 SVG 和 新会话修改后的 SVG。
长输入触发退出,缩小分块后怎样?
短任务跑通之后,运行项目的官方 benchmark。默认 prefill auto 下,这台机器实际使用的最大分块是 8192;约 4K 和 16K 输入各跑三次,六次都触发 watchdog 中止,引擎退出。watchdog 用来检查执行步骤是否长时间停滞,触发时记录诊断信息并中止引擎。
已有文本先经过 tokenizer 转成 token,随后进入 prefill:逐层处理输入 token,建立后续生成使用的上下文状态。分块大小控制一次处理多少个输入 token;--prefill 256 表示每块最多 256 个,约 4K 的输入会拆成多块依次处理,随后开始生成回答。
把配置 args 中的 --prefill 值改为 256,重启服务后再测,保留相同的模型、量化、上下文和单请求设置。
这轮复测沿用官方 benchmark 的合成输入方式:将 orbit、stone、river、needle 等 20 个英文词重复组成长词表,构造约 4K 和 16K token 的输入,末尾要求模型“用五句话概括词表里有哪些类型的词”。为了观察长输入处理后的首字时间和短段生成,设置 reasoning_effort: none、max_tokens: 64,结果如下。
| 输入规模 | 实际输入 token | 正文输出 token | 首字时间 | 请求结束 | 结束原因 |
|---|---|---|---|---|---|
| 约 4K,第一个样本 | 3939 | 64 | 252.73s | 267.79s | length |
| 约 4K,后续重叠文本 | 3939 | 64 | 6.26s | 15.20s | length |
| 约 16K,部分重叠语料 | 15716 | 64 | 225.87s | 235.10s | length |
三个请求都处理完输入,开始生成词语分类的正文,并在输出第 64 个 token 后结束。响应均为 HTTP 200,流式连接收到结束标记,引擎在这三个样本中持续运行。
实际回答包含对自然、地质、物体等词语的分类。例如 16K 样本先提到 stone、quartz、canyon、river、meadow 等景观词,第三句写到 household or decorative items 时就停止了,五句话的要求尚未完成。记录中的思考内容为空,64 token 都是正文输出;length 表示正文达到本次设置的输出上限。
把 prefill 分块从 8192 改为 256 后,这三个样本都走完了“长输入处理 → 首字输出 → 生成 64 个正文 token”的运行过程。
分块变小后,日志中的驻留专家 RAM 从 18.79GiB 降到 15.28GiB,prefill 借用的 GPU 槽位也从 2812 降到 199。更小的输入块同时改变了这一阶段的内存占用和专家布局。
第二次约 4K 输入的文本主体与第一次大幅重叠,首字时间从 252.73 秒降到 6.26 秒。两次请求的 KV token 复用数都为 0,运行期间保留了系统页缓存和自适应专家策略。
线程停在文件页读取路径
模型的 PLE / n-gram 表按输入 token 和前面的 token 计算行号,再取出对应的向量参与后续计算。这张表约 28.8GB,本机通过 mmap 保留文件映射。访问某一行时,相应文件页若尚未驻留内存,读取会进入文件页加载路径。取行和读表实现
在约 16K 请求中截取一个 30 秒窗口,可以看到 3038 次 major fault、约 359MB 的进程实际存储读取。线程栈停在:
filemap_fault |
同一窗口的来宾虚拟块设备约 103 次读 I/O/s,平均读请求耗时约 9.86ms;四个 GPU 利用率采样点有三个为 0。日志同时显示,这个请求的专家 blob 文件读取为 0。
这个 16K 请求的窗口里,线程在等待文件页,进程持续发生缺页和存储读取,专家 blob 的读取计数为 0。结合 PLE 的查表路径,下一步排查重点落在这张 mmap 表的页访问上。
首字前的等待,时间线上能看到什么?
为了看清等待期间发生了什么,另开一轮带观测的运行:在固定源码上加入可选的主机观测,记录专家执行计划和缓存映射,再与 RAM、显存、CPU / GPU 利用率、磁盘吞吐和读等待对齐。
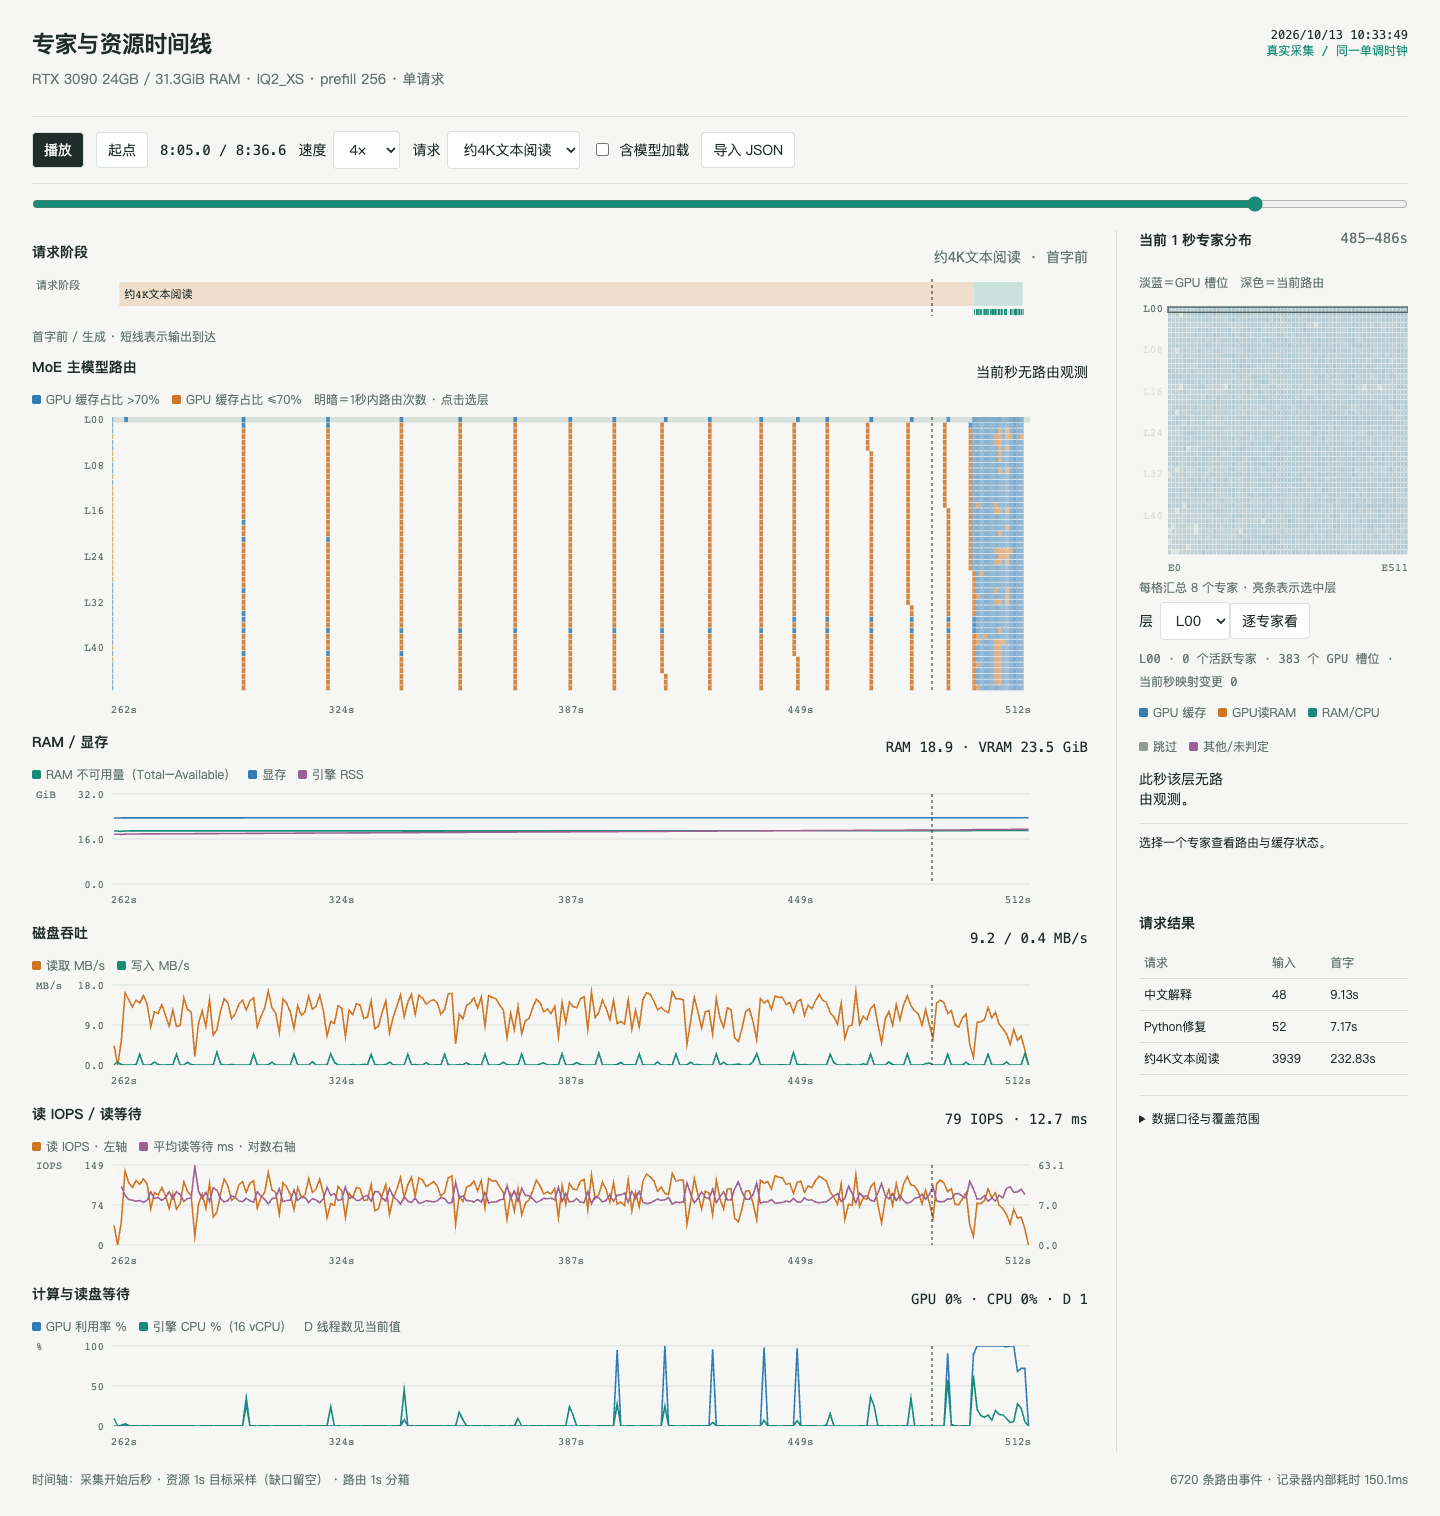
可以打开 专家与资源时间线,选择“约4K文本阅读”,拖动游标看专家分布和资源数值,也可以播放这段记录。这个页面自带数据,下载后能离线查看。
这段记录来自一次带观测的运行,依次执行中文解释、Python 修复和约 4K 输入三个请求,共采集 6720 个路由事件。
横向是采集开始后的时间,纵向是 48 个主模型层,每一列汇总一秒内的事件。蓝色表示选中专家的 GPU 缓存占比超过 70%,橙色表示占比在 70% 及以下;明暗表示选择次数。沿着同一层向右看,可以看到这层在不同时间窗口里的专家选择。右侧再展开该层,查看具体专家编号和缓存状态。
截图选中了“约4K文本阅读”,游标位于采集开始后的 485 秒。此时磁盘读取约 9.2MB/s,平均读请求耗时约 12.7ms,GPU 利用率采样为 0%**,引擎有 **1 个 D 状态线程;这个请求在约 496.49 秒才开始输出正文。
这段 4K 记录呈现了一个首字前的等待现场:磁盘持续读取,线程处于 D 状态,GPU 在该采样点空闲。前面的 16K 请求另采到了文件页等待栈,两段记录都把排查方向指向存储访问。进一步定位 PLE 的耗时,可以在取行和读表处记录时间,再与同一请求的缺页和资源曲线对齐。
这轮实际用起来怎样
短中文对话的首字等待约 7–16 秒,完整回答约 17–46 秒;第三轮的数据纠正保留到了第四轮 JSON。完整 SVG 生成约 70 秒。两次同会话修改各花了约 31 秒,返回原样代码;把原代码和坐标要求放进新会话,约 46 秒得到修改结果。
等待最集中的是本轮第一个长输入:约 4K 词表的首字用了 252.73 秒,整个请求用了 267.79 秒,首字之后约 15 秒生成完设定的 64 个正文 token。对使用者来说,这段时间主要是在等待输入处理后的第一段回答。
这台机器已经可以用来做本地任务实验。下一步计划换成自己的代码和文档,记录完整回答和修改结果,再用同一组任务比较思考模式、内存配置和候选显卡。
数据与复现
测试日期为 2026-10-12 至 2026-10-13。下面保留请求耗时、实际回答、生成的 SVG 和观测回放。
- 脱敏实验摘要:请求耗时、复用量、结束状态和分块复测。
- 长输入复测的实际回答:三次 64-token 正文、思考内容和结束原因。
- 中文多轮对话全文:包含假设题目、纠正过程和实际回答。
- 鹈鹕对话全文:保留两次修改失败、短控制与新会话修改。
- 离线时间线:已采集的专家计划和资源回放。
请求复测脚本包包含流式请求采集脚本、四轮中文题目和鹈鹕对话题目。脚本逐轮传回实际历史,保存完整请求、回答、首字时间、结束原因和服务指标。在服务就绪后,解压脚本包并运行:
python3 run_dialogue.py --out replay-chinese --session chinese \ |
每次复测使用新的 --out 目录。已有会话目录会继续追加历史;运行参数和目录说明见包内 README.txt。
注意
- 环境。 本轮运行在 Linux 虚拟机,CPU 配置为来宾看到的 16 vCPU。块设备统计来自来宾
vda;物理存储后端和宿主机调度情况未采集。来宾没有 swap。RTX 3090 的架构为 SM 8.6,编译产物包含sm_86。 - 版本与安装。 Strata 源码固定在
7695859aa13afb248bdb4d36f9b2e95707db079d。GGUF 与 ModelScope 提供的 SHA-256 一致,下载文件未固定到不可变 revision。本机遇到 Fabric Manager 的 APT 依赖冲突和系统 CMake 3.22.1 版本偏低,最终使用项目内的 virtualenv 和 CMake 构建,保留全局 NVIDIA 包和驱动。 - 请求和计时。 中文、鹈鹕及控制请求共 9 个,每个案例各测一次,结束原因为
stop。这些请求使用标准引擎、prefill 256、thinking none、temperature 0、parallel 1,保留 MTP 和自适应专家策略。客户端在服务端通过 loopback 请求,从请求发出计到首段正文及请求结束;模型加载、截图渲染和事后指标读取另记。 - 长输入复测。 输入为 20 个英文词构成的合成词表,正文上限 64 token,三次均以
length结束,watchdog 沿用默认配置。第二次约 4K 与第一次主体重叠,两次 KV 复用均为 0,系统页缓存保留。默认 benchmark、分块复测和带观测运行各自保留配置与结果。 - 任务结果。 中文排障数据是预设题目。鹈鹕修改用文字反馈和 SVG 代码,视觉功能关闭;新会话同时改变了历史和提示布局。更高精度模型、思考模式和并发的对照留给后续测试。
- 观测范围。 路由事件记录主模型 MMQ prefill 和验证窗口中的主机计划,验证窗口含被拒绝的推测候选。MTP 草稿与旧的单 token 路径未覆盖,CUDA kernel 起止时间未采集。缓存映射变化含槽位借用、归还和自适应替换;资源采样缺口留空。观测数据来自独立的三个请求。
- 作者速度表。 固定版本 README 中,RTX 5070 的 IQ2_XS 数据对应 Ryzen 5 7600、64GB RAM 和引擎 0.1.26;本文使用 RTX 3090、32GB 内存虚拟机和引擎 0.1.43。作者测试条件