上一篇在 RTX 3090 和 32GB 内存上跑起了 Strata,完成了中文对话、SVG 生成和长输入测试。服务可以用了,等待时间却很不均匀:有的回答几秒开始输出,有的输入要等几分钟。
这次沿着一层 MoE 的计算往下看:选中的专家在哪里,CPU 和 GPU 各自处理什么,PCIe 搬哪些数据。理解这条路径后,再看显存、算力和系统内存的取舍,会具体得多。
本文固定使用第一篇的 Strata 0.1.43 源码,运行数据也取自已有实验。
显存里缓存的是什么?
专家是一组执行前馈计算的权重。同一个专家可以处理不同 token,每次使用相同权重和新的输入向量,得到一份新的输出。路由器决定当前 token 使用哪些专家,以及各份输出的合并权重。
本次模型有 48 层,每层 512 个路由专家,每个 token 选出其中 10 个。专家的完整身份是“层号+专家号”;两个不同层里的 17 号专家各有自己的权重。
Strata 在显存中保存一部分专家权重,让 GPU 直接读取。其余专家可以保存在系统内存中,由 CPU 计算,或者经 PCIe 交给 GPU。这次实验的数据布局如下:
左侧是显存:专家缓存与其他模型权重、上下文状态和工作缓冲共同使用这部分空间。右侧是系统内存:保存显存外的专家、CPU 工作缓冲,以及操作系统缓存的文件页。两侧通过 PCIe 传递专家权重、激活与计算结果。
图据固定版本的架构说明与本轮启动日志整理;矩形面积表示分类,容量另见后文实测。
这里有三类容易混在一起的数据:
| 数据 | 保存什么 | 复用方式 |
|---|---|---|
| 专家缓存 | 专家的量化权重 | 后续 token 再选中这个专家时继续读取 |
| 激活与专家输出 | 当前 token 的输入向量和计算结果 | 在本层各条计算路径间传递、合并 |
| KV 等上下文状态 | 已处理文本的上下文信息 | 后续生成或前缀复用时使用 |
因此,专家缓存命中率与前缀 token 复用率回答的是两个问题。缓存了专家,仍要用当前 token 的输入重新计算。
路由以后,专家怎样分工?
先看正常执行的三条路径。
第一条:权重已经在显存。 调度器查到槽位,GPU 使用该地址计算。这个专家本轮无需从 RAM 搬入权重。
第二条:权重在 RAM,由 CPU 计算。 GPU 侧产生的激活交给 CPU,CPU 读取本地专家权重,计算 gate/up、激活及 down 投影,再把输出交回 GPU。PCIe 主要传递这一批 token 的激活和结果,权重留在 RAM。少量 token 下,这些向量通常远小于整份专家权重。
第三条:权重在 RAM,搬给 GPU 计算。 引擎把专家 blob,也就是整理好的量化权重块,放进 GPU 暂存区,随后执行专家 kernel。这条路径消耗 PCIe 带宽,同时减轻 CPU 的专家计算负担。
各条路径得到的都是专家输出向量。GPU 把属于同一个 token 的结果对应起来,分别乘以路由器给出的权重并求和,再加上经过门控的共享专家贡献。
例如,同一个 token 的两个专家分别由 CPU 和 GPU 计算,合并时会取回两份结果,分别乘上各自的路由权重。共享专家使用同一输入产生另一份贡献,最终相加得到 MoE 模块输出,交给本层后续计算。
图中展开的是数据依赖和数学操作;实际 kernel 可以融合部分步骤。GPU 在使用 CPU 结果前等待其就绪,共享专家的计算也可以与路由专家重叠。源码对应调度与结果位置、GPU 等待与合并。
分工时,Strata 会先把同一层、同一验证窗口中重复出现的专家合成一组。例如三个 token 都选中专家 17,就形成一个专家组,里面记录三个输入和三个输出位置。走 PCIe 路径时,这份权重可以搬一次、用于多个 token;CPU 路径也能在读取权重行后连续计算这几个输入。
pcie_frac 控制交给 GPU 的一部分未命中专家。源码先统计去重后的未命中专家,再按比例选择其中一部分,并检查源数据是否已锁页、暂存容量是否足够。因此,“一半未命中专家交给 GPU”描述的是调度对象的数量,实际字节数和耗时还取决于专家大小与 token 分布。
CPU 怎样把剩下的专家算完?
当大部分访问命中显存时,留给 CPU 的专家可能只有几个。如果一个专家只交给一个线程,其他核心就容易闲着。
ExpertPool 把专家矩阵按行拆开,让多个工作线程共同计算。一行权重与输入向量做点积,得到输出中的一个分量;不同行对应不同分量,可以分给不同线程。每个线程读取自己负责的权重行,并使用相应 token 的输入向量。
图中用两个线程、八行权重和三个 token 举例。两个线程各处理一段行,每行连续用于 A、B、C 三个输入,分别写出三个 token 的结果。实际实现把行范围做成任务,由工作线程领取;任务范围也可以跨越专家边界。
一个专家的计算继续分为三个阶段:先算 gate/up 并形成中间激活,再把中间激活量化成后续 kernel 使用的格式,最后按行并行计算 down 投影。阶段之间等待所需结果就绪,各 token 始终保留自己的激活与输出。CPU 工作池接口、行任务与多 token 阶段
这里有两份收益:行拆分让少量专家也能使用多个核心;多 token 分组让已经读入的权重行服务更多输入,摊薄权重读取成本。乘加计算仍按各自输入执行,分组越大,激活缓冲和计算量也会增加。
调度器先发布 GPU 的计算计划、启动需要的搬运,再做 CPU 自己的工作。GPU 于是可以在 CPU 计算期间处理显存中的专家。到合并位置,两边需要的结果都准备好,这一层才能继续。
这解释了为什么 CPU 型号和内存带宽会影响 Strata 的输出速度。CPU 分到的工作偏多时,GPU 可能先算完并等待;PCIe 分到的工作偏多时,等待可能转到搬运与 GPU 计算这一侧。
为什么 PCIe 份额从 0.49 调到 0.60?
自动分配想解决的是两条路径的速度差:PCIe 路径处理得快,就多交一些未命中专家给 GPU;CPU 池处理得快,就多留一些在 RAM 中计算。显存已经命中的专家继续由 GPU 处理。
本次日志里的调整分两步。启动时,链路探测约 17.9GB/s。本次 native pack 的初始份额基准是 0.55,代码按照链路探测值相对 20GB/s 的比例缩放,得到 0.55 × 17.9 / 20 ≈ 0.49。
开始 decode 后,引擎再测 CPU 池的实际处理时间。本轮记录每个未命中专家任务约 243μs,按专家字节量折算成约 5.9GB/s 的处理速率。这个数包含专家计算的耗时,用于估计 CPU 能承担多少工作。
然后代码用下面的规则更新份额:
候选份额 = PCIe 速率 /(PCIe 速率 + 1.85 × CPU 等效处理速率) |
因此日志出现了 pcie_frac 0.60 (was 0.49)。公式里的 1.85 是作者用几台机器拟合的经验系数,20GB/s 是初始规则的缩放基准。最终的 0.60 表示调度器尝试把约六成去重后的未命中专家分给 PCIe 路径;实际分配还要满足锁页、暂存容量等条件。初始值与自动分配实现
这项调整会先积累观测。源码首次至少等 48 个验证窗口,并要求足够的未命中任务样本;后续调整至少再隔 96 个窗口,最多更新三次。它用有限采样估计一个可用比例。比较硬件时,可以先固定比例看工作如何转移,再测默认自动策略下的完整任务耗时。
哪些专家能长期留在显存?
ExpertCache 维护一张驻留表:用“层号+专家号”查到显存槽位,未驻留时返回特殊值。槽位保存权重,驻留表告诉调度器该去哪里取。
空槽的填入和已满缓存的替换由不同代码负责。admit() 只接收尚有空间的专家;缓存满后,它返回未驻留。运行期间的替换由上层自适应策略完成。缓存准入
自适应策略累计每个专家被路由到的次数,并定期衰减历史热度。在同一层内,它把显存外的热专家与显存内的冷专家配对,只有热度差达到阈值才安排交换。每轮还限制交换数量,控制额外搬运。热度与候选配对
例如,同一层里显存外专家 A 的热度为 10,显存内专家 B 为 8,热度差为 2。源码默认阈值是 1.5,这一对可以进入交换候选;所有候选再按热度差排序,受每轮默认最多 96 次交换的限制。一次调整结束后,旧热度乘以默认衰减系数 0.7,之后的路由继续累加。这样,最近持续被选中的专家逐渐获得更高优先级。这组 10 和 8 是说明规则的例子,参数默认值来自配置定义。
交换时还要处理数据的有效期。新权重复制完成以后,驻留表才能把它标为可用;复用旧槽位前,要保证先前的计算已经结束对该槽位的读取。本次采用的 resident RAM 模式,还会把移出的专家交回 RAM,使 CPU 后续能继续使用它。交换与就绪发布
这套策略适合存在持续热点的负载:搬进来的专家在随后多次路由中复用,交换成本被摊薄。话题和任务快速变化时,热点也会变化,缓存需要一段时间跟上。显存增加能容纳更多热点,实际收益取决于新增槽位覆盖了多少后续访问。
已经有 KV cache,专家缓存还省什么?
KV cache 对连续生成很有用:它保存注意力层已经算出的历史 token 的 Key 和 Value。处理下一个 token 时,模型计算这个新位置的 Q/K/V,读取历史 K/V 完成注意力,再把新位置的 K/V 保存下来。这样,每一步都能沿用此前的计算状态。KV cache 的工作方式
专家缓存则保存专家权重。新 token 经过注意力或其他序列混合层后,产生新的输入向量,再由路由器选择专家并执行计算。即使它和上一个 token 选中同一专家,输入也已经改变,需要用缓存里的权重算出新的结果。
可以把连续生成中的两种复用并排看:
| 问题 | KV cache | 专家缓存 |
|---|---|---|
| 保存什么? | 这段上下文已经计算出的 K/V 状态 | 模型中固定的专家权重 |
| 下一步省在哪里? | 复用历史位置的状态,避免重新计算历史 K/V | 直接读取显存中的专家权重,减少显存外路径的工作 |
| 新 token 还做什么? | 计算自己的状态,并读取历史状态做注意力 | 根据自己的路由和输入执行专家计算 |
| 容量受什么影响? | 上下文长度、KV 格式、层结构与会话数 | 专家格式、显存预算与热点分布 |
再往上还有前缀复用:下一轮请求带着相同的对话前缀时,引擎从保留的状态或匹配的检查点继续,只处理新增部分。命中的那段前缀就能省下再次 prefill 的工作,其中也包括这段文本原本需要做的 MoE 计算。Strata 会核对前缀 token 和图片是否匹配;本次模型还有 DeltaNet 等运行状态,会话恢复需要与这些状态配合。会话缓存与检查点
所以,长文档反复提问、多轮对话,前缀复用可能明显缩短首字等待;新输入和新生成的 token,仍然受专家缓存与 CPU/GPU 分工影响。第一篇的四轮中文对话中,后续请求报告了前缀复用;三次合成长输入复测报告的复用量均为零,重复文本第二次变快时,应继续检查专家热度、文件页等状态。
两类缓存还共同占用显存。本次固定 32K 上下文、KV int8;调整上下文容量或 KV 格式,会改变专家缓存可获得的空间。比较显卡时把这些设置固定,才能看清多出的显存究竟给了哪一部分。
PCIe 搬运怎样与计算重叠?
decode 验证路径把显存命中组和 PCIe 组分开。GPU 先处理已经驻留的权重;需要搬运的组在数据就绪后计算;CPU 输出也有自己的就绪标志。这个组织方式给了搬运和计算重叠的机会,同时保留各阶段的数据依赖。
长输入的 prefill 使用另一套更适合批量处理的流程:把输入拆成块,每层按专家聚合 token,并用循环暂存槽提前搬入后续专家。下面用 A、B、C 三个专家工作单元和两个暂存槽,画出逐组串行与流水线执行的区别。横轴向右表示推进顺序,所有块长均为机制示意。
锁页内存里的权重可以直接提交异步 H2D 复制。未锁页的数据先由主机工作线程放入锁页缓冲,再提交复制。复制流记录 copied 事件,计算流在读取槽位前等待它;槽内数据消费完成后记录 used,下一次覆盖这个槽位前等待 used。prefill 暂存实现
沿时间轴看,A 复制到槽 0 后,GPU 开始读取它;复制流同时把 B 搬进槽 1。图中的淡绿色竖带,就是“计算 A”与“复制 B”同时推进的区间。等 GPU 轮到 B,B 的权重已经就绪。
图中展开了先 gather 的路径:GPU 把 A 的权重从暂存槽 0 读入计算缓冲,随即记录 used A。后面的 A 计算继续使用计算缓冲,复制流便能让 C 覆盖槽 0。两个槽位轮换,把后续权重准备放到当前计算期间。
上方的串行参考把每次复制与计算依次排开,下方把可独立执行的部分重叠起来。收益来自减少空等:各阶段都有工作可做时,流水线持续出结果的速度主要受较慢阶段限制。若下一组权重还没准备好,或者槽位仍在使用,复制或计算仍会等待;实际节省的时间需要用 GPU trace 测量。
粗略估算一轮专家搬运,可以把被交给 GPU 的去重专家 blob 大小相加,再除以实际可用的 H2D 带宽。实际耗时还包括提交、等待、锁页缓冲准备,以及 CPU/GPU 对主机内存带宽的共同占用。
本文机器用 CUDA 12.8 构建,上述复制采用逐 blob 的 cudaMemcpyAsync。源码还有 CUDA 13 起可编译的批量复制分支,但本机使用的是前一种实现。DMA 辅助代码
prefill 分块为什么会改变内存占用?
较大的输入块能把更多 token 按专家分组,提高一次权重读取的复用次数;同时也要为这些 token 的激活、路由、分组和中间结果准备更多工作空间。Strata 的 prefill 会临时借用部分专家缓存槽位,给这一阶段使用。
在第一篇的同一台机器上,将最大分块从 8192 改为 256 后,启动日志记录了下面的变化:
| 项目 | 默认分块 8192 | 分块 256 |
|---|---|---|
| 驻留专家 RAM | 18.79GiB | 15.28GiB |
| prefill 借用的 GPU 槽位 | 2812 | 199 |
| 长输入运行记录 | 4K、16K 各三次 watchdog 中止 | 两次 4K、一次 16K 均生成到 64 token 上限 |
更小的分块减少了本次配置需要保留的专家 RAM 副本与借用槽位,长输入进入了输出阶段。它也增加了处理同一段输入所需的块数。最合适的块大小,要同时看工作空间、专家权重复用和请求完成时间。
prefill 也能把一部分专家工作交给 CPU。源码会检查 RAM 余量,并在适用路径中用测得的 CPU/GPU 耗时调整份额。本轮启动日志确认小于 1024 token 的块启用了 CPU share。内存条件、份额调整
一次验证为什么能处理多个 token?
服务只有一个在途请求时,内部仍可以同时验证多个候选 token。MTP 先提出后续候选,主模型再用一个验证窗口检查,接受符合验证规则的部分,然后继续下一轮。
这给专家分组提供了更多复用机会:几个候选命中同一专家,便可以共用一次权重读取或搬运。每轮接受的 token 越多,主模型一次验证的成本就能摊到更多最终输出上。推测解码说明
候选生成和被拒绝的计算也占时间。本次独立观测的 4K 请求,日志记录草稿接受 26/51,随后生成 64 token 的 decode 阶段用了约 13.24 秒。这组数字说明应同时记录接受情况和实际输出耗时。MTP 开关的净收益,需要同一任务的开关对照来测。
还有一条会改变输出的路径:跳过尾部专家
核对调度器时,可以看到 STRATA_ROUTE_TAIL_SKIP:它把符合条件的一部分专家贡献设为零,从而减少计算和搬运。
在本次单卡验证路径中,默认值为 7。源码用从零开始的排名:如果一个未命中显存的专家,在当前窗口内所有选中它的 token 中,都只排在第 8–10 位,就满足跳过条件。只要有一个 token 把它排进前七,便保留计算;已经驻留显存的专家也保留。跳过以后,其他专家仍使用原路由权重,合并时不重新归一化。跳过条件与输出置零
本轮启动日志明确记录了 STRATA_ROUTE_TAIL_SKIP=7 is ON (default),请求结束时也记录了实际跳过的计数。这是本机已经走到的执行分支。
少算这些专家,会付出什么代价?
这是用近似计算换速度。假设同一层、同一个输入原本得到 共享贡献 + Σ wᵢ·Eᵢ(x),跳过一组专家后,结果的变化就是:
跳过后的输出 − 完整输出 = −Σ 被跳过专家的 wᵢ · Eᵢ(x) |
第 8–10 位表示路由权重在这次选择中排名靠后,实际删去的是“权重乘以专家输出”的向量。贡献大小还取决于输出向量的幅度和方向;代码按排名判断,没有为每次跳过计算误差上限。
这份差异会进入后续层,可能改变后续路由和最终 token 概率。当两个候选 token 的概率很接近时,小幅变化就可能改变选词;生成路径改变以后,后续回答也会继续分叉。代码、数字、约束条件等任务,需要直接检查最终结果是否正确。
MTP 的验证过程也使用这条专家执行路径:候选接受与否,是相对于启用了跳过的主模型计算结果来决定的。因此,验证通过的候选仍可能与关闭跳过时的输出不同。
作者测到了多大的影响?
作者在 28 个包含代码、推理、多语言聊天和长文摘要的提示上,固定参考 token 序列,比较每个位置的输出分布。每组约 6000 个计分 token;RTX 3060 / IQ3_XXS 与 RTX A4000 / Q2_0 的首选 token 一致率约 **97.5%–98.2%**。这个指标说明逐位置的首选 token 已发生变化;完整任务质量另外用代码和推理题检查,文档中的小规模任务测试尚未形成稳定的优劣结论。作者质量对照
速度也可能受反作用影响。作者记录了一个高缓存覆盖的 V100 32GB / Coder IQ1_M 案例:草稿接受率从 **70.1% 降到 68.2%**,decode 反而慢约 **1%–2%**。少算专家节省的时间,被接受率下降带来的额外验证开销抵消。该版本因此在单卡缓存覆盖达到默认 90% 阈值时,默认关闭尾部跳过。对应默认策略与案例
这些是作者在其他硬件和量化上的结果。本机已经确认开关生效,开关对照的质量与速度测试仍待完成。
硬件比较怎样固定这项条件?
它把速度与模型计算方式联系了起来。即使使用相同模型文件和量化,显存容量不同,也可能让同一个专家在一张卡上命中、在另一张卡上被跳过;输出差异就多了一个来源。该版本还会根据缓存覆盖情况决定是否默认启用这一策略。默认启用条件
因此,后续比较 5060 Ti 16GB 与 5070 12GB,可以先用 STRATA_ROUTE_TAIL_SKIP=0 建立统一的计算条件,再各自测默认设置下的速度和答案质量。CPU/GPU kernel 的数值舍入、prefill CPU share、量化和采样设置也一起记录。
在同一张卡上评估这个开关时,固定题目、模型、量化及其他参数,用新引擎分别运行 =0 与 =7,交错重复多轮。一起记录代码测试通过率、事实与数值准确性、指令完成情况,以及首字时间、完整耗时、MTP 接受率和实际跳过数。任务达成情况与耗时共同决定是否启用。
上一篇里对话的诊断推断偏强、两次 SVG 修改返回原图,都保留为任务结果。定位这些结果的来源,需要分别控制量化、跳过策略和提示词布局,逐项对照。
再看那次 GPU 空闲和磁盘等待
第一篇的 MoE 时间线来自一轮独立观测。启动日志显示,GPU 专家缓存占约 18.00GiB、13432 个槽位,RAM 中保留 15.28GiB 的锁页专家补集。运行时,这两部分通过交换保存需要的专家。
其中 3939-token 输入的请求,decode 日志报告 93.5% 命中率,36572 hits / 39106 lookups,另有 1479 次路由访问交给 PCIe 路径。这个命中率的分母取自代码中的特定计数:PCIe offload 和被跳过的项另行统计。读日志时,把这几组数字一起看,才能理解 CPU、GPU 和跳过分支各分到了什么。计数口径
同一请求的输入处理阶段持续约 232.79 秒。在首字前约 485 秒的时间线位置,资源采样记录 GPU 利用率 0%、磁盘读约 9.2MB/s、平均读请求耗时约 12.7ms,以及 1 个 D 状态线程。
这台机器还有一条独立的数据访问路径:约 28.8GB 的 PLE / n-gram 表。启动时,引擎发现 direct 读取探测偏慢,自动选择 mmap,由操作系统文件缓存保存读入的页。请求需要的页尚未在 RAM 时,执行线程就可能等待存储读取。
4K 请求结束时,专家 blob 文件读取计数为零,进程的存储读取计数仍增加约 2900.5MB。另一次 16K 采样记录到 filemap_fault → wait_on_page_bit_common,说明那一轮执行确实在等文件页。这让后续排查有了两个明确对象:专家计算与搬运,以及 PLE 等映射文件的页面读取。后者应继续用文件与偏移的归属追踪来定位。
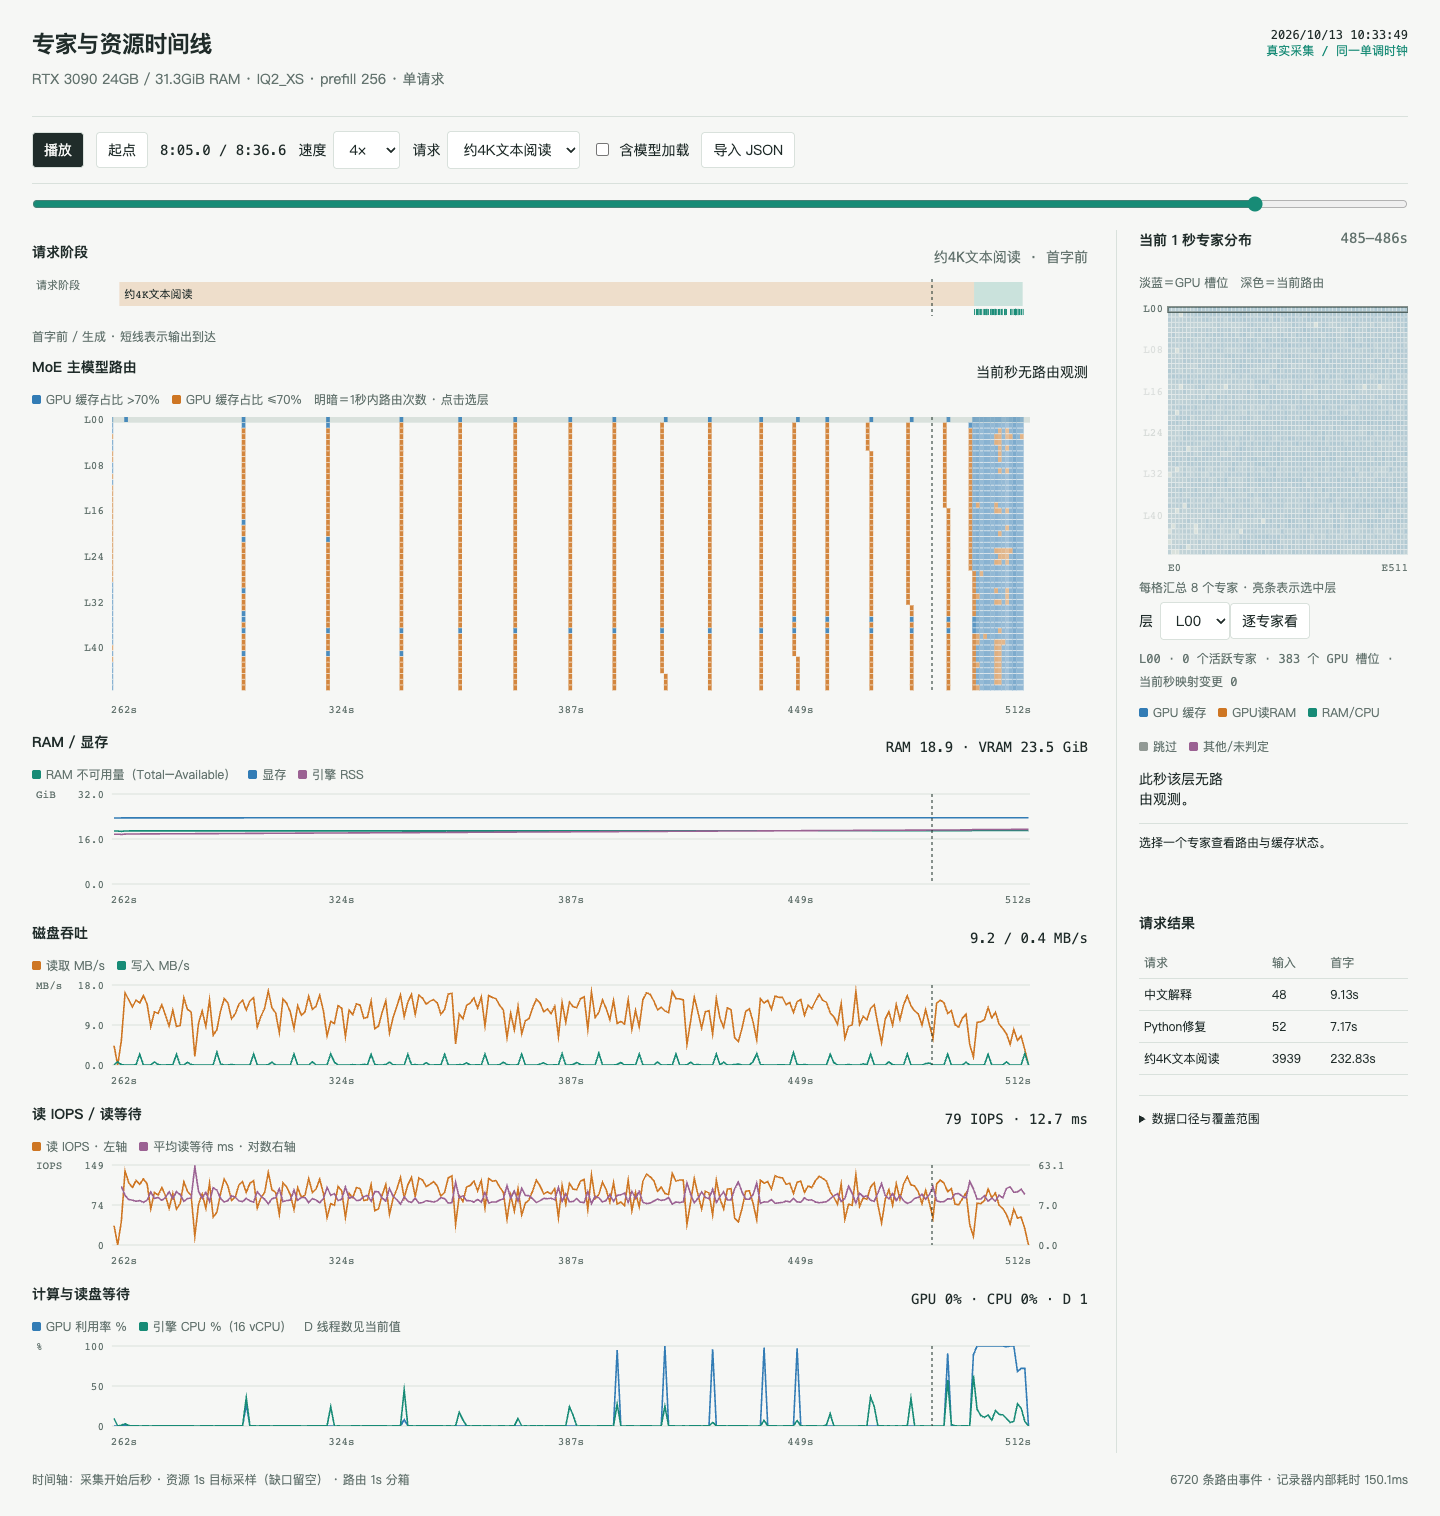
图中横轴为采集开始后的秒数,上方展示路由与缓存分布,下方展示 RAM、显存、CPU/GPU 和存储负载。可以打开交互时间线,对齐请求区间查看。路由图中的主机计划事件帮助定位阶段;具体 kernel 的运行和等待还需要 GPU trace。
多 4GB 显存与更强算力,下一步怎样比较?
现在可以把取舍落到实际工作量上。
| 增加的资源 | 可能减少的工作或等待 | 最有用的观测 |
|---|---|---|
| 显存 | 更多专家驻留,减少 CPU 工作、权重搬运及热点交换;给上下文与工作缓冲留空间 | 槽位与路由分布、CPU 专家耗时、PCIe 字节量、完整请求时间 |
| GPU 算力与显存带宽 | 缩短 GPU 上的专家、注意力等计算 | GPU kernel 时间、计算间隙、prefill 与 decode 分段耗时 |
| CPU 与内存带宽 | 更快完成 RAM 中的专家工作和主机缓冲准备 | CPU 池耗时、每组 token 数、CPU 调度和内存带宽 |
| 系统内存与存储能力 | 保存专家补集、文件页与运行缓冲,缩短文件页等待 | MemAvailable、major fault、读延迟、等待线程及文件归属 |
这些收益取决于当前请求在等哪一段。更多显存覆盖到经常访问的专家,收益会反复出现;如果新增槽位装的是很少访问的专家,收益就小。更强 GPU 在计算占主要时间时更有价值。线程正在等文件页时,应先看 RAM 与存储路径。
量化也影响这张表:更小的专家 blob 能提高缓存容量、减少 RAM 和 PCIe 字节量,同时改变数值精度与所用 kernel。评估时把答案的正确性、修改是否完成、首字时间和完整耗时放在一起。
下一轮计划使用同一份代码修改、中文问答和文档问答,输出预算以任务完整结束为准。先固定版本、量化、上下文、分块、MTP 与尾部跳过设置,再分别改变专家缓存预算和 PCIe 份额;冷启动与重复请求分别记录。它能先回答“减少显存缓存之后,工作移到了哪里”。两张实体显卡的最终差异,再由相同负载实测。
注
- 版本与架构。 本文源码固定在
7695859aa13afb248bdb4d36f9b2e95707db079d,版本 0.1.43。实验是 RTX 3090、SM 8.6,构建产物包含sm_86,CUDA 工具链 12.8.93。选卡时核对引擎 kernel 支持和实际构建目标。 - 运行条件。 Linux 虚拟机,16 个来宾 vCPU、32GB 级别 RAM、无 swap;原版 Qwen3.8-Flash-Next IQ2_XS,32K 上下文、KV int8、单请求、关闭思考。本文聚焦这条单 GPU 路径;源码同时存在其他后端和多 GPU 分支。
- 搬运实现。 验证路径还支持 GPU 直接读取映射的主机权重,以及图内 copy kernel 暂存。本文主图展开常规 DMA 路径;各模式的可用性由平台、数据源和配置共同决定。
- 实验范围。 本文新增的是源码核对与已有日志解读。分块复测、4K 时间线和 16K 线程栈属于不同轮次;三个长输入复测均使用合成词表与 64-token 输出上限。缓存、PCIe 份额、MTP 与尾部跳过的控制变量测试列为下一轮计划。
- 图和计数。 机制图展示数据位置与依赖,未赋予虚构的时间比例。实测时间线采集主模型 prefill 和验证窗口中的主机计划,包含被拒绝的候选;未覆盖 MTP 草稿和旧单 token 路径。缓存映射变化还包含借用与归还,资源采样缺口保留为空。
附:本次分析的脱敏日志摘录、固定源码文件与校验清单。第一篇的任务回答、测试方法与复测附件继续作为实验记录。