最近看了 Gregory Price 的 CRAM(Compressed RAM Service)介绍。Linux 已经有 zram,为什么还需要一套压缩内存管理机制?先读作者的设计说明,会发现两者提供给 Linux 的抽象不同:zram 是压缩 RAM 块设备,CRAM 则管理仍能按地址访问的硬件压缩内存。
因此,需要比较的不只是压缩算法。一个页进入压缩层后,是否还保留映射?读一下是否就必须恢复到普通内存?写入导致压缩率下降时,内核怎样保证设备的物理容量不会耗尽?这些问题决定了读写路径,也决定了成本出现在哪一步。
本文先对照作者 RFC 和 zram 官方文档说明设计,再用固定内核、固定 QEMU 的 trace 和模拟数据检查实际行为。
先读哪些设计材料?
| 一手材料 | 阅读重点 |
|---|---|
| Gregory Price:RFC v4 总说明,Private Memory Nodes (w/ Compressed RAM) | Background、Core Proposal: N_MEMORY_PRIVATE、Application: Compressed RAM:为什么隔离分配,为什么限制写入 |
| RFC v4 第 23 个补丁:mm/cram 子系统 | 迁入、写保护、写 fault 提升,以及设备压力如何驱动回收 |
| LPC 2026:A Compressed RAM Service | 硬件压缩内存的直接访问模型,及只读层的访问路径 |
| Linux 官方文档:zram | 块设备用途、配置、逻辑大小与实际 RAM 占用 |
设计说明采用作者 2026-02-22 发布的 RFC v4 和后续 LPC 演讲;实验版本见后面的环境表。
zram 是什么:普通 RAM 中的压缩块设备
zram 创建 /dev/zram0 这样的块设备。写入设备的数据被压缩,压缩表示保存在普通 RAM 中。块设备可以作为 swap 后端,也可以用于文件系统等用途;因此,“zram 就是 swap”并不准确。zram 官方文档
本轮把它用作匿名页的 swap 后端:原来的普通页换出后,PTE 表示 swap entry;应用再次访问尚未恢复的页时,要通过 swap fault,把内容读回、解压到普通页,再恢复映射。CPU 不能把匿名页的 PTE 直接指向 zram 的压缩对象,按原地址读取其中某个字节。后面的 trace 用来验证这条访问链。
页换出:普通页 → swap-out → 压缩对象保存在 zram |
这里的容量也要分开看。disksize 是逻辑设备大小,不是已经增加的物理 RAM;compr_data_size 是压缩数据大小,mem_used_total 才包含分配器及元数据等实际内存开销。能节省多少 RAM 取决于数据和压缩效果,不能把逻辑 swap 容量直接算成新增可用内存。zram 容量与统计说明
这些值从 sysfs 读取。disksize 是独立文件;compr_data_size 和 mem_used_total 是同一行 mm_stat 输出中的字段,不是两个独立文件:
cat /sys/block/zram0/disksize |
| mm_stat 列号 | 字段 | 含义 |
|---|---|---|
| 1 | orig_data_size |
已存数据的未压缩大小 |
| 2 | compr_data_size |
已存数据的压缩大小 |
| 3 | mem_used_total |
为该设备分配的实际内存,包含分配器碎片及元数据开销 |
如果使用的是 zram1,将路径中的 zram0 换成 zram1。这些值描述当前存储的数据与内存占用,逻辑设备容量仍读 disksize。
CRAM 是什么:硬件压缩内存的内核管理层
作者描述的设备提供 cacheline / byte 级访问。数据以压缩形式存储,但 CPU 仍能通过地址访问它,设备在硬件路径中处理压缩表示。因此,页可以保留页表映射,读取不必先经过软件 swap-in。作者 LPC 说明
要区分两个层次:硬件提供压缩和可寻址访问,CRAM 提供页的分配、迁移与压力管理。 CRAM 不是一种压缩算法,也不能理解成“把 zram 的软件解压换成硬件解压”就结束了。
受控迁入:普通页 → 迁移到 CRAM → 保留 present、只读映射 |
这里“读不 fault”指读取时无需先通过 swap fault 恢复这个压缩页。
压缩后的数据,CPU 怎样读取?
设备对外提供可寻址的内存空间,对内保存压缩数据。CPU 执行普通 load,设备在读取路径上透明解压,返回 CPU 所需的原始数据。下面画的是 cache 未命中、需要访问设备的路径:

“直接读”表示应用继续通过原地址访问,省去软件 swap-in 和把整页恢复到普通 DRAM 的步骤。 硬件解压和设备访问仍有耗时;设备内部的压缩块与解压粒度取决于具体实现。若数据已在 CPU cache 中,这次 load 可由 cache 提供,无需访问设备。作者 LPC 的设备访问说明
这也解释了两种方案的区别:CRAM 设备返回读取所需的数据,页仍可留在设备;zram swap 则由内核把整页读回并解压到普通 RAM,再让应用完成访问。本文的 QEMU 模型用 RAM 后备,验证的是映射和 fault 路径,图中的硬件解压动作描述真实压缩设备的工作方式。
Why CRAM:可寻址之后,怎样保证容量安全?
作者 RFC 的核心问题是:压缩设备的逻辑容量可能大于物理容量,而可压缩性会变化。例如一个物理容量为 1 TB 的设备暴露更大的地址空间,能否装下数据取决于内容;这个例子不意味着任何固定容量倍率。任意改写可能使压缩数据膨胀,单靠后台回收追赶写入速度,无法保证始终有足够后备空间。RFC 的容量问题说明
RFC 采用保守的只读层设计,把控制放在三个位置:
| 控制 | 做法 | 目的 |
|---|---|---|
| 分配 | N_MEMORY_PRIVATE 私有 NUMA node 排除普通分配路径,服务受控迁入页 |
避免普通分配绕过设备容量管理 |
| 写入 | 到达后写保护;写 fault 先提升回普通 DRAM | 避免应用直接改写压缩层,导致无法控制的容量膨胀 |
| 设备压力 | 驱动报告压力,限制新迁入并驱动回收,必要时换出到 swap | 释放设备空间并让系统继续处理内存压力 |
私有 node 仍使用普通 struct page / folio,并复用内核分配和迁移设施。mm/cram 在这些设施与设备之间接入 migrate_to、handle_fault、reclaim_policy 等管理动作。RFC 总说明、第 23 个补丁说明
因此,首次写提升是这个版本主动选择的容量安全策略,不是“所有压缩内存在物理上都不能直接写”。RFC 把放宽只读约束列为未来方向,没有在该提案中实现。CXL 是作者使用的设备接入方式,CRAM 的管理抽象本身也不要求永远只服务 CXL。RFC 的未来设计与讨论
把两者放在一起,差异就清楚了:
| 问题 | zram,作为本实验的 swap 后端 | CRAM,只读层设计 |
|---|---|---|
| 内核面对的抽象 | 压缩 RAM 块设备上的 swap 对象 | 私有 NUMA node 上的可映射页 |
| CPU 能否按原地址直接读压缩层 | 不能,需先恢复普通页 | 可以保留读映射 |
| 冷页首次读 | 恢复页,回到普通内存 | 可以继续留在压缩层 |
| 冷页首次写 | 先恢复原页内容再写 | 写保护 fault,先提升回普通内存 |
| 主要管理问题 | 压缩对象的 RAM 占用、块 I/O 与 swap 恢复 | 可变物理容量、受控迁入、写入提升和设备压力 |
这个设计最值得验证的收益,是冷页读过以后仍能留在CRAM 压缩内存;代价是首次写仍有提升成本。它是否适合某个业务,需要看冷页占比、读写比例、内存压力和真实设备访问成本。
作者在 LPC 演讲里有一张访问路径图,可以先用它建立直觉:
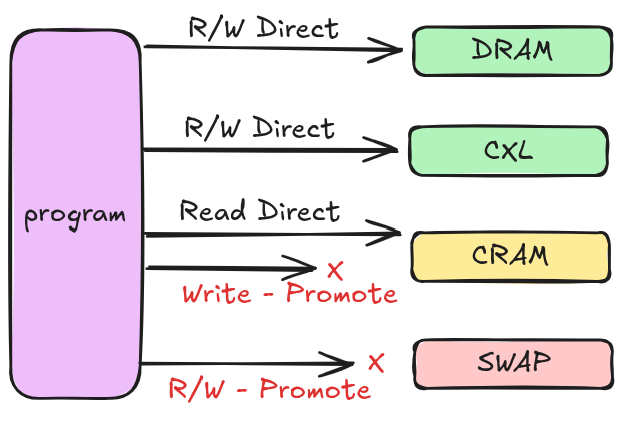
图源:Gregory Price(Meta),LPC 2026《A Compressed RAM Service》,第 7 页 “Write Control”。原图提取,未改动。
图里的普通 CXL 内存可以直接读写;CRAM 是受控的压缩内存层,可以直接读,写时要先把页提升到普通内存。swap 的读写则都需要先恢复页。图中的红叉表示不能直接按这条路径完成访问,不表示应用不能写入。下面用 trace 检查这些箭头在实验内核里对应哪些动作。
读过以后,页到底存在哪里?
先把问题缩小到一个 4 KiB 匿名页。把它放入目标层后,读取偏移 0 的 8 字节,再检查页位置和 fault 路径。
把同一个页按“进入目标层 → 首次读 → 随后首次写”展开,会比先看函数名更容易理解:
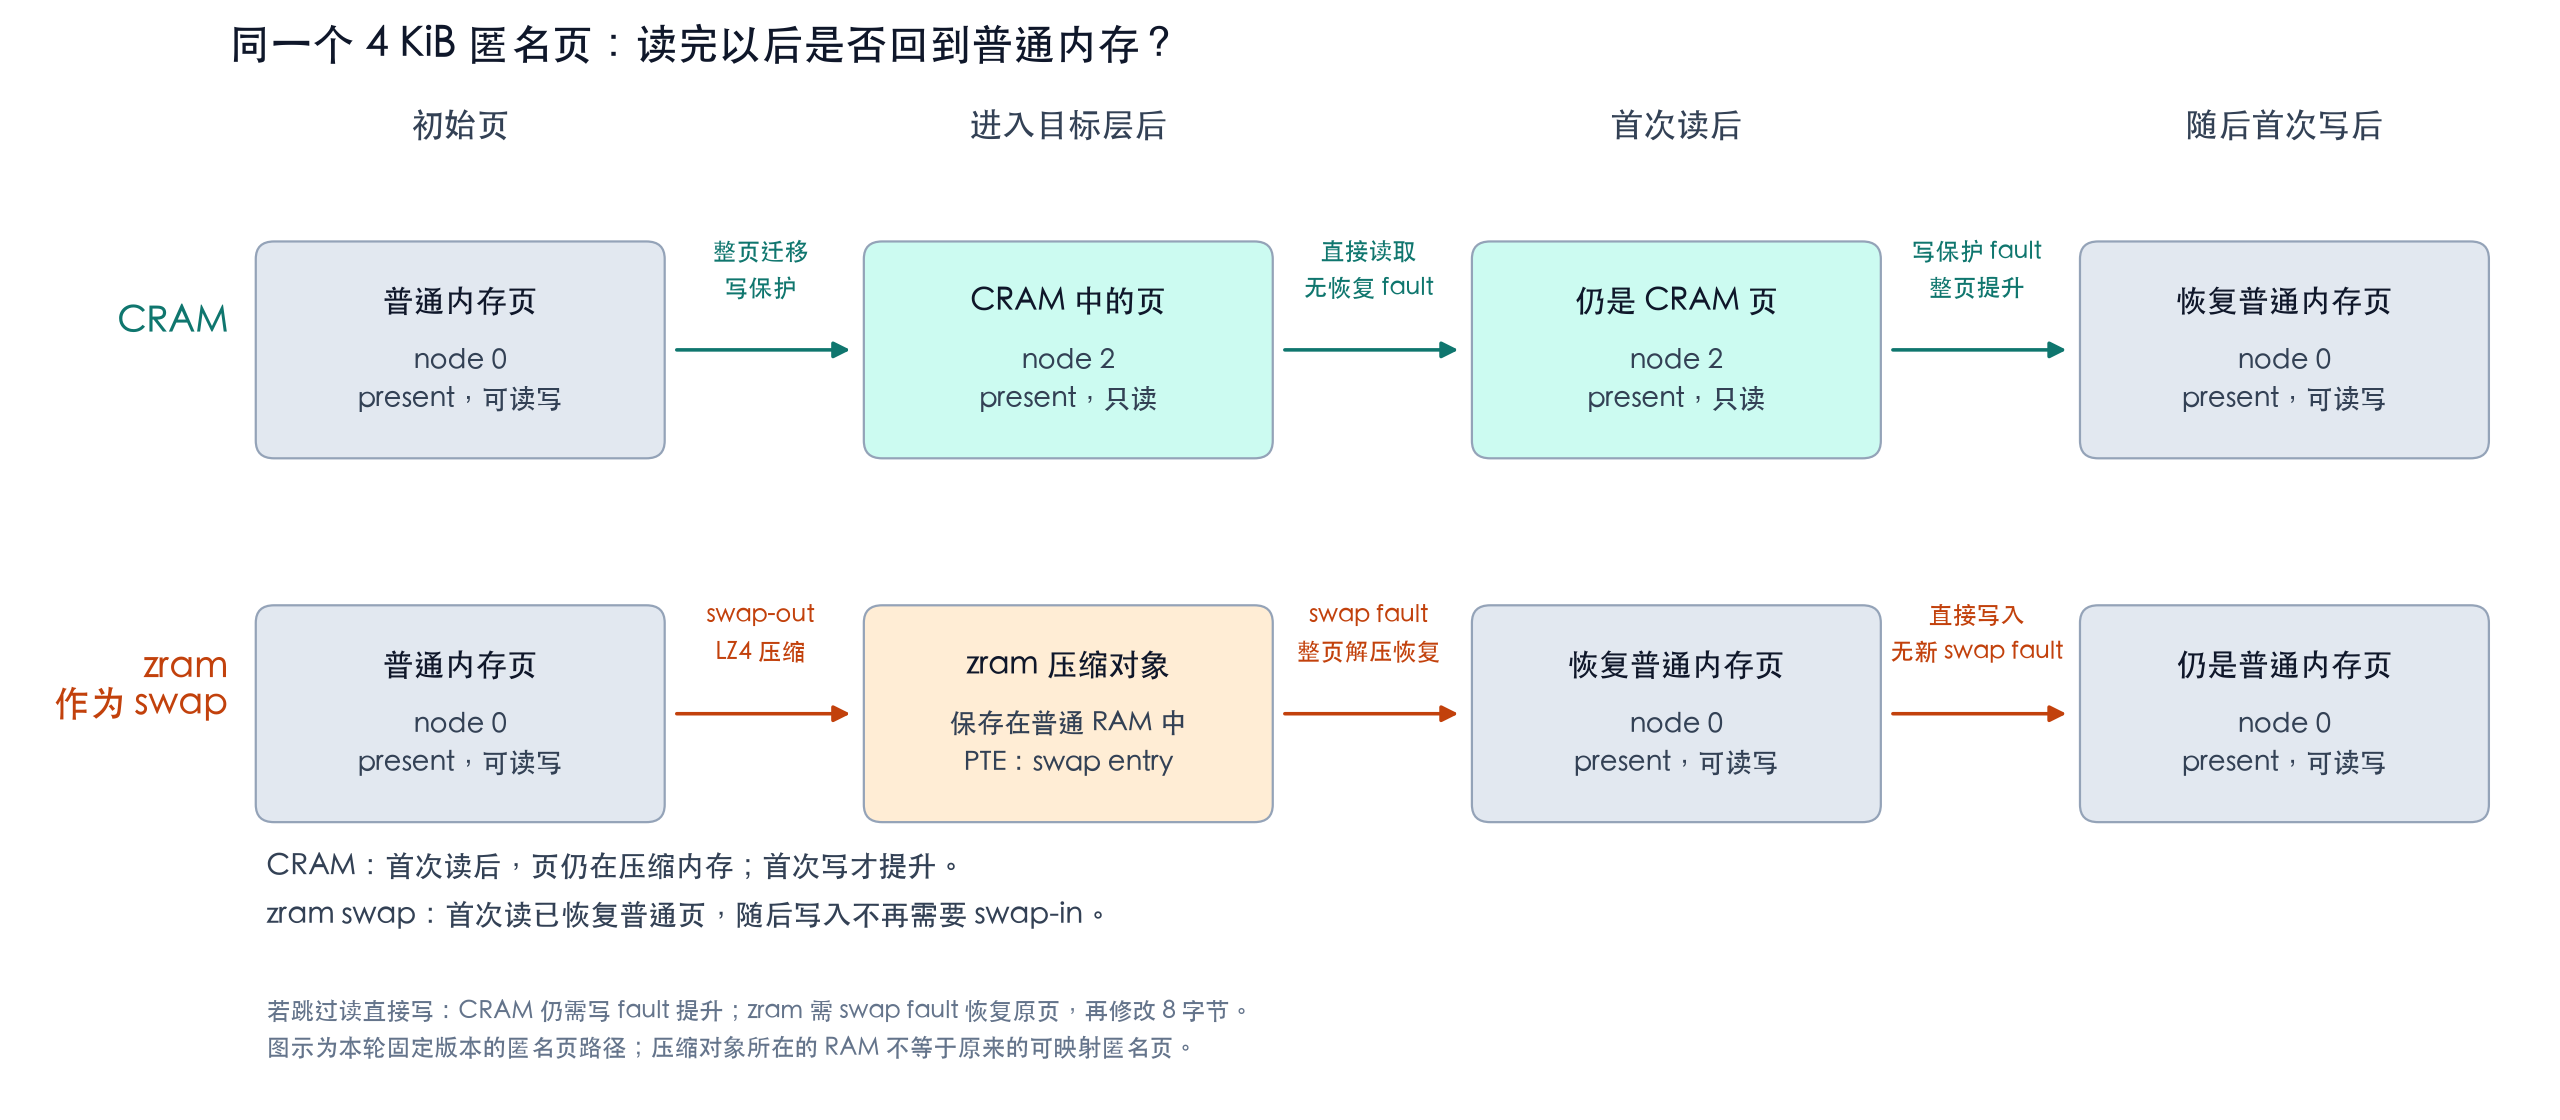
图示依据本轮固定版本的匿名页实验绘制,node 0 / node 2 是实验中的节点编号。横向是操作顺序,上下是两种方案;框表示页的位置或压缩对象的表示,箭头表示触发状态变化的动作。
最值得看的是“首次读后”这一列:CRAM 页仍在 node 2,zram 已恢复为 node 0 的普通页。 所以下一次写,CRAM 还要经过写保护 fault 和提升,zram 则可以写已经恢复的页。图中 zram 压缩对象虽然也保存在 RAM 中,却不是原来的可直接映射匿名页。
图画的是先读再写。如果跳过读直接写,CRAM 仍需提升;zram 仍需先通过 swap fault 恢复原页内容,再修改目标 8 字节。
本轮 trace 中,CRAM 页首次读没有目标访问 fault,读完仍在 node 2;zram 页首次读触发 swap fault,解压后回到普通内存 node 0。
这里要把跨 node 读取和迁页分开。CPU 可以直接访问远端 NUMA 内存;有效、允许读取的 PTE 不会仅仅因为页在另一个 node 就触发 fault。membind / cpuset.mems 主要约束分配或放置,也不是每次 load 的远端访问开关。Linux NUMA memory policy 文档
因此,CRAM 页留在 node 2 时,cache miss 后的访问可能经过远端内存或设备链路,但无需先把整个页迁回 node 0。跨 node 的访问延迟仍在,只是省去了这次读的软件恢复路径。命中 cache 时则未必访问设备。zram 首读需要恢复页,是因为 PTE 为 swap entry、压缩对象不能直接供该匿名映射读取,原因不在 NUMA 距离。
| 操作 | CRAM | zram,作为 swap 后端 |
|---|---|---|
| 页进入目标层 | 迁移到 node 2,PTE 仍 present,但只读 | 软件压缩,PTE 变成 non-present 的 swap entry |
| 首次读 | 没有 fault,仍在 node 2 | swap-in、解压,恢复到 node 0 |
| 再读一次 | 继续读 node 2 页 | 读已经恢复的 node 0 页 |
| 不先读,直接首次写 | 写保护 fault,提升到 node 0 | non-present 写 fault,swap-in、解压后写入 |
| 先读,再首次写 | 首次读没有提升,写时仍需提升 | 首次读已经恢复,写时没有新的 swap-in |
| 再写一次 | 普通内存写 | 普通内存写 |
这里 zram 专指用作匿名页 swap 后端的配置。zram 本身是压缩 RAM 块设备,也能用于其他场景,不能把上表外推到所有 zram 用法。
页进入、首次读和首次写的函数耗时
下面把第二轮的单页 trace 按四种操作展开,左侧 CRAM,右侧 zram;同一张图使用相同的 µs 刻度。条形长度表示所列函数的耗时,↳ 标出下层调用,便于把路径与时间放在一起看。图上数字来自开启 tracing 的单次机制验证;应用访问时间分布仍看下节关闭详细 tracing 的样本统计。
页进入目标层
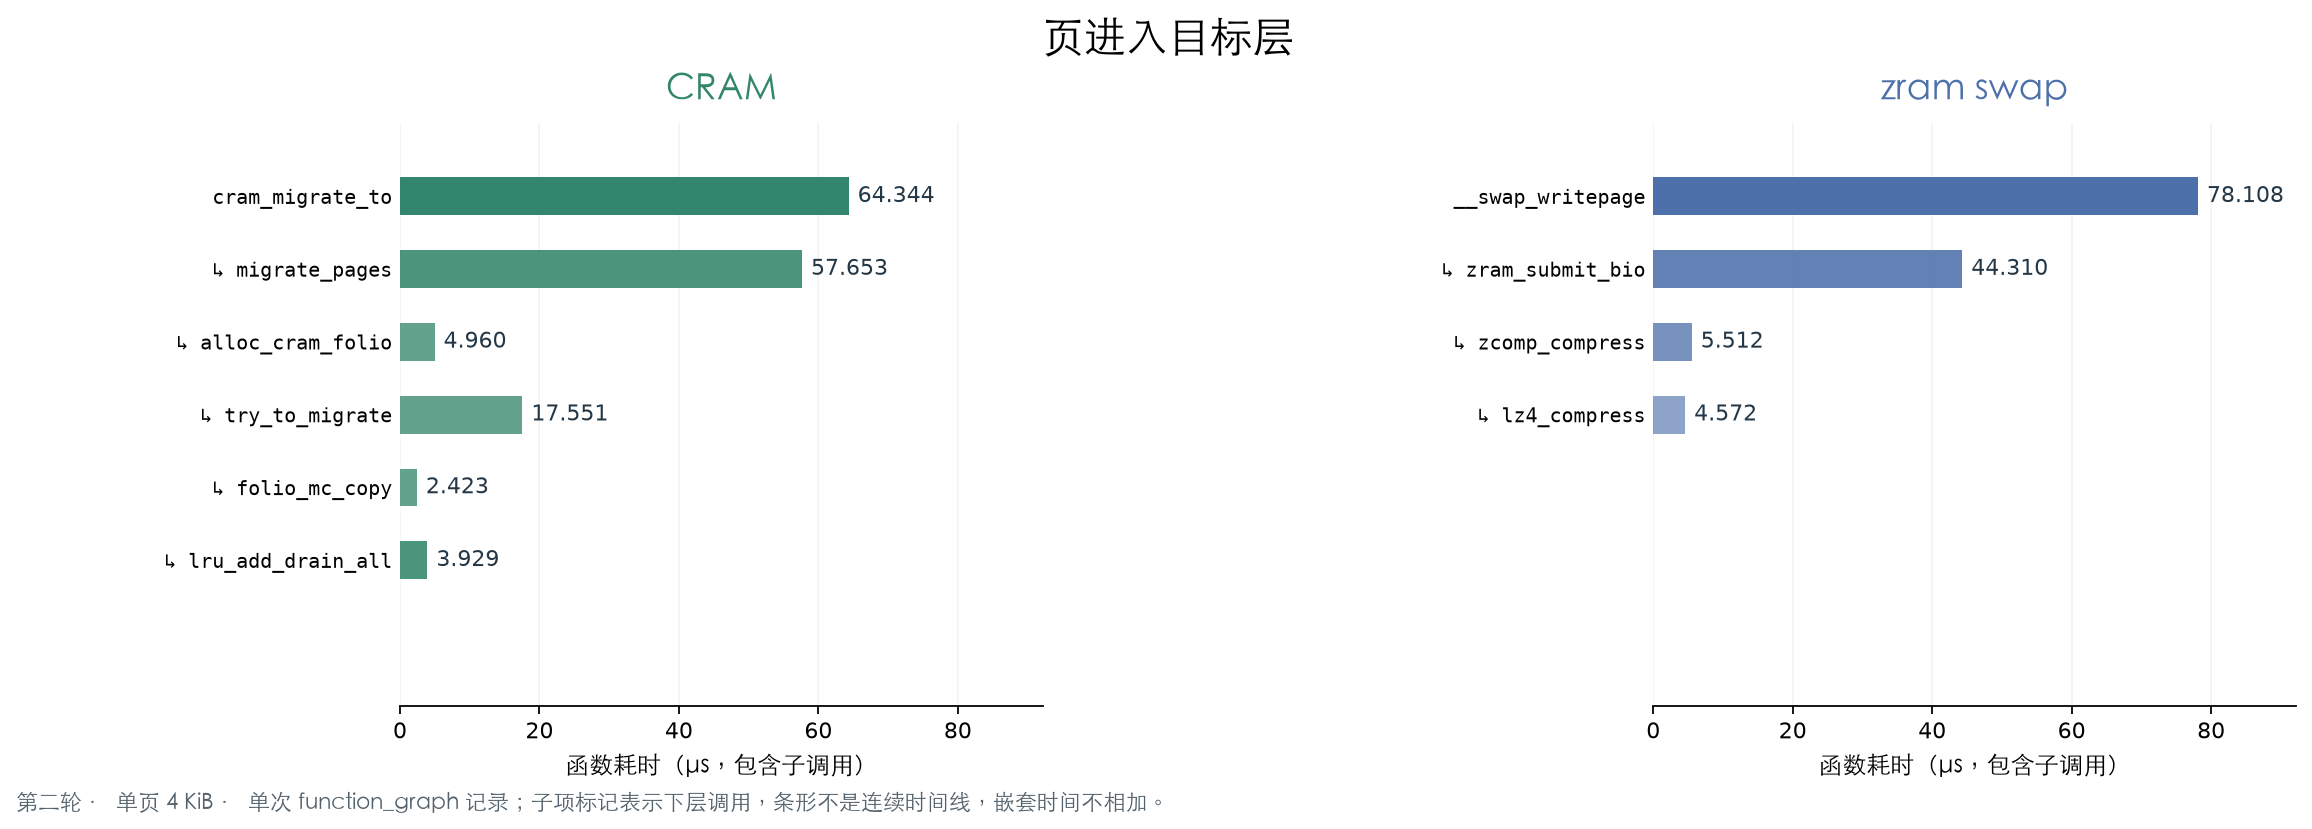
CRAM 从 cram_migrate_to 进入页迁移,zram 从 __swap_writepage 进入块设备写入和压缩。这里显示的是 trace 覆盖到的迁入 / 换出函数;完整准备阶段的计时和 LRU / RCU 同步分解见后面的“单页迁入的时间花在哪里”。
首次读 8 字节
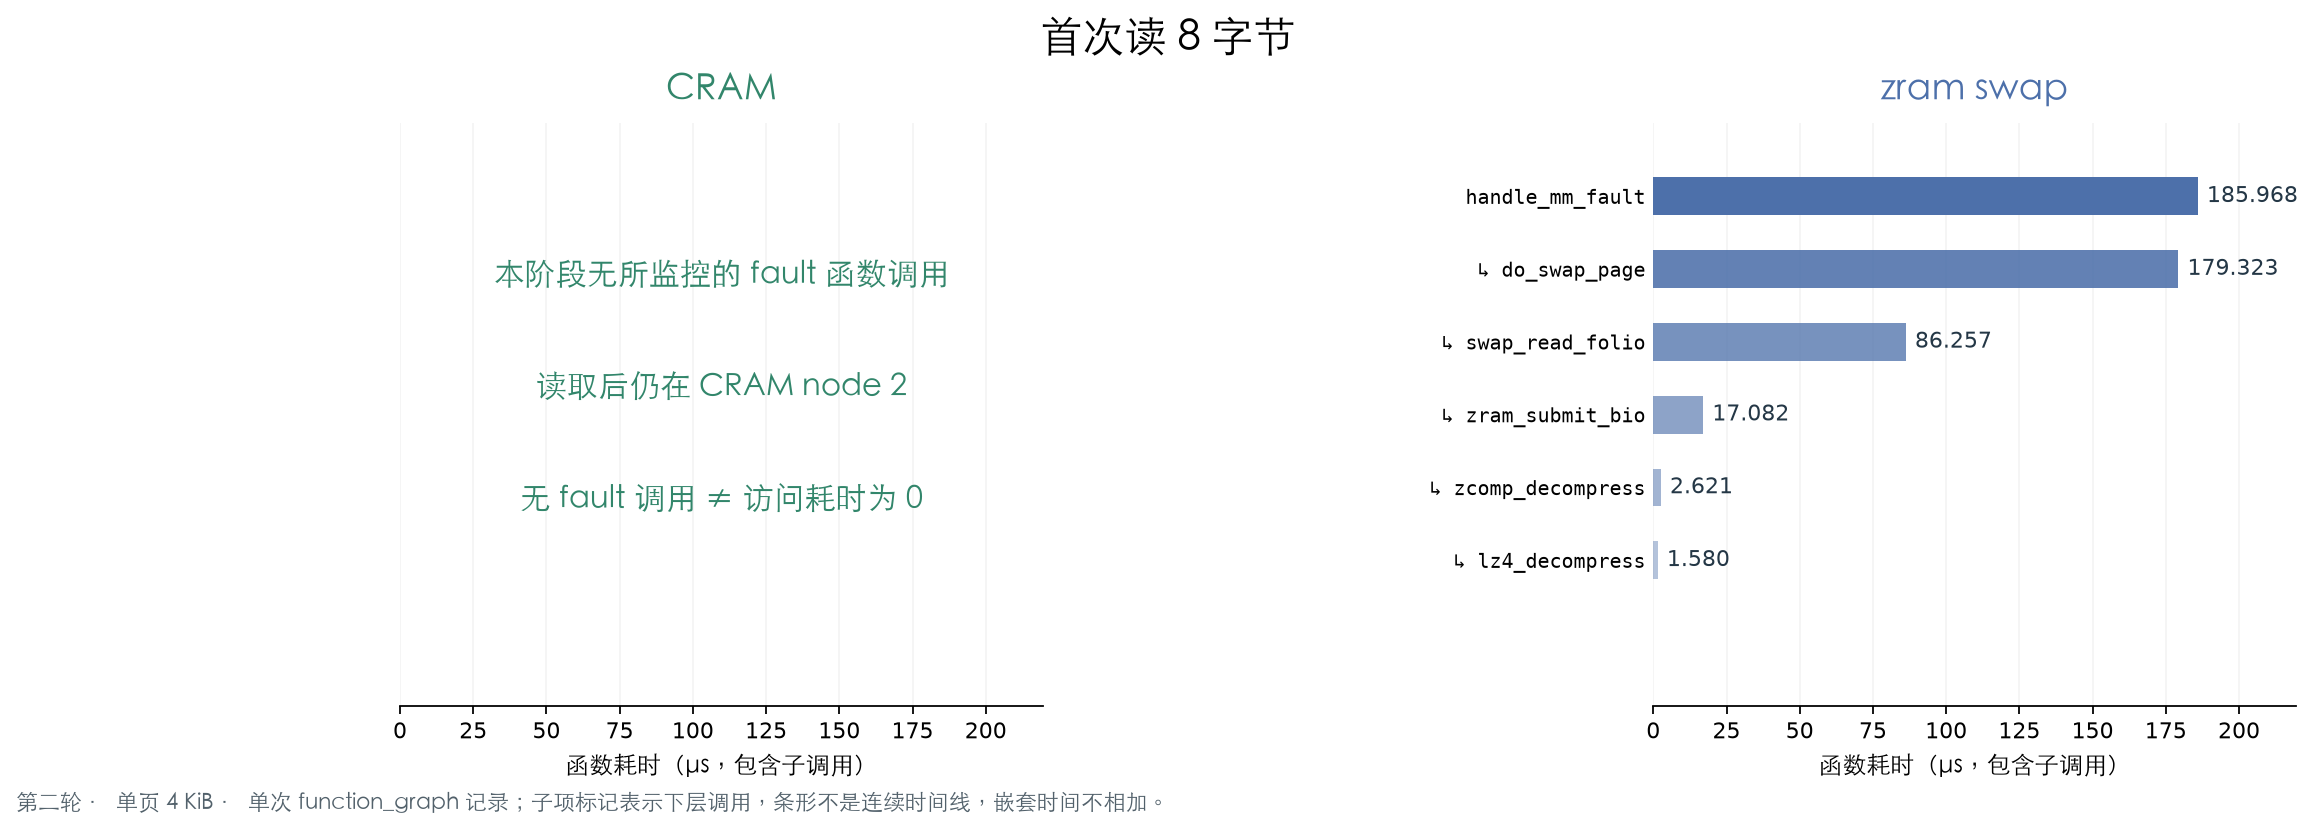
CRAM 这次读没有监控到目标访问 fault 调用,页仍在 node 2。zram 通过 handle_mm_fault → do_swap_page → swap_read_folio 恢复页,其中解压发生在 zcomp_decompress / lz4_decompress。
不先读,直接首次写 8 字节
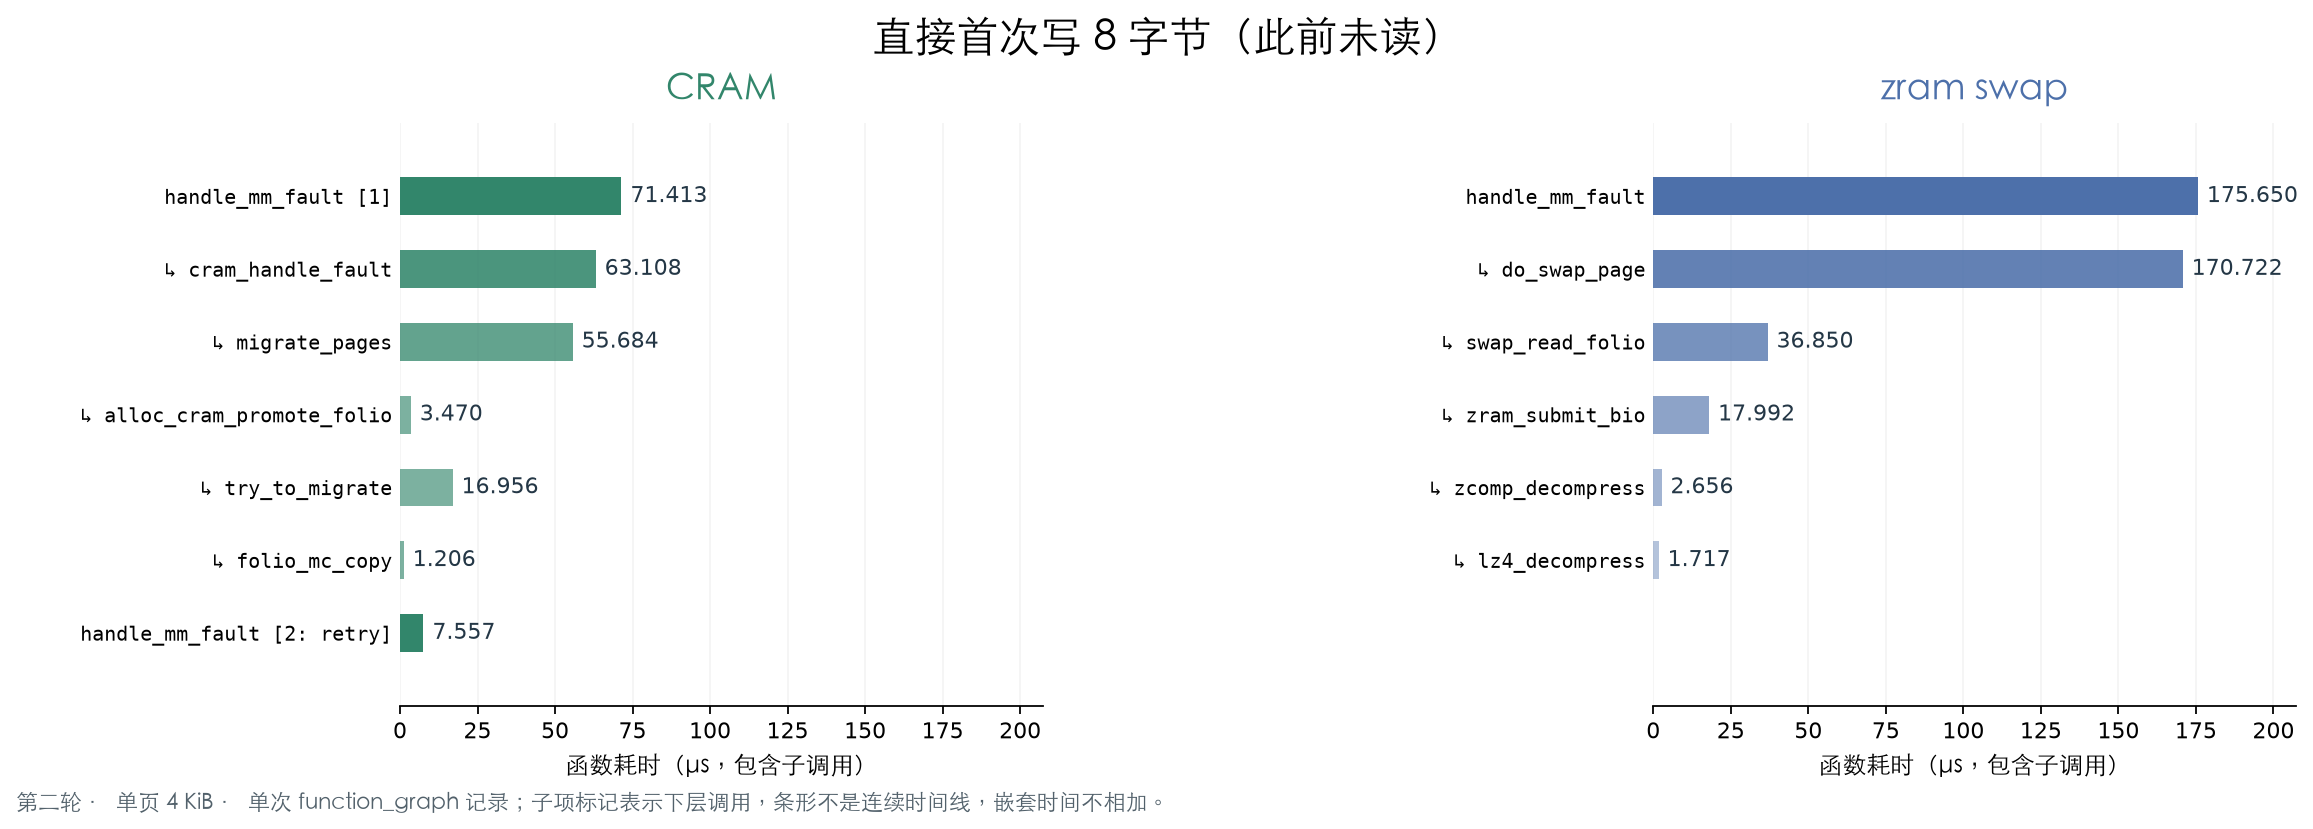
两者都需要处理 fault:CRAM 提升页,zram 恢复 swap 页。CRAM 的两次 handle_mm_fault 分别列出,第二次对应这条记录中的重试。
首次读后,应用修改 8 字节
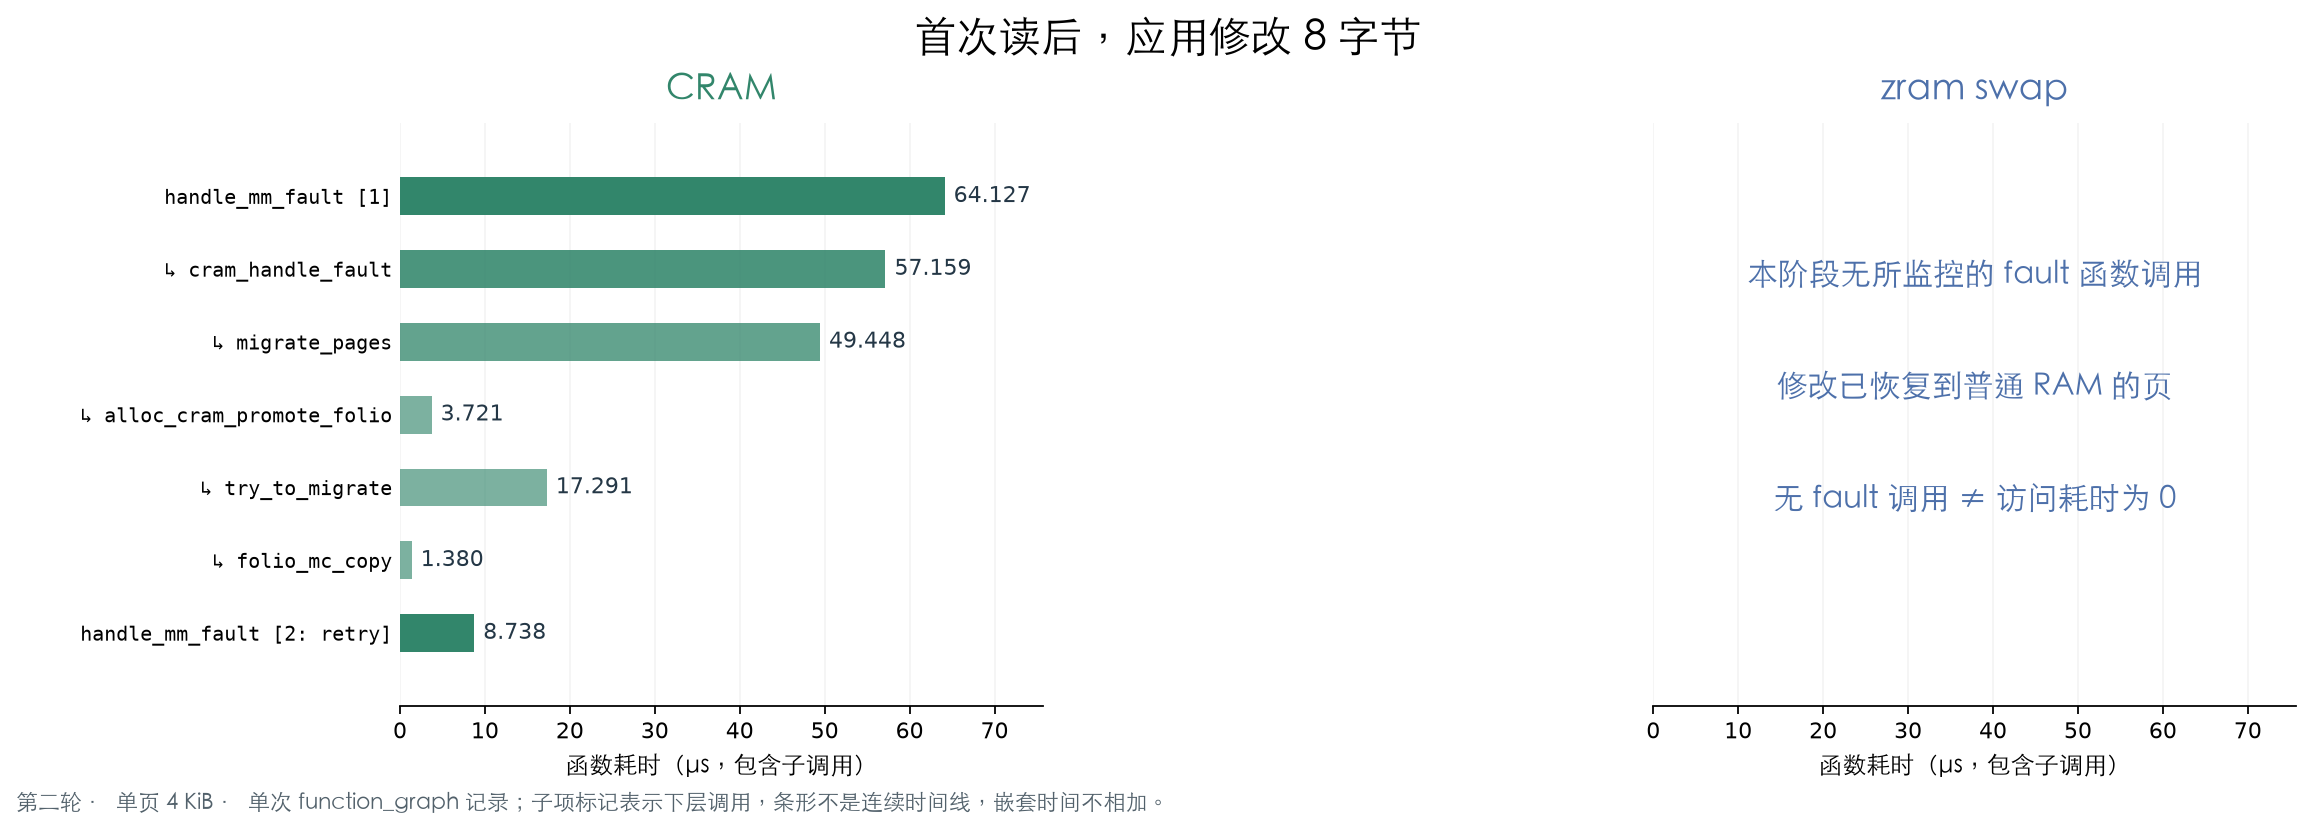
这次 CRAM 提升中,migrate_pages 为 49.448 µs;其中普通页分配为 3.721 µs,try_to_migrate 的映射迁移处理为 17.291 µs,页内容复制为 1.380 µs。提升包含分配、映射处理和复制等动作,不能把整个提升时间看成复制时间。
zram 在前一次读时已经恢复为普通 RAM 页,这次测的是应用修改该页,没有新的 swap-in 或解压调用;它不是把页写入 zram 的时间。
函数耗时明细、分用例汇总、trace 与解析绘图脚本一并保留。
在 x86 上,CRAM 这次写 fault 的 0x7 表示 user、write、protection violation;zram 直接写的 0x6 表示 user、write、non-present。两者都可能表现为“写一下就 fault”,但前者是在处理只读的 present 页,后者是在恢复 swap entry。
这批机制测试里,CRAM 的两种首次写各出现了同地址、同指令的两次 fault,涉及重试;zram 直接首次写出现一次。
从 trace 看,实验实现符合前面描述的访问模型:CRAM 首次读保留原页位置,首次写通过 cram_handle_fault 提升;zram 首次访问走 swap 恢复链。固定版本的 mm/cram.c提供实验源码依据。
接下来测量这些路径的模拟开销。
测试环境与口径
为了避免把不同版本、不同页内容混到一起,直接对照使用统一机制矩阵;连通性 smoke 只检查能否跑通,不参与数值比较。
| 项目 | 配置 |
|---|---|
| Linux | 9fa5ffee4fd4726e31f05deebb938cccfa0b460f,guest 6.19.0-rc5-cram-lab+ |
| QEMU | a078aaedd382eedd121a037ffa992bb9db964acb,10.2.50 |
| 运行方式 | 隔离 QEMU guest,嵌套 KVM,2 vCPU |
| 内存 | 512 MiB 普通 RAM + 512 MiB RAM 后备 CXL CT3 |
| NUMA / 页 | node 0 普通内存、node 2 CRAM;4 KiB 页,关闭 THP |
| 程序 | GCC 13.3 静态编译,统一页内容,偏移 0 的 8 字节 load/store |
| zram | LZ4;路径与计时使用 64 MiB swap,压力实验使用 256 MiB swap |
| 计时 | 固定 guest CPU 0,CLOCK_MONOTONIC_RAW;关闭详细 trace |
内核和设备来自实验分支:Linux private_compression、QEMU compressed_cxl_clean,复现时应按表中的 commit 固定,不能只跟随分支头。
本轮使用隔离 guest,宿主没有更换内核或重启。
访问时间:读的路径短了,写的成本还在
每种后端跑三组,每组 1000 个成功样本,总共 9000 个,失败数为 0。每个样本重新建立逻辑页,分别测试“读后再读”“直接写后再写”“读后写,再写”。详细 tracing 和计时分开,避免把 function graph 的开销当成访问开销。
下表单位为 µs,每格依次是 p50 / p95 / p99,分位数使用 nearest rank。
| 操作 | DRAM | CRAM | zram |
|---|---|---|---|
| 首次读 | 0.171 / 0.233 / 0.267 | 0.187 / 0.292 / 0.365 | 4.418 / 6.934 / 15.850 |
| 重复读 | 0.153 / 0.203 / 0.223 | 0.153 / 0.212 / 0.240 | 0.154 / 0.198 / 0.225 |
| 直接首次写 | 0.190 / 0.260 / 0.281 | 6.172 / 9.494 / 29.994 | 4.440 / 7.267 / 28.087 |
| 直接写后重复写 | 0.167 / 0.232 / 0.248 | 0.170 / 0.232 / 0.244 | 0.161 / 0.218 / 0.237 |
| 先读后首次写 | 0.179 / 0.251 / 0.267 | 6.194 / 9.902 / 32.496 | 0.497 / 0.621 / 0.837 |
| 读后写再重复写 | 0.160 / 0.225 / 0.240 | 0.170 / 0.237 / 0.263 | 0.168 / 0.234 / 0.253 |
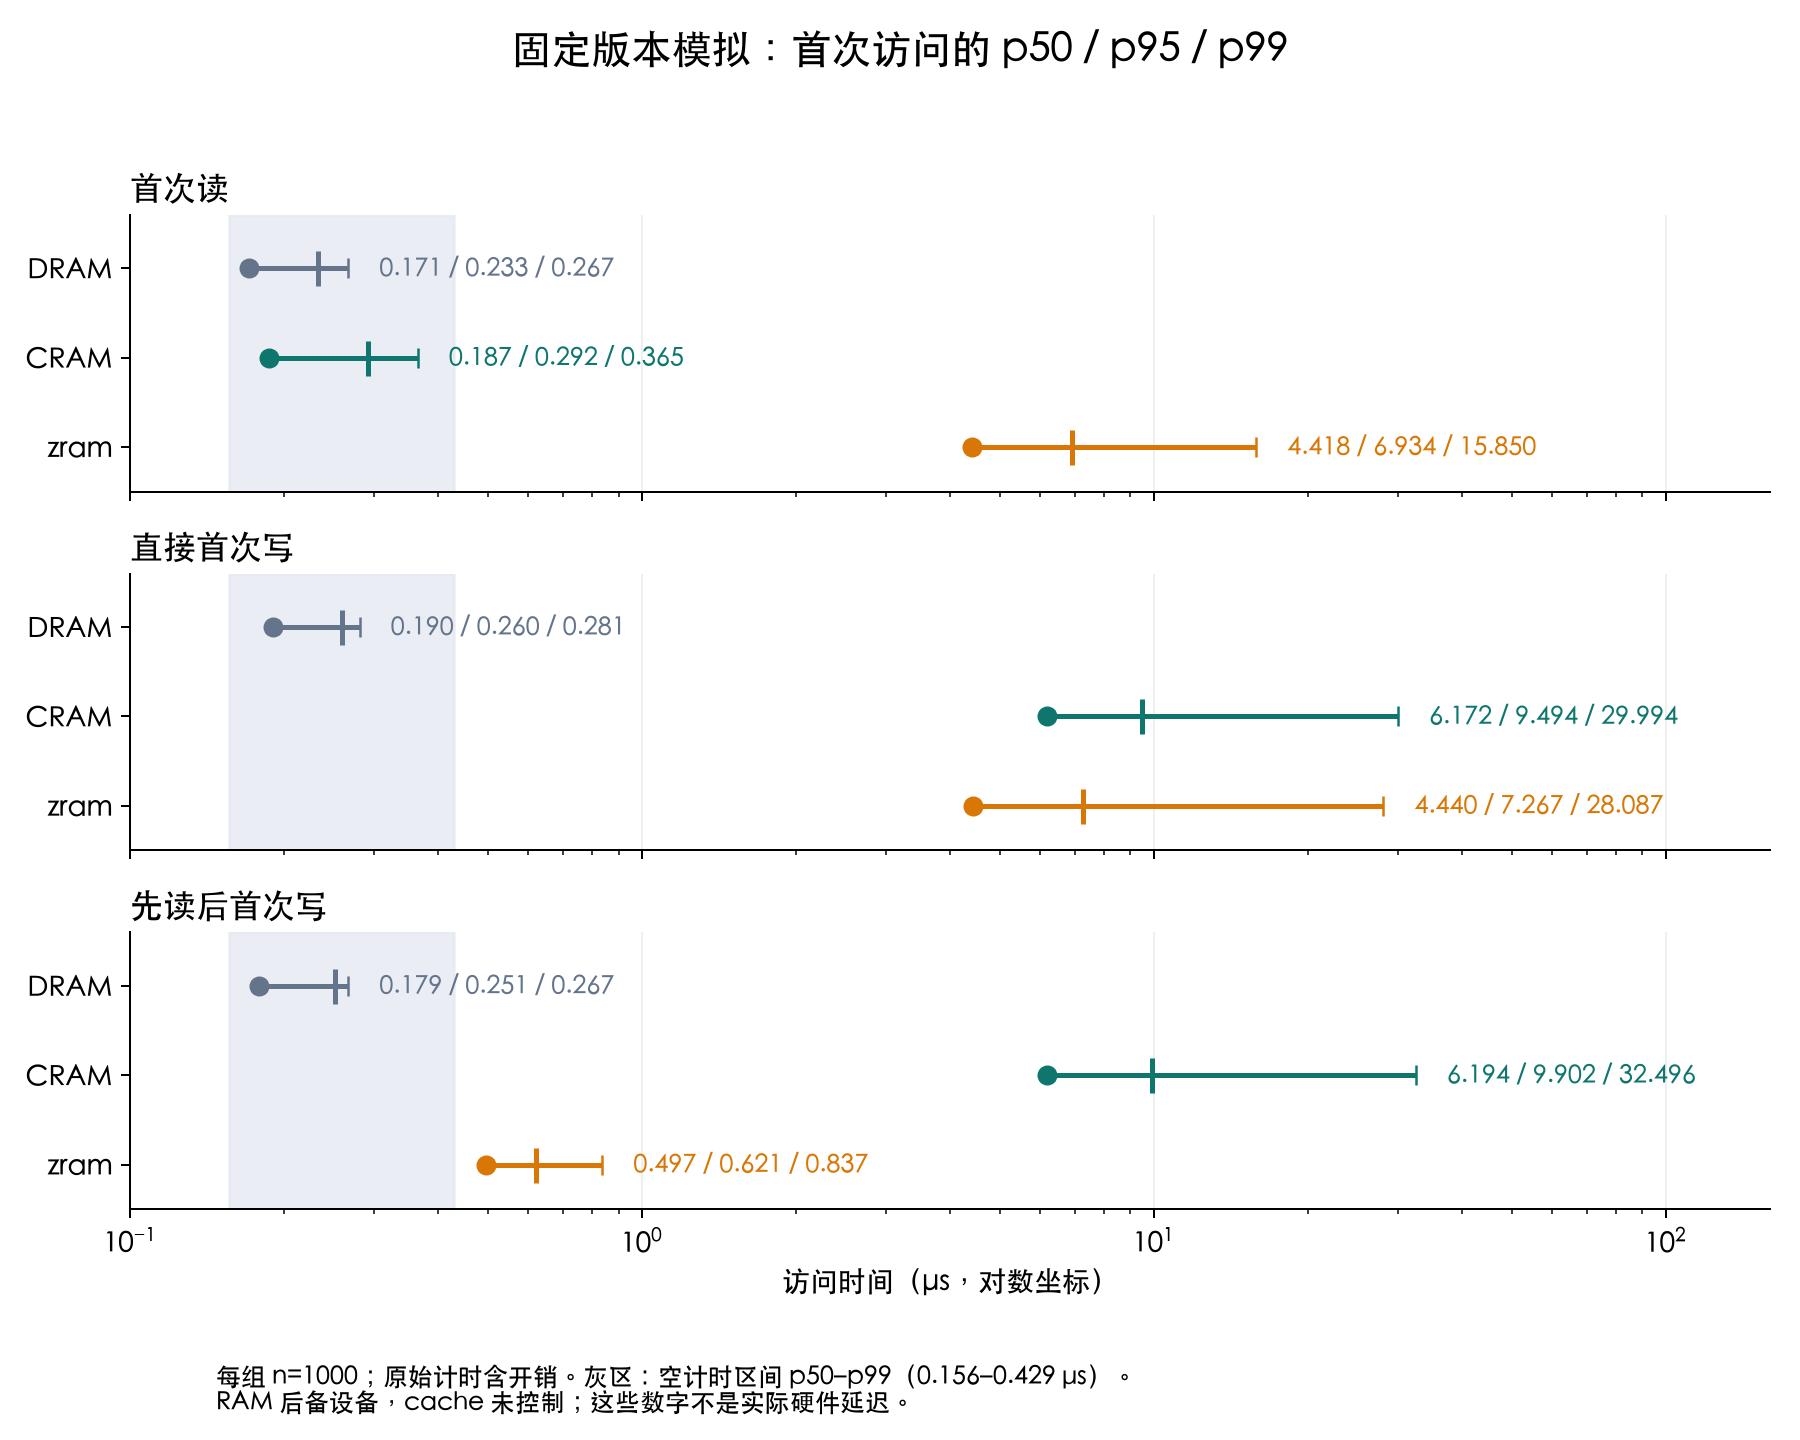
图中圆点是 p50,横线延伸到 p99,短竖线标记 p95;横轴为对数坐标。灰色区间标出计时器空区间的 p50 至 p99,用来提醒接近计时开销的结果不能过度解释。
路径和数字可以互相对照:zram 首次读需要恢复页,测到微秒级开销;CRAM 首次读没有这条软件恢复链。等到第一次写,CRAM 要做提升,测到约 6 µs 的中位数,而 zram 直接首次写约 4.4 µs。先读再写时,zram 已经把页恢复了,CRAM 仍然要提升。
空计时区间的 p50 / p95 / p99 为 0.156 / 0.229 / 0.429 µs;表中保留原始计时开销,接近这个范围的差异只作路径对照。
zram 读后首次写的中位数 0.497 µs 高于普通页基线,这个差异尚未归因。独立 trace 没有看到该路径的新 fault,不能只凭时间更长就反推又发生了一次 swap-in。
内存压力:冷页会不会自己进入 CRAM?
显式迁移能证明路径,但不能说明内存紧张时内核会不会真正使用这一层。下一组实验逐批初始化相同的 480 MiB 匿名工作集,对照三种条件:关闭自动 demotion、开启自动 demotion,以及开启后由设备压力阻止迁入。三组都保留 zram 作为 swap 后端。
每 64 页抽样一页,共 1920 个采样点。下面是冷阶段的分布,这些是采样点数量,不是全量页数或压缩率。
| 条件 | 普通 node 0 | CRAM node 2 | swapped | 全量内容校验 |
|---|---|---|---|---|
| 关闭 demotion | 1295 | 0 | 625 | PASS |
| 开启 demotion | 1467 | 453 | 0 | PASS |
| 设备压力阻止迁入 | 1269 | 0 | 651 | PASS |
开启组没有显式迁移工作集,仍然观察到冷页进入 node 2。对应 cold 阶段的 pgdemote_kswapd=19694、pgdemote_direct=9275;关闭组这两个计数为 0。这说明模拟环境里,自动降级确实走通了。
这组主要观察内存压力下的策略和页位置变化。
页升温:241 ms 花在哪里?
冷页进入CRAM 压缩内存之后,还有一个问题:应用开始写这些页时,系统要付出多少代价?
我对工作集前 64 MiB 区域逐页写 8 字节,共 16384 次 store。覆盖的是 64 MiB 页范围,实际写入只有 128 KiB。目标区域有 256 个采样点,操作后均回到 node 0。
| 条件 | 升温前目标区域 | 升温后目标区域 | 本批墙钟时间 |
|---|---|---|---|
| 关闭 demotion / zram | 256 点均 swapped | 256 点均 node 0 | 100.142 ms |
| 开启 demotion / CRAM | 256 点均 node 2 | 256 点均 node 0 | 241.738 ms |
| 阻止迁入 / zram 回退 | 256 点均 swapped | 256 点均 node 0 | 97.661 ms |
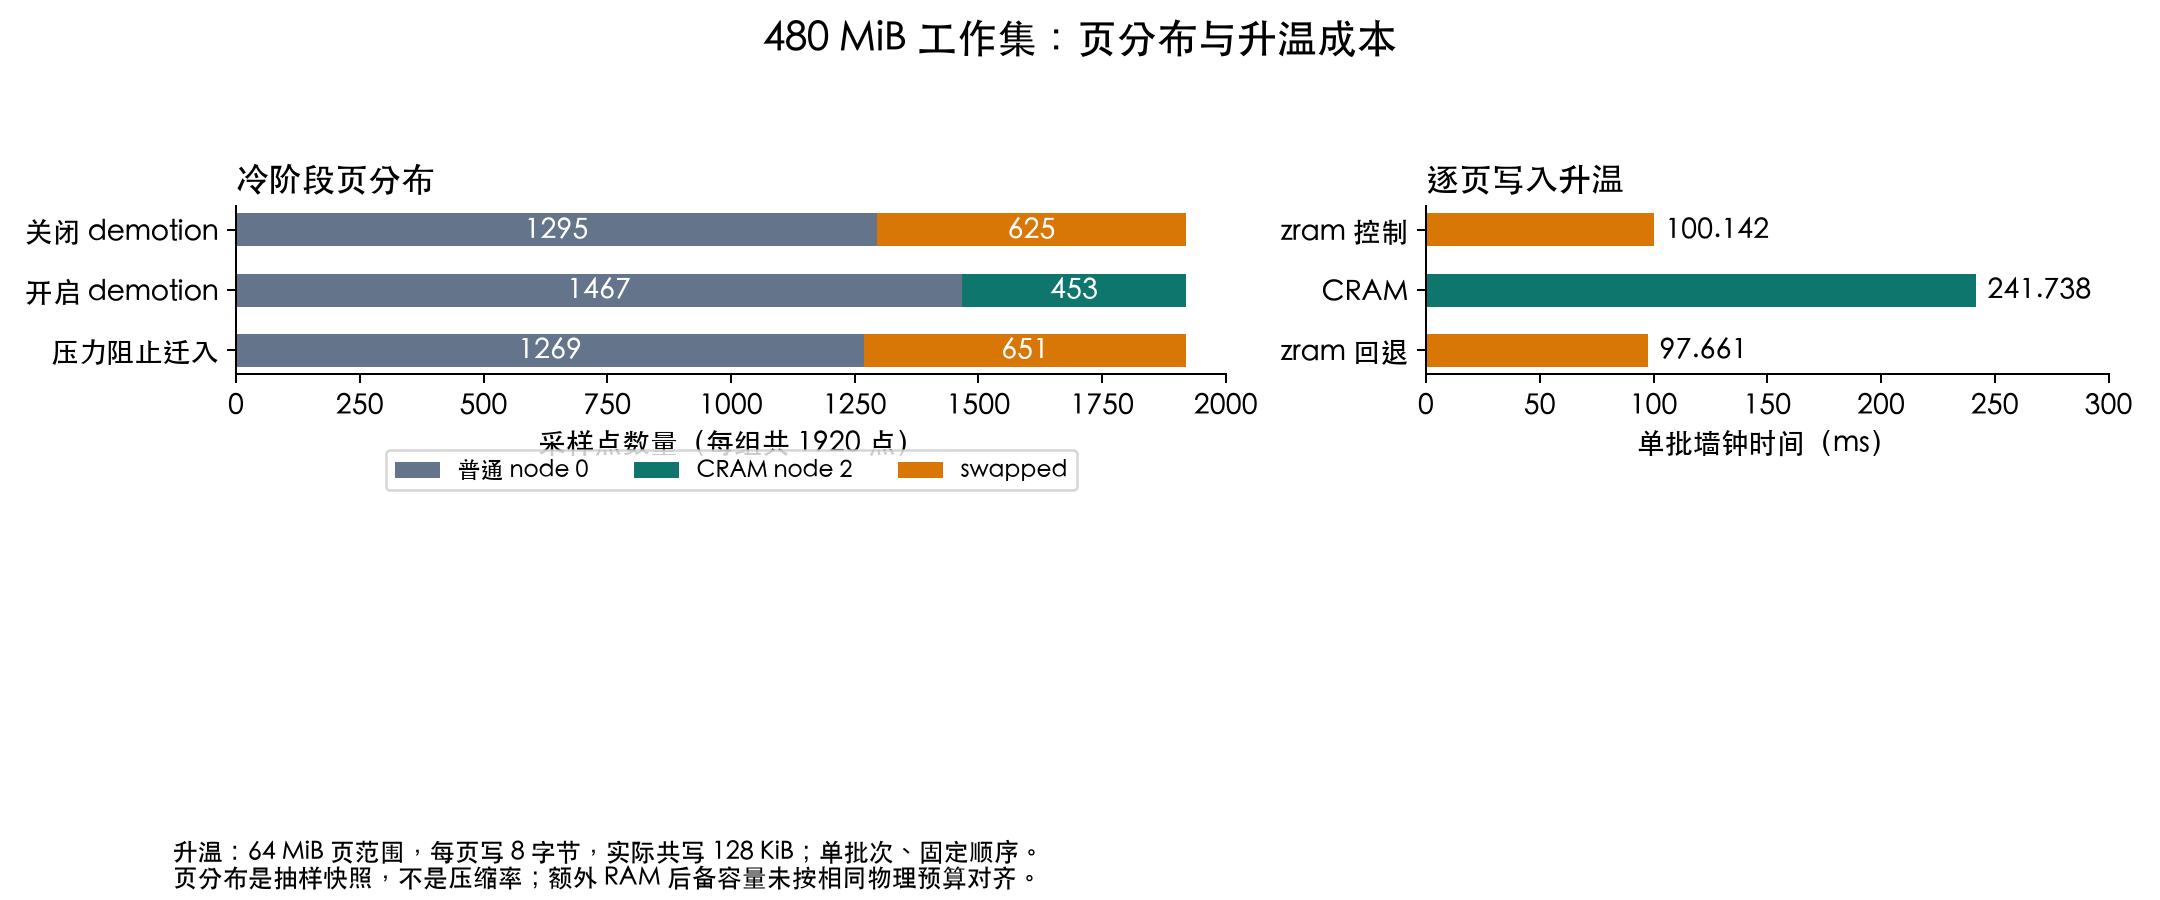
在这个模拟负载里,CRAM 组的升温批次反而更慢。目标页提升时,内存压力没有消失:整个工作集的 node 2 采样数只从 453 降到 446,同时 demotion 计数又增加了 16920 页,说明其他冷页也在降级。
总数只能说明有页被搬入、也有页被搬出,不能告诉我们是不是同一页在反复搬。为此又补了一组逐页着色测试。
CRAM 保留了读映射,但写入升温会把页带回普通内存,还可能伴随其他页的回收和迁移。因此需要把首次读和升温成本一起看。
给页着色:有没有同一页搬来搬去?
给每个抽样页一个固定编号,把它在普通内存、CRAM 和 swap 中的位置画成颜色。页迁移后物理地址会变,编号仍按同一匿名映射中的逻辑页位置保持不变。
这次仍用 480 MiB 工作集,每 64 页取一个固定点,共 1920 个采样页。先只写前 64 MiB,复现单次升温动作;随后按 64 MiB 分段轮流写,遍历整个工作集三遍。每页仍只写 8 字节,两段负载分别统计。
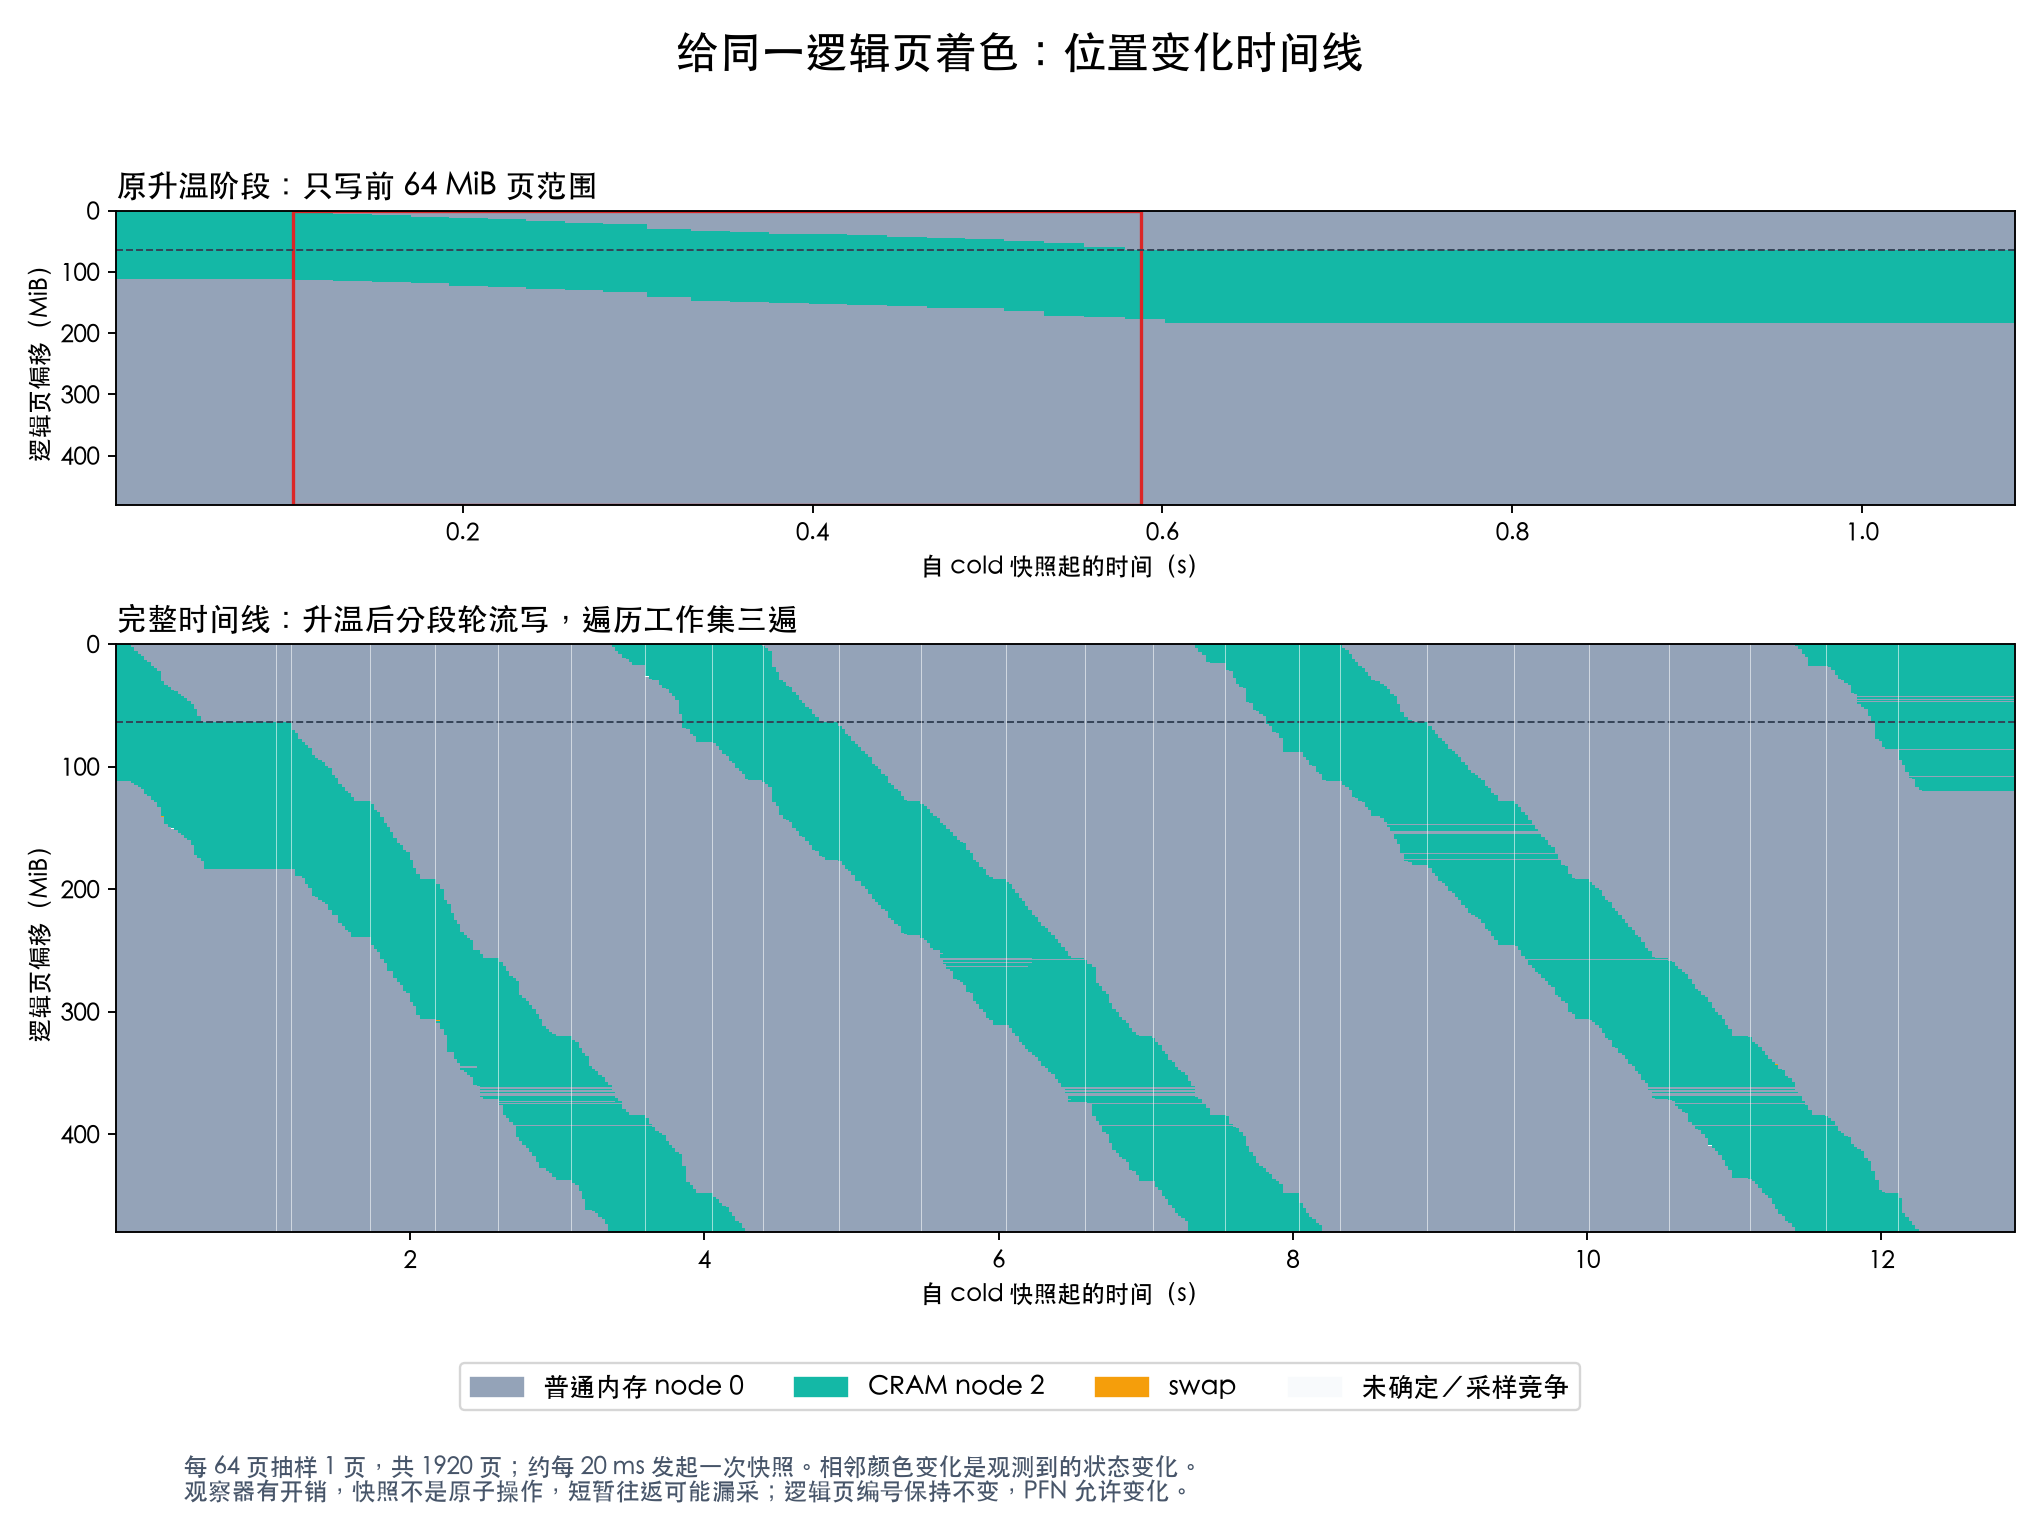
横向是时间,纵向是固定页位置。沿着同一条水平线看:绿色是 CRAM,灰色是普通内存;绿 → 灰 → 绿,才说明同一个逻辑页被搬回来以后,又被放进了 CRAM。 上图红框标出单次升温的写入时段,下图给出包括后续反复写入在内的完整时间线。
| 观察哪段负载 | 观察到至少一次“CRAM → 普通内存 → CRAM”的采样页 |
|---|---|
| 仅前 64 MiB 的单次升温 | 0 / 1920 |
| 加入分段反复写入后的全程 | 1896 / 1920 |
单次升温中,前 64 MiB 的 256 个目标采样页全部从 CRAM 回到普通内存,观测期内没有再次降级;其他页则继续进入 CRAM。这说明之前看到的“提升与降级同时发生”,可以由不同页分别搬入、搬出来解释。
反复写整个工作集时,情况变了:同一逻辑页的往返已经能看到。比如编号 0 的页,从起初的 CRAM 在约 0.114 s 回到普通内存,约 3.381 s 再进入 CRAM,约 4.400 s 又回到普通内存。全程记录到 4213 次这种往返,说明在这组加强的压力负载下,页确实会搬来搬去。
这组实验显示,在普通内存不足以容纳整个工作集的条件下,写入范围决定了页的位置变化:
- 只让一小块冷数据变热:目标页回到普通内存,其他冷页进入 CRAM;本轮观测窗口内,目标页没有再次降级。
- 轮流改写整个工作集:之前提升的页会再次进入 CRAM,下一轮写到它时又回到普通内存,同一逻辑页出现反复迁移。
也就是说,CRAM 可以让暂时不用的页留在压缩内存里;当应用轮流写入的范围超过普通内存可容纳的空间时,本轮实验观察到了页在两层内存之间搬来搬去。
设备不再接收页时:回退与恢复
这组模拟测试已完成:设备报告压力后,CRAM 停止接收新页;内存压力下,工作负载回退到 zram。设备解除压力后,CRAM 恢复接收。 回退阶段的内容校验、恢复后的迁入检查均通过。
测试通过 QMP 注入 CT3 水位中断来模拟设备压力。在所测版本中,lthresh 使驱动将 CRAM node 设为最大压力,新迁入返回 ENOSPC;hthresh 清除压力,恢复迁入。对应实现见 QEMU CT3 源码及 Linux compression driver。
| 测试条件 | 观察到的行为 | 验收结果 |
|---|---|---|
| 设备正常接收 | 探针页迁入 node 2 | 通过 |
| 注入设备压力 | 新迁入返回 errno=28 (ENOSPC),页留在 node 0 |
通过 |
| 阻止迁入期间运行内存压力负载 | 冷页换出到 zram,数据内容正确 | 通过 |
| 解除设备压力 | 探针页再次迁入 node 2 | 通过 |
| 无 swap,同时阻止 CRAM 迁入 | 普通内存耗尽后,OOM 终止测试进程;guest 存活,解除压力后迁入恢复 | 预期行为通过 |
最后一项在独立 guest 中完成:关闭 swap,阻止 CRAM 接收页,再运行相同的 480 MiB 负载。测试进程设置 oom_score_adj=1000,最终被内核 OOM 终止,退出码为 137;init 继续运行,恢复后的迁入探针通过,guest 正常关机。
这组结果说明,CRAM 可以根据设备压力暂停、恢复迁入。暂停期间,系统使用现有 swap 接住内存压力;如果没有 swap,普通内存耗尽后仍会触发 OOM。
对应用来说,这些差别意味着什么?
CRAM 的好处是:冷数据读一下,可以继续放在压缩内存里,不必占回普通 DRAM。zram 的做法是:第一次用到换出的数据,先还原成普通页,之后就按普通内存访问。
因此,“不用恢复页”和“每次读取都更快”是两回事。CRAM 省去了首次读的软件恢复过程,但页仍在压缩内存设备上,cache miss 时还要付出设备和链路访问成本。zram 首次读取要恢复,恢复到 CPU 本地内存后,后续访问可以获得本地内存的速度。
| 应用在做什么 | CRAM 的表现 | zram swap 的表现 |
|---|---|---|
| 很多数据放着不动,偶尔读几次 | 读完仍留在压缩内存,普通 DRAM 可以留给其他数据 | 读到的页要还原,重新占用普通 DRAM |
| 数据读过以后开始频繁访问 | 留在设备上的页可能持续承担远端访问成本 | 页已恢复;若在 CPU 本地,后续访问走本地内存 |
| 开始修改原来的冷数据 | 先把整页搬回普通 DRAM,再修改;大量页同时变热时,可能伴随其他页被搬走 | 已读回的页可以直接改;尚未读回的页仍要先还原 |
| 希望用现有机器节省内存 | 需要支持压缩访问的设备及匹配内核 | 可以使用现有 RAM 做软件压缩,但要支付 CPU 和内存开销 |
本轮实验呈现了两种访问特点:CRAM 在首次读时保留页的位置,把整页搬回普通内存的动作留到首次写;zram 在首次读或写时恢复普通页,之后直接访问恢复后的页。 在这台模拟 guest 中,CRAM 的批量写入升温耗时更长;内存紧张时反复写完整个工作集,还观察到同一逻辑页在 CRAM 与普通内存之间往返。
对“大量数据很少改,偶尔读一下”的负载,CRAM 可以让读过的页继续留在压缩内存,普通 DRAM 留给其他数据。对访问后会连续读写的数据,恢复成普通页可以减少后续恢复动作;若页位于 CPU 本地,也能减少远端访问。应用的读写范围越大、冷热切换越频繁,页搬运就越值得关注。
测试方法
- 用页表状态确认换出完成。 本轮以 pagemap 的 bit 62(swapped)为 1、bit 63(present)为 0,确认匿名页处于 swap 状态,再开始首次访问计时。
MADV_PAGEOUT用于请求回收目标页,返回值表示请求调用的结果;pagemap 则直接给出检查时的页状态。因此程序在请求后检查状态,必要时做有界重试。pagemap 官方说明 - 分别计时“准备页”和“访问页”。 前文首次读、首次写的数据来自第三轮:先准备好目标页,再对 load / store 单独计时。同一轮还记录了准备时间:CRAM 从调用
move_pages前计到系统调用返回,之后才检查页位置;zram 从请求MADV_PAGEOUT计到确认 swapped,包含状态检查和重试等待。两项分别反映“单页迁移系统调用”和“完成换出准备”的等待时间。 - 从
cram_handle_fault观察写保护 fault 的处理。 固定版本中,这个回调调用cram_fault完成处理逻辑;后者在本次编译中被内联,代码合并进调用者。因此 trace 选择实际可见的cram_handle_fault,再核对其后的页提升和复制路径。固定版本的 CRAM 实现 - 用 trace 解释路径,用关闭详细 tracing 的样本统计时间。 路径验证批次记录 fault、解压、迁移以及访问后的页位置;访问计时批次关闭详细 function tracing,统计首次读写和重复访问的时间分布。正文的函数链与时间表分别来自这两类记录。
- 用 8 字节写入检查局部修改。 程序只修改页内 8 字节,随后校验整页内容。zram 中尚未恢复的页需要先读回并解压,保留其他字节,再完成这次写入;CRAM 页则先提升到普通内存,再完成修改。
单页迁入的时间花在哪里?
第三轮记录的 CRAM 准备阶段中位数约为 1.7–1.8 ms。这是每次迁入一个 4 KiB 页的完整 move_pages 时间,包含迁移前的同步工作。
为拆开这段时间,第六轮继续使用相同内核与 QEMU,固定 CPU,每次准备一个新页:先运行 200 个关闭详细 tracing 的样本,再采集 40 个从 __x64_sys_move_pages 开始的完整 function graph。检查迁入返回状态为 node 2,随后修改 8 字节并校验整页内容。全部样本通过。
| 第六轮观测项 | 样本数 | 中位时间 |
|---|---|---|
move_pages 墙钟时间,关闭详细 tracing |
200 | 519.436 µs |
move_pages 墙钟时间,开启 function graph |
40 | 465.079 µs |
__x64_sys_move_pages,trace 内系统调用耗时 |
40 | 462.472 µs |
lru_cache_disable,迁移前的 LRU 同步 |
40 | 374.150 µs |
↳ synchronize_rcu_expedited,其中的 RCU 同步 |
40 | 332.287 µs |
cram_migrate_to,CRAM 迁入路径 |
40 | 69.303 µs |
↳ migrate_pages,其中的页迁移 |
40 | 63.199 µs |
↳ folio_mc_copy,其中的页内容复制 |
40 | 1.671 µs |
这轮单页迁入的主要耗时在迁移前的 LRU / RCU 同步,页内容复制只占很短的一段。 源码也对应这条路径:kernel_move_pages 调用 do_pages_move,后者在处理待迁移页前调用 lru_cache_disable;lru_cache_disable 先等待 RCU 同步,再排空各 CPU 暂存的 LRU 页批次,让页进入可查找、可隔离的状态,然后继续迁移。迁移入口源码、LRU 同步源码
前四轮绘图用的汇总数据和逐样本数据一并保留。逐样本时间单位为 ns;正文换算为 µs。
第六轮另附函数耗时汇总和240 个准备阶段样本,与前四轮访问计时数据分开保存。函数耗时单位为 µs,逐样本墙钟时间单位为 ns。
注:实验口径与适用范围
模拟设备。 本轮 CXL CT3 由 RAM 后备,没有真实硬件压缩;数字不代表 CRAM 硬件延迟、压缩率或容量倍率。作者 LPC PPT 的性能演示也标注了 DRAM 后备以隔离 fault 成本,不能作为真实设备的端到端性能报告。
版本与配置。 RFC v4 是设计提案,接口不作为稳定规范;实验另固定到具体 commit,不假定与 RFC 逐行相同。zram 文档滚动更新,实际功能取决于内核版本和配置。嵌套虚拟化测试启用了
CONFIG_CXL_REGION_INVALIDATION_TEST=y,绕过相应 cache integrity 检查,仅用于隔离模拟 guest。访问与计时。 “读不 fault”指无需通过 swap fault 恢复压缩页,不排除其他原因的 fault,也不表示设备读取没有延迟。cache 状态未控制,首次应用读不保证 cache miss;store 未用
mfence排空 store buffer。计时包含开销,没有统一减去常数,0.187 µs 不能解释为真实设备读取延迟。容量与批次。 CRAM 模型额外配置了 512 MiB RAM 后备空间,zram 使用普通 RAM 保存压缩对象,两者未按相同物理内存预算配置。压力分布是抽样快照,不能用于比较压缩容量。原升温对照只测了单批、固定顺序,未做多轮随机化;覆盖 64 MiB 页范围但实际只写 128 KiB,不据此计算写带宽或硬件性能排名。
事件与验收。 首次写的 fault 次数属于独立 trace 批次,不是固定规则,也不套用到 9000 个计时样本。设备水位由 QMP 注入,未验证真实占用自主触发告警。OOM 通过指预期进程终止和 guest 恢复,不代表被终止的 workload 完成内容校验,也不作为长期稳定性结论。
NUMA 自动平衡。 跨 node 访问本身不要求 fault;启用自动 NUMA balancing / memory tiering 时,内核可能主动修改页映射,通过 NUMA hinting fault 采样并决定迁移。这与 zram 的 swap fault、CRAM 的写保护 fault 是不同机制。“首读无 fault”描述的是本轮观测路径,不排除其他策略下的 hinting fault 或读热页迁移。内核 NUMA balancing 说明
逐页着色。 单次升温与反复写入是不同负载,位置变化统计不用于归因原升温耗时或量化业务性能损失。正式观察组采到 573 次快照,共 1,100,160 个样本状态,其中 4 个未确定。每次快照完成后等 20 ms 再采样;单次快照中位数 2.149 ms,快照并非原子操作,短暂往返可能漏采,未知状态会打断转换序列。相同的首次升温在连续采样组为 484.679 ms,关闭连续采样组为 349.936 ms;两组保留相同观察器缓存,各在新 guest 中执行并全量校验通过。这些数不与前四轮升温耗时混为同一基准,也不用于硬件性能排名。固定内核未启用
CONFIG_NUMA_BALANCING,按配置核对。原样导出串口的尝试出现导出阶段卡顿告警,已保留诊断日志并改用无损编码重跑,本文只采用重跑后完整、无告警的两组结果。准备阶段归因。 第三轮 direct 组的
move_pages最大值为 96.789 ms,未保存该样本的完整 trace,保留为未定位的极值。第六轮关闭详细 tracing 的最大值为 11.067 ms,完整 trace 批次最大墙钟时间为 681.744 µs;这轮定位的是采到的迁入路径,未复现原极值。两轮数据分别保留,数值变化不作为优化收益。表中的函数时间包含子调用,启用了 function graph 的 sleep-time,包含函数内等待;嵌套行不能相加。局部写实验为 8 字节修改,未覆盖整页覆盖写等其他写入模式。函数耗时图。 图来自第二轮四组单页用例开启 function_graph 的单次记录。函数时间包含子调用,嵌套时间不相加;第二轮未记录绝对时间戳与调度事件,因此条形图展示函数耗时,不能据此还原连续时间线或区分运行与调度等待。图中“无 fault 调用”不是零访问时间。该批次的 tracing 开销与正文第三轮 9000 个关闭详细 tracing 的访问样本分开,不把两批数字拼成同一次操作。页进入图只覆盖所列迁移 / 换出函数,不是完整准备阶段耗时。
附:启动命令与测试脚本
下载复现脚本包,或直接查看操作说明。包内包含测试 C 程序、guest 初始化、initramfs 构建、QEMU 启动、QMP 水位注入和日志分析脚本,以及固定内核配置。脚本使用所在目录定位文件;内核与 QEMU 二进制由读者按固定版本构建。
| 测试 | 程序 | 对应结果 |
|---|---|---|
| 第二轮读写路径 | probe.c | CRAM / zram 的 direct、readwrite、readrepeat 六组 trace |
| 第三轮访问计时 | bench.c | 9000 个成功样本,含准备时间、首次与重复读写 |
| 第四轮压力与回退 | stress.c、QMP 注入脚本 | 自动降级、阻止迁入、zram 回退及恢复;oom 子目录为无 swap 边界用例 |
| 第五轮逐页着色 | color.c | 固定逻辑页位置采样、分段反复写入、观察器控制组 |
| 第六轮迁入归因 | prepare.c | 200 个普通计时样本、40 个完整 move_pages trace |
第六轮的 QEMU 启动命令如下,在该用例目录运行。build-linux、build-qemu、qemu 指向固定版本的构建和源码目录;initramfs.cpio.gz 由该用例的构建脚本生成。
timeout 180 build-qemu/qemu-system-x86_64 \ |
其中普通 RAM 为 512 MiB,cxl-mem0 为额外的 512 MiB RAM 后备设备空间;固件窗口为 1 GiB。guest 初始化脚本把模拟设备绑定到 cxl_compression,查询 has_private_memory 获得 CRAM node 编号,再设置 zram 的 LZ4 算法与 256 MiB 逻辑设备大小。
例如,在 Linux 测试机上执行第六轮:
cd reproduce/prepare-profile |
输出为 results.json、samples.csv、functions.csv 和完整 move.trace。其他轮次的运行顺序、页着色两组参数以及压力测试的 QMP 注入入口,见脚本包操作说明。所有命令启动临时 guest,guest 的关机命令在 initramfs 内执行。