最近在 8 张 BW1100 上跑 DeepSeek-V3.2 W8A8,顺手做了一次 Profiler 分析练习。这篇文章主要记录分析过程:先看不同负载下的 kernel 时间分布,再根据热点整理后面值得继续确认的问题。
它不是一份完整的性能报告,也不讨论跨平台排名。里面的数字只用于理解这套环境中的瓶颈变化。
测试环境是 8 张 BW1100,TP=8,推理框架为 vLLM 0.18.1 + vllm-hcu 0.18.1。模型使用 W8A8 权重、BF16 激活、FP8 KV cache。基线已经启用了 chunked prefill、prefix cache、FlashMLA、global MoE cache、通信计算重叠和 NUMA 绑定。
换句话说,这不是从一个完全没有优化过的配置开始捡低垂果实。
Phenomenon
基线的 1K 输入、1K 输出测试中:
| 并发 | 输出吞吐 | TTFT Avg | TPOT Avg |
|---|---|---|---|
| C1 | 35.04 Token/s | 315.9 ms | 28.25 ms |
| C8 | 168.55 Token/s | 181.2 ms | 40.39 ms |
| C32 | 457.97 Token/s | 3083.5 ms | 66.89 ms |
从结果看,随着并发增加,总吞吐继续上升,但排队和单 token 延迟也在增加。这种场景下,直接问“哪个参数最快”没有意义。至少要先区分三个目标:
- 单路或低并发 Decode 延迟。
- C8/C32 下的均衡吞吐。
- 长上下文 Prefill 和严格 TTFT。
它们很可能需要不同配置。
Start from the Profiler
这轮分析取 Rank0 设备 kernel 的累计时间,把算子粗分为通信、MoE、MLA/Attention、量化、GEMM 和 Norm/Activation。
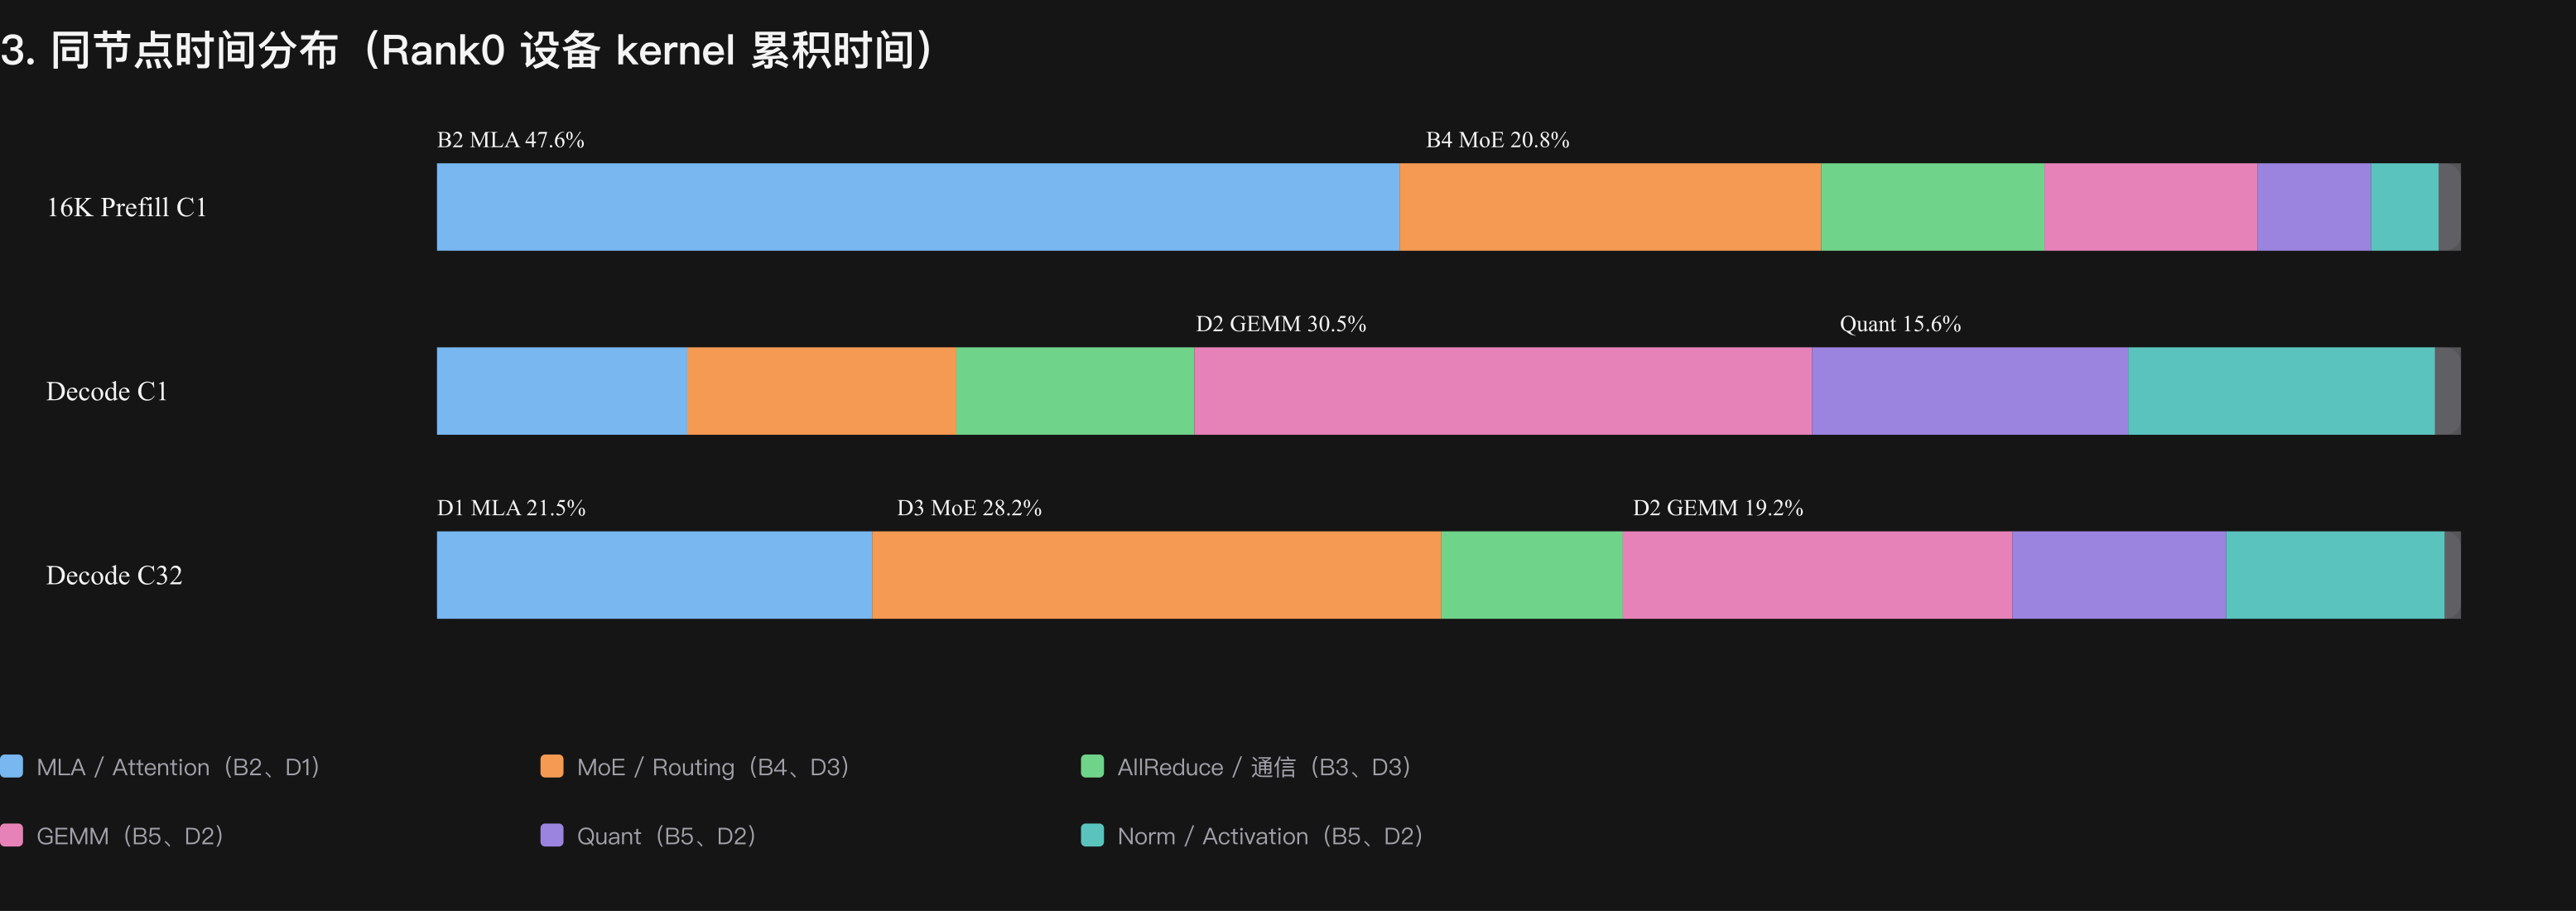
| 场景 | 通信 | MoE | MLA/Attention | 量化 | GEMM | Norm/Activation |
|---|---|---|---|---|---|---|
| Decode C1,128→16 | 11.8% | 13.3% | 12.4% | 15.6% | 30.5% | 15.2% |
| Prefill C1,16K→1 | 11.0% | 20.8% | 47.6% | 5.6% | 10.5% | 3.3% |
| Decode C32,1K→16 | 9.0% | 28.2% | 21.5% | 10.6% | 19.2% | 10.8% |
这里最重要的不是某个百分比,而是三个场景的形状完全不同。
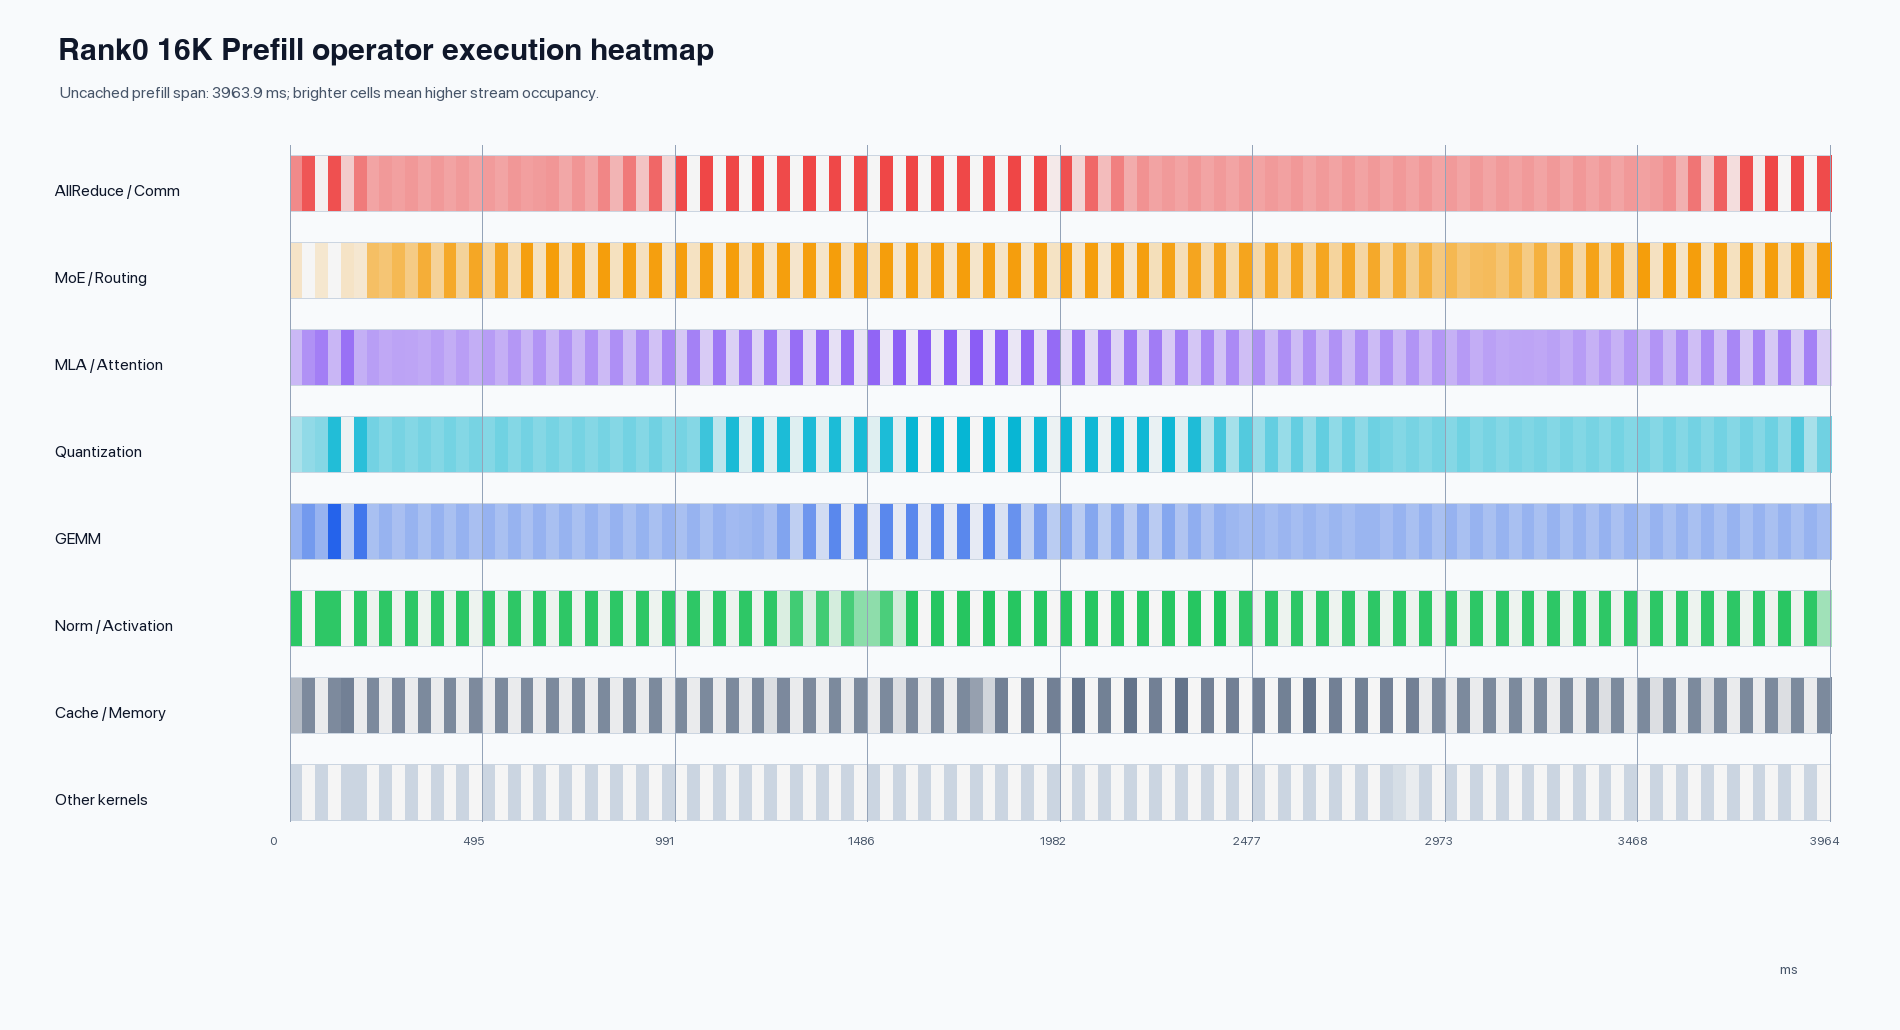
16K Prefill 明显由 Attention 主导。sparse_attn_fwd_kernel 占 29.5%,mqa_logits_fp8 占 17.3%。如果目标是长上下文 TTFT,应该优先看 Attention、长 Prefill 切分和调度,而不是盯着普通 GEMM。
C32 Decode 中,MoE 占比上升到 28.2%,MLA/Attention 为 21.5%,GEMM 下降到 19.2%。高并发时,MoE、Attention 和跨卡归约共同决定结果,也不存在一个可以单独解决问题的“大算子”。
C1 Decode 看起来 GEMM 最高,但展开时间轴后,会看到一条由大量量化、GEMM、Norm、Attention、MoE 和通信 kernel 组成的密集链。
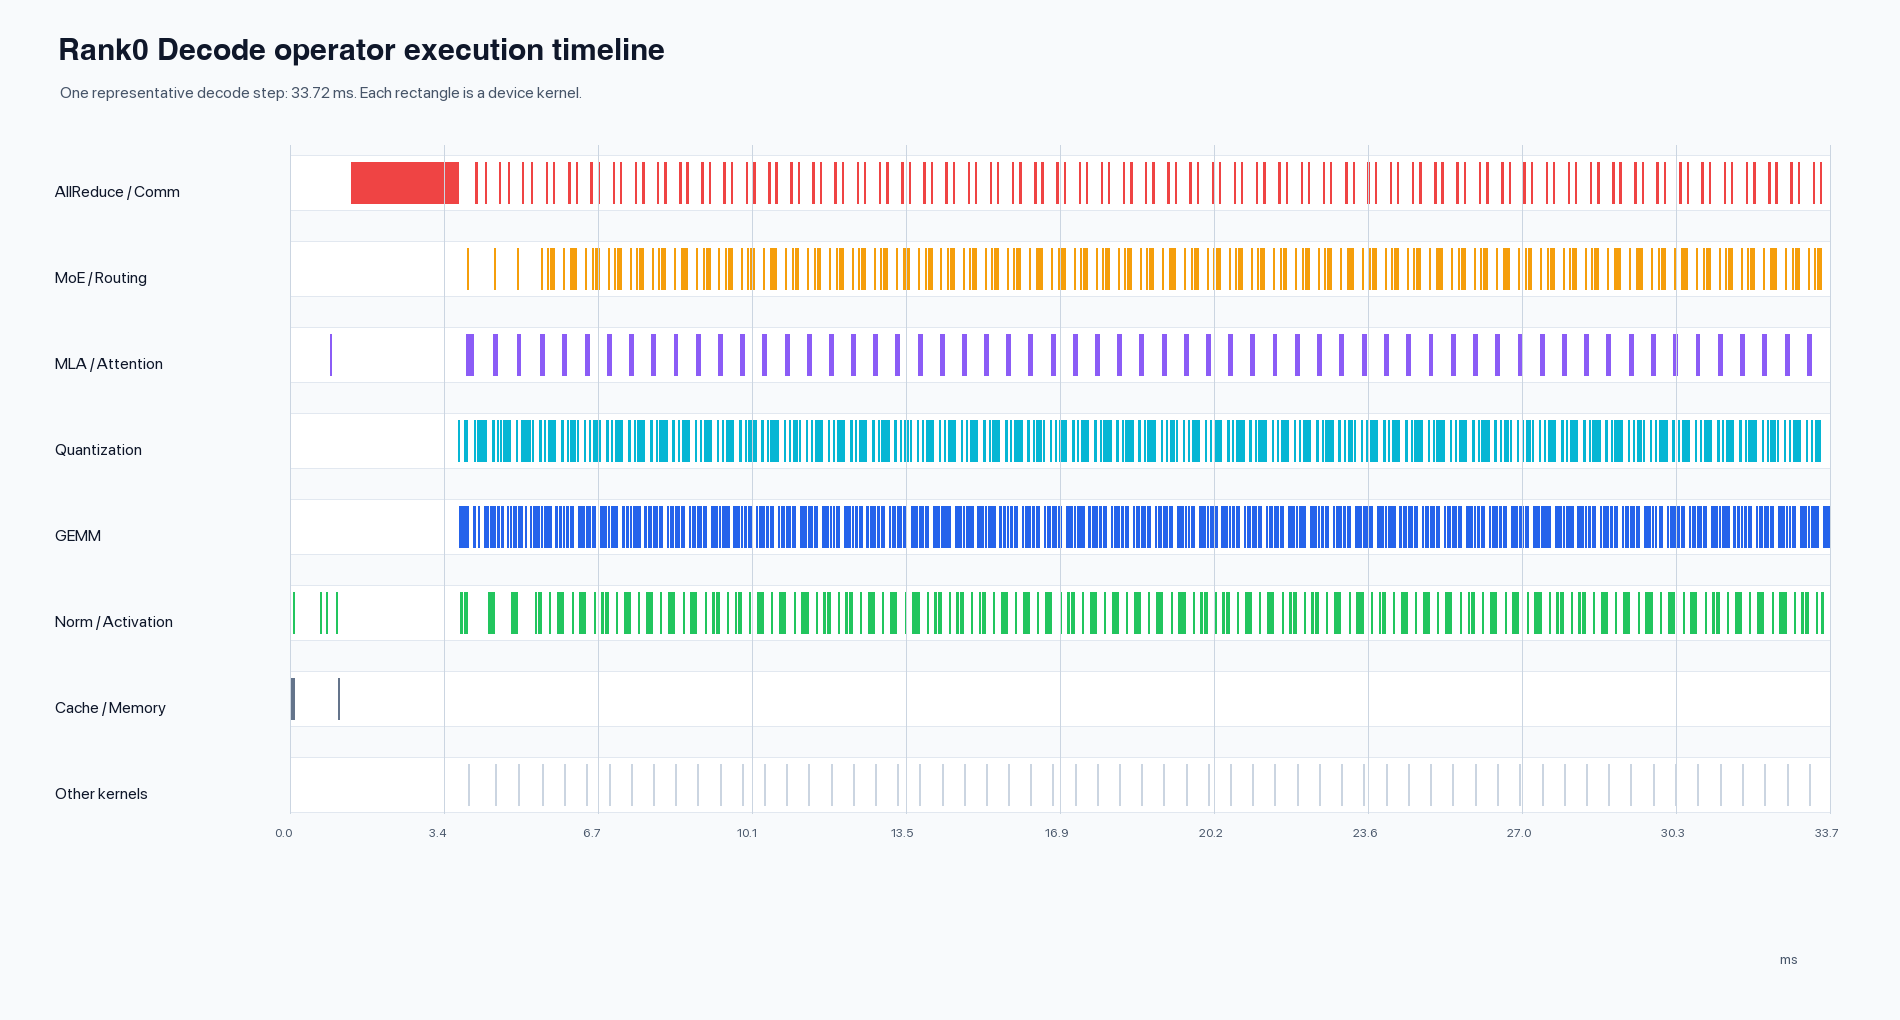
这给出的一个方向是:Decode 不一定缺少某个更快的 GEMM,更可能需要减少 launch、同步和重复计算。不过 Profiler 只能帮助提出问题,不能直接证明某种改法一定有效。
几个需要说明的地方
上面的数字还有几处不能看得太满:
- Profiler 占比来自 Rank0 设备 kernel 累计时间;stream 重叠可能造成重复计时,不能把各项占比理解成严格的 wall-clock 分解。
- 结果绑定于这套模型、W8A8 量化、KV cache、框架/插件版本和 8×BW1100 配置。模型、精度、tokenizer、缓存状态和请求分布没有对齐时,这些数字不适合拿去做横向比较。
后续工作
这次先停在 Profiler 分析。后面如果继续做,会先把测试方法固定下来,再逐项验证:
- 补充不同输入长度和并发下的 trace,确认热点变化不是单个样本造成的。
- 把 Prefill 和 Decode 分开看,分别记录 wall-clock、设备时间、TTFT、TPOT 和吞吐,避免混在一起解释。
- 针对 Decode 的小 kernel 链测试融合、调度和 speculative decoding,但一次只改一个变量。
- 针对长 Prefill 继续拆 Attention、MoE 和通信时间,确认优化空间到底落在哪一层。
- 补齐请求数、正确性、显存和 P50/P95/P99 后,再决定哪些结果值得单独写。
现在这些更多还是拿数据和熟悉工具,先不急着下结论。