上一篇把 PLE 和显存外专家放进 64GiB 内存后,代码生成已经摆脱了反复读盘的等待。这次继续看一个新问题:3090 解锁浮点 Tensor Core 的指令发射速率后,Strata 跑同一个 Qwen 模型,实际能快多少?
本文的解锁前后对照全部来自同一台新建的 32vCPU / 64GiB 虚拟机。本文把测试分成两层。先保持引擎配置不变,测出硬件解锁的直接收益;随后拆分请求耗时,调整计算路径、prefill 分块和 CPU/PCIe 分工,寻找这台机器上的实用配置。全文使用同一份 IQ2_XS 权重,保留全部选中专家的贡献。
同配置补测显示,大分块prefill的解锁收益约13%~19%,decode尚未观察到稳定提速。继续在解锁状态调框架后,17K抽取TTFT从13.49降到5.95秒,减少55.9%;日常候选18432保留相近等待,并留下约8GiB系统内存。本文把这些已测提升与后续的decode研究问题分别记录。
先把解锁的收益量出来
本轮 3090 使用相同的 350W 功耗上限、580.126.09 驱动和 CUDA 12.8。8192³ 的 FP16 输入、FP32 累加 GEMM 从 76.65 提高到 122.34TFLOPS,增加 59.6%;BF16 从 76.09 提高到 125.12TFLOPS,增加 64.4%。六组不同形状与输入格式的完整输出均逐位一致。
接着让 Strata 按原配置处理六类请求,每种状态启动三次服务、每次跑两轮,共 36 个请求。4392-token 抽取的 TTFT 中位数为 4.187 → 4.079 秒;17352-token 为 13.928 → 13.486 秒,分别减少 2.6% 和 3.2%。两组任务通过数均为 34/36。
这里的 TTFT 从客户端发出请求计到首个可见文字;E2E 计到流式请求完整结束。prefill 和 decode 吞吐来自引擎返回的计时。两份修复题允许输出 2048 token,并保存完整回答和边界测试结果。
修复任务是实现指数退避函数 retry_delays(attempts, base, cap),检查零值、类型、初始值超过上限,以及 10000 次重试等边界。A、B 分别冻结一份有溢出问题的首答,再提供相同的 OverflowError 反馈,让模型继续修复。每个配置收到的完整对话历史保持一致。
算力提升首先体现于大矩阵乘。Strata 的完整请求还要做专家路由、权重整理、CPU 调度、PCIe 搬运,以及逐 token 的验证和草拟,因此接下来要找的是这些步骤各占多少时间。
17K 输入的十三秒花在哪里
本文先单独打开引擎的 prefill 分项计时,再用关闭插桩的请求记录速度。17K 输入的诊断时间线为 13.66 秒:
| prefill 分段 | 时间 | 占比 |
|---|---|---|
| 复制等待 | 3.927 秒 | 28.7% |
| 权重整理等,源码标记 dequant | 2.221 秒 | 16.3% |
| 专家 gate/up 等 | 2.230 秒 | 16.3% |
| 专家 down 等 | 1.116 秒 | 8.2% |
| 其余阶段 | 4.166 秒 | 30.5% |
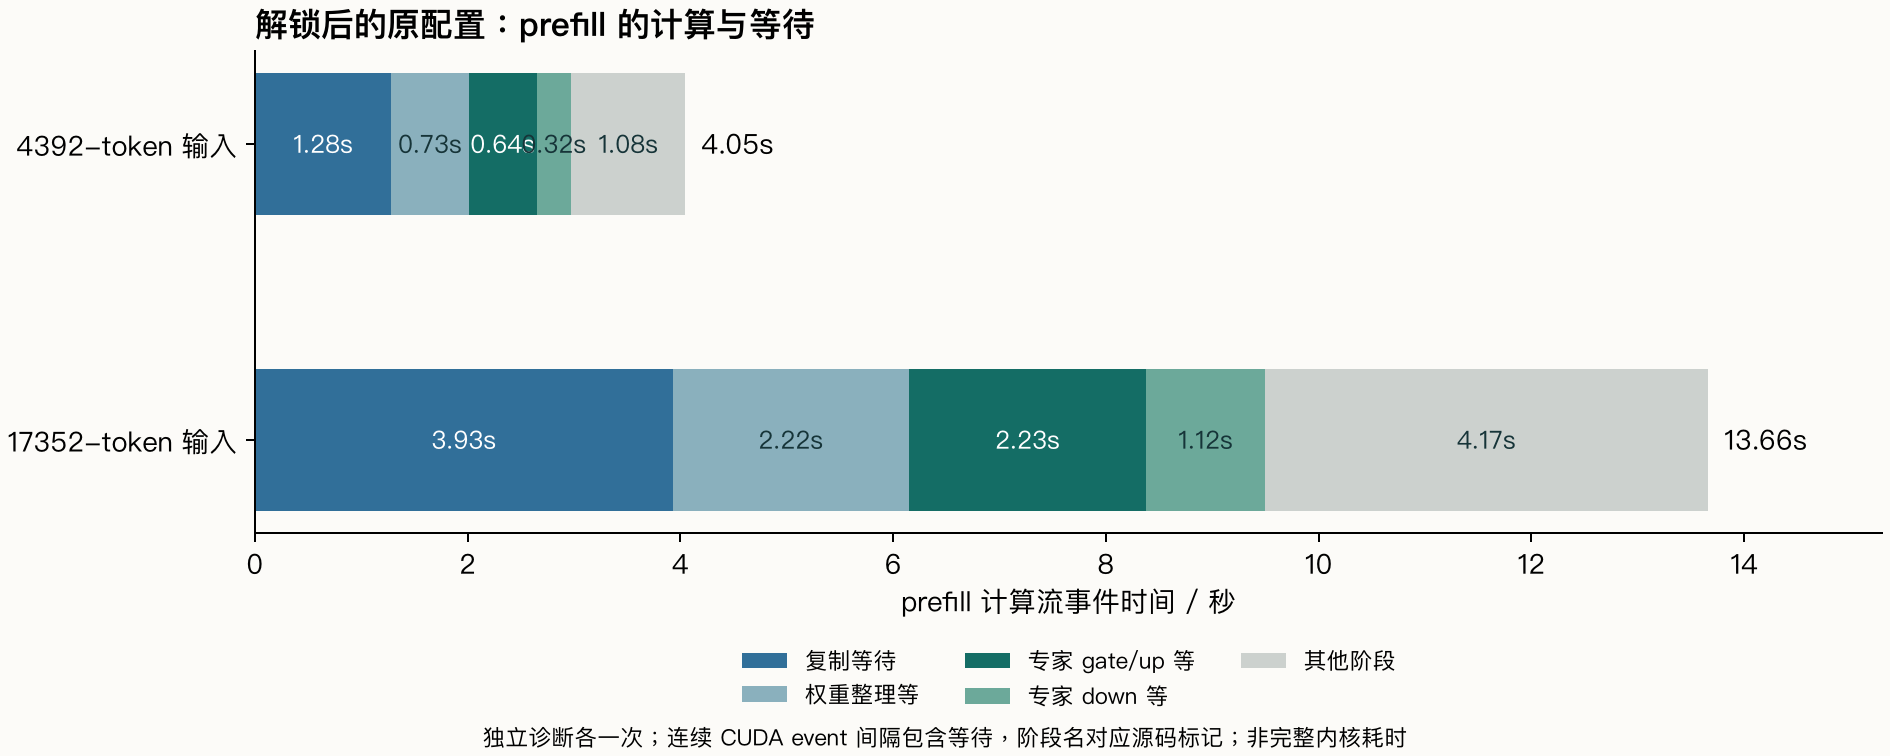
这些分段按计算流上连续的 CUDA event 计时。GPU 等复制或主机工作时,间隔会记入相应阶段。默认 MMQ 路径里的 dequant 标记包括量化权重的 gather 和格式整理;gate/up 与 down 也包括配套的激活、量化等操作。本文据此定位优化方向。
解锁提升的浮点矩阵吞吐只作用于其中使用相应指令的部分。量化专家、拷贝等待和调度仍然要按原来的步骤完成。计时实现与专家路径
看同一个时间轴,区分读盘和 PCIe 搬运
资源采样与请求时间一起保存:引擎进程读盘与 major fault、GPU 利用率/功耗/时钟/显存每两秒一次,PCIe RX/TX 每秒一次。诊断中 GPU 利用率中位数 96%,显存峰值约 23.54GiB,PCIe RX 峰值约 12.5GB/s。
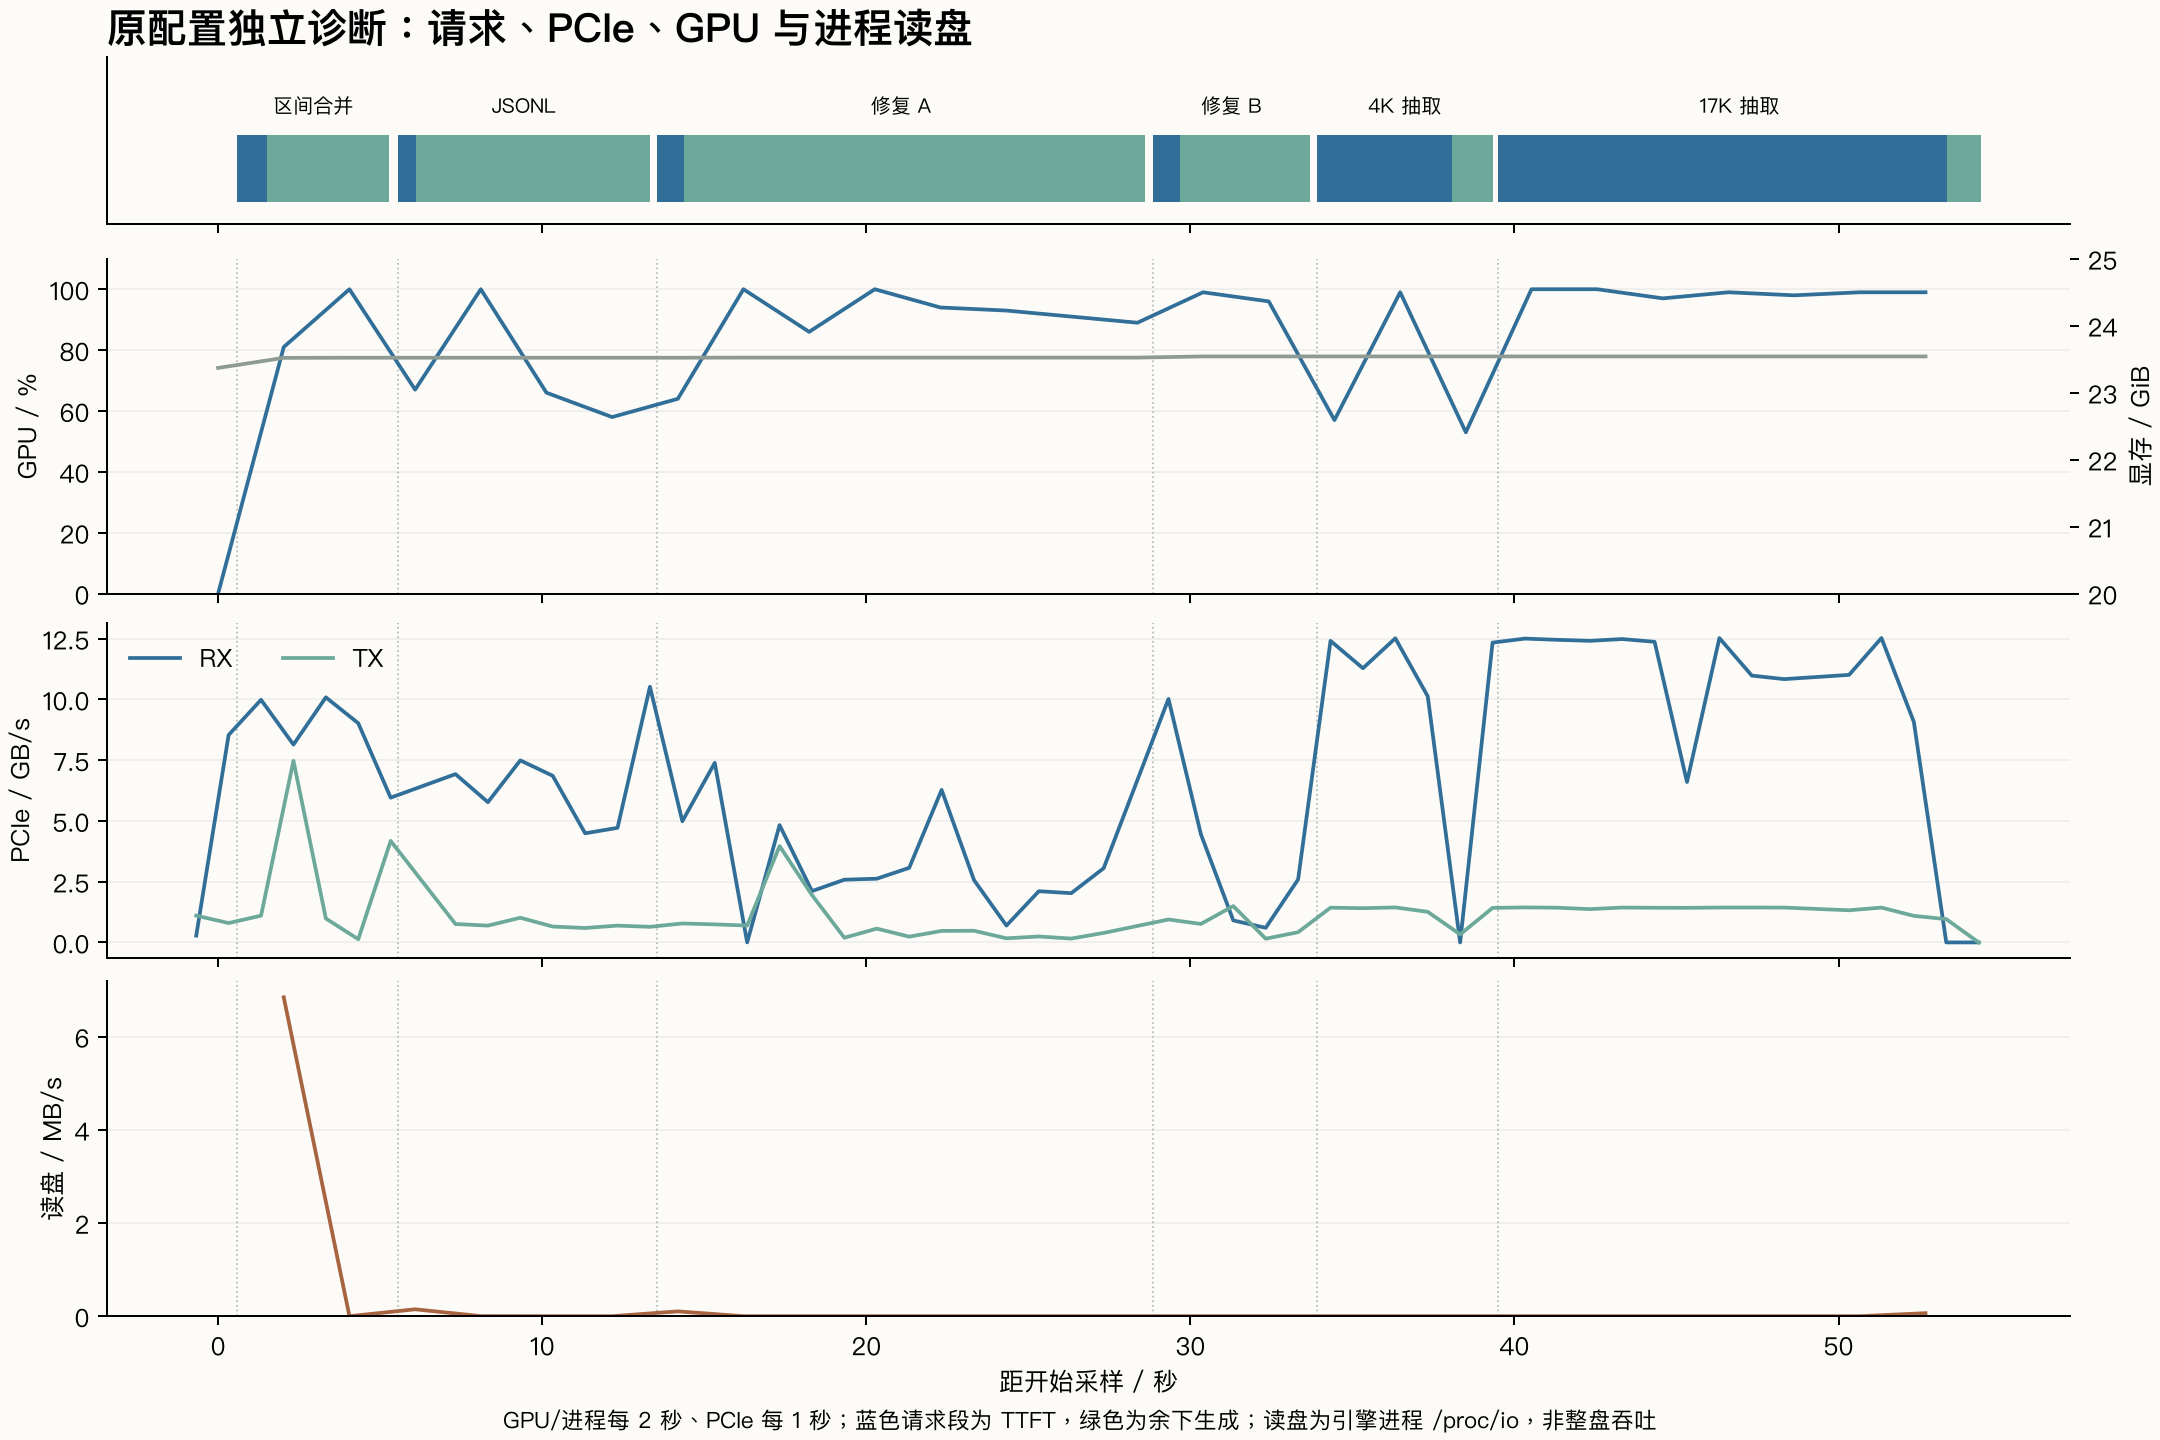
17K 处理期间,读盘很少,PCIe 接收流量持续活跃。本轮虚拟机负载下运行于 PCIe Gen3 ×16。PLE 与显存外专家驻留 RAM 以后,数据会沿 RAM → PCIe → GPU 继续流动;下一步可优化的是一份权重搬过来以后,能为多少 token 服务。
浮点专家和融合内核都实际试一下
固定 2048 分块,把 STRATA_PREFILL_MMQ=0 设为专家先反量化到 FP16、再进行浮点 GEMM。两轮筛选中,4K TTFT 约 4.30 秒、17K 约 14.18 秒,相比默认的 4.08 和 13.49 秒更长;四份修复输出有三份边界测试失败。本文保留原量化专家路径。
同样测试了 STRATA_PF_FUSED=1,运行日志确认进入融合 int8 专家内核。2048 分块下,4K/17K 的 TTFT 约 4.11/13.54 秒,与默认接近。开关已生效,收益由实际耗时决定。路径选择
增大分块,让一次搬运服务更多 token
prefill 按专家聚合当前块内的 token。同一个专家的权重搬入后,可以连续处理多个输入;块增大时,同一长输入需要重复遍历和搬运专家的轮数减少。
2048、4096、8192 的差异位于批量规模与暂存预算:三项都固定关闭 prefill CPU 分担,都采用大块的专家流式流程。此次比较可以观察在相同分工下继续增大块的效果。
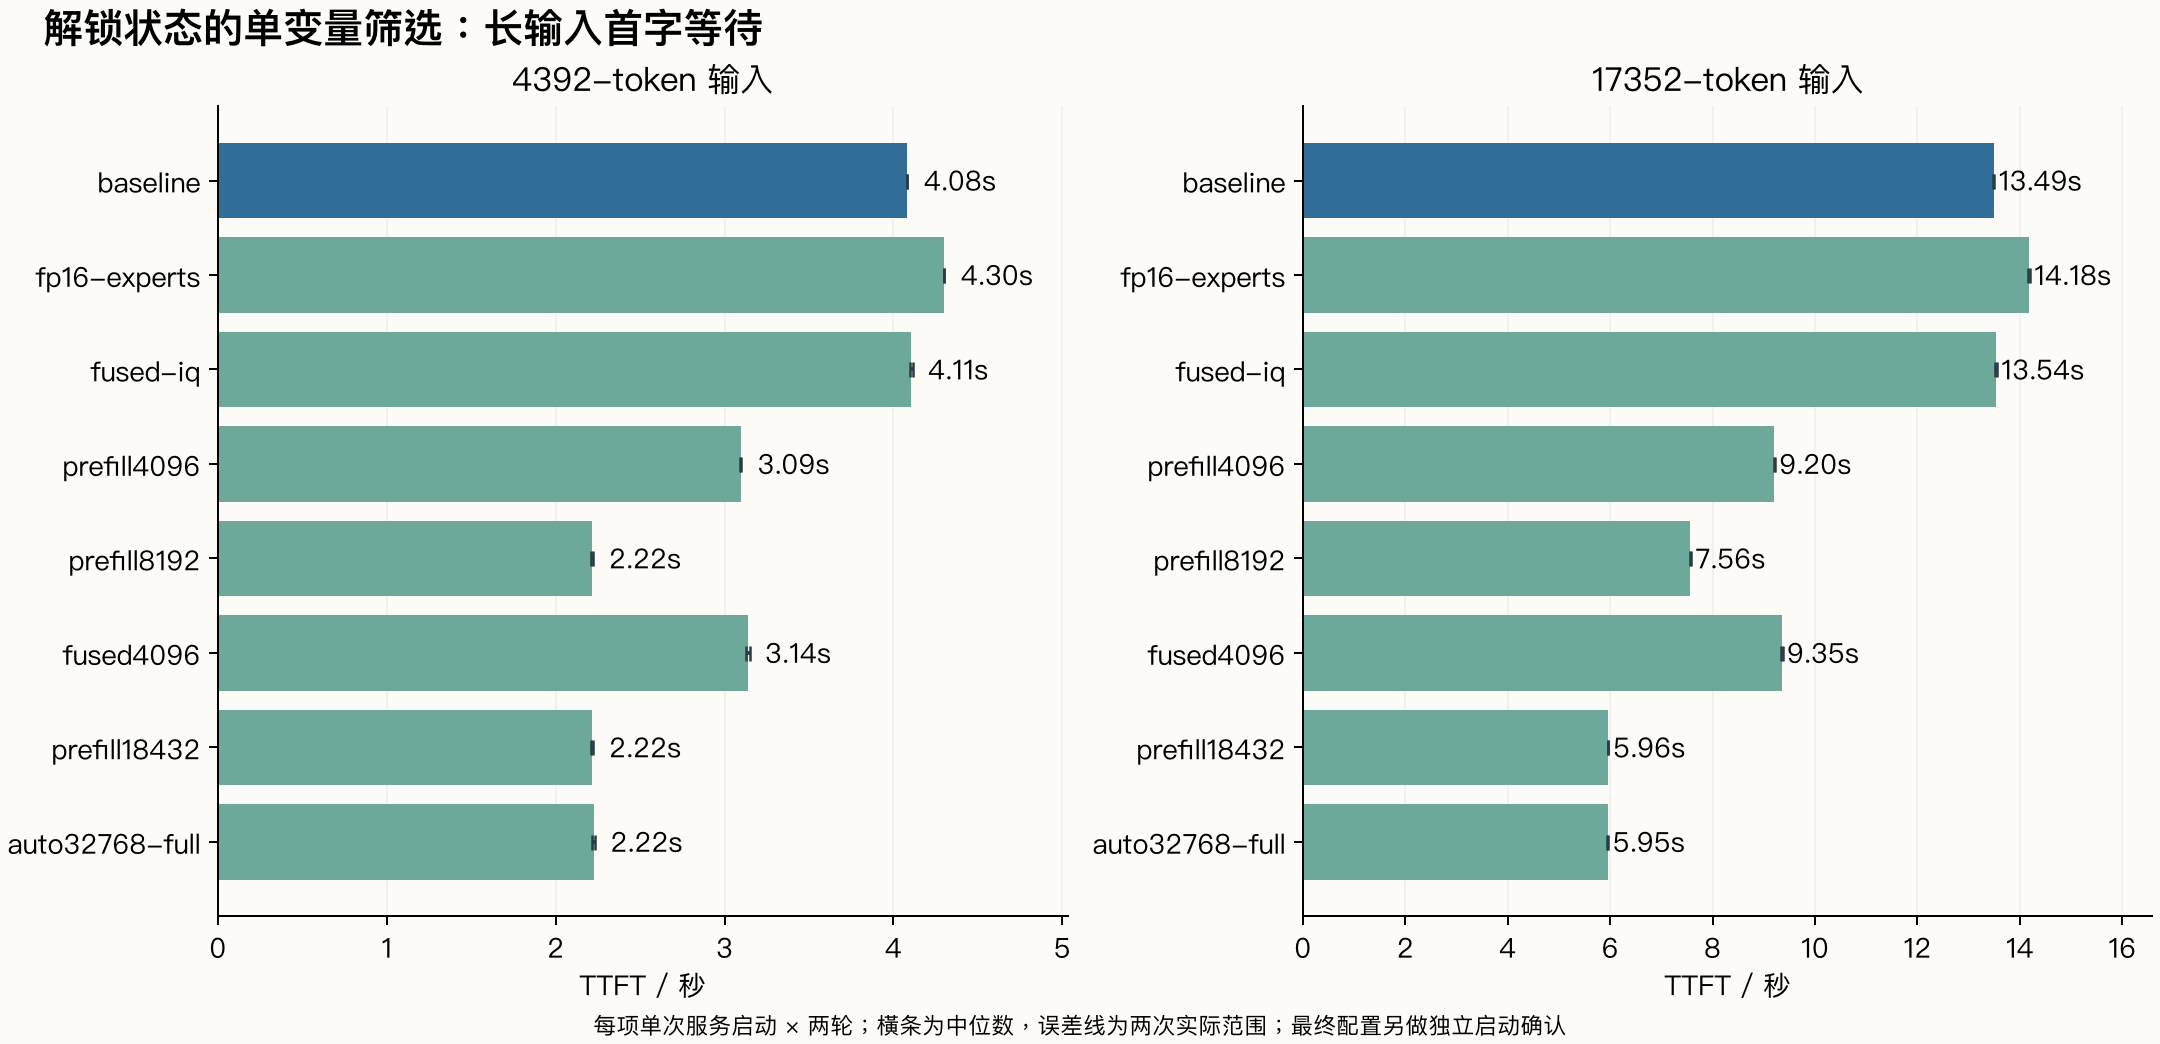
| 配置,PCIe份额1.0 | 4K TTFT / s | 17K TTFT / s | 通过 |
|---|---|---|---|
| 2048 / 默认MMQ | 4.081 | 13.486 | 12/12 |
| 2048 / FP16专家 | 4.300 | 14.180 | 9/12 |
| 2048 / 融合IQ | 4.106 | 13.536 | 11/12 |
| 4096 | 3.095 | 9.203 | 12/12 |
| 8192 | 2.216 | 7.563 | 12/12 |
| 4096 / 融合IQ | 3.139 | 9.353 | 9/12 |
| 18432 | 2.216 | 5.960 | 12/12 |
| auto:32768 | 2.224 | 5.952 | 12/12 |
表为每项一次服务启动、两轮筛选的中位数。最终峰值另做两次独立启动确认。
显存也要记账。2048 分块的 prompt 路径临时借用 861 个专家缓存槽,约 1.15GiB;4096 增为 1512 槽,约 2.03GiB;8192 的预算为 2812 槽,约 3.77GiB。短请求按实际 token 数借用;长请求在预算内借出空间,prompt 阶段可驻留的专家相应减少。源码在 decode 验证前把专家填回原来的槽位,并恢复驻留表。借用与归还收益来自更少的重复搬运与更大的批量,成本是 prompt 时留给专家缓存的空间。
decode 再看 CPU 与 PCIe 怎么分
显存外专家有两条处理方式:CPU 在系统内存上计算,或把权重交给 GPU 计算。pcie_frac 决定其中交给 PCIe/GPU 的份额。GPU 浮点算力变化后,两条路径的平衡仍受量化内核、链路和 CPU 速度影响。
在 2048 分块的筛选中,pcie_frac=0.5 的 JSONL 代码 decode 中位数约 92.7 token/s,原配置约 78.9;区间合并约 75.0,对照 57.6。随后把该候选与 8192 分块组合,并测试相邻分担比例,确认完整任务耗时及修复质量。
MTP 窗口也做了 2、4、6、8 的对照。窗口越大,一轮可以尝试验证更多候选 token,同时增加草拟和验证成本。本文记录草稿接受数、输出长度和完整等待,最终按已测任务选取窗口。
| PCIe份额,prefill8192 | 区间合并 E2E / s | JSONL E2E / s | 修复 A / B 通过 |
|---|---|---|---|
| 1.0 | 3.533 | 6.836 | 2/2、2/2 |
| 0.75 | 3.133 | 6.238 | 1/2、1/2 |
| 0.5 | 3.273 | 6.225 | 2/2、0/2 |
| 0.25 | 3.098 | 6.061 | 1/2、0/2 |
每项固定8192分块,各两轮。0.5份额的修复B达到131.7token/s,但两次分别发生截断与沙箱CPU预算耗尽,完整等待11.13秒;1.0份额两次通过,4.62秒完成。
| MTP 窗口,prefill2048 / PCIe1.0 | JSONL decode / token/s | JSONL E2E / s | 六任务通过 |
|---|---|---|---|
| 2 | 71.7 | 7.716 | 12/12 |
| 4 | 78.9 | 7.058 | 12/12 |
| 6 | 77.6 | 7.220 | 10/12 |
| 8 | 73.7 | 7.604 | 10/12 |
把块放到更大,RAM 预算也跟着变化
继续设置 --prefill auto:32768 后,这台机器选中了 32768 的上限。17352-token 请求的批量部分为17351 token,单次诊断实际按17408 token布局,借出5747个专家槽。短输入按自己的长度布局;32768是预算上限。
这项配置同时扩大了RAM中保留的专家副本。较大的prompt工作区覆盖更多GPU专家槽,相应专家需要在RAM里留副本,结束时再填回。实测如下:
| prefill 上限 | 启动日志的最大借用预算 | RAM 专家副本 | loaded 后 MemAvailable |
|---|---|---|---|
| 2048 | 861槽 / 1.15GiB | 16.17GiB | 15.47GiB |
| 8192 | 2812槽 / 3.77GiB | 18.79GiB,全部锁页 | 12.72GiB |
| 18432 | 6072槽 / 8.14GiB | 23.16GiB,全部锁页 | 8.05GiB |
| auto:32768 | 10652槽 / 14.25GiB | 29.26GiB,29.00GiB锁页 | 1.61GiB |
PLE另占26.82GiB锁页内存。auto:32768的专家副本有约0.26GiB保持普通可分页内存,复制时需要经过锁页暂存;日志还记录了预算范围内少量专家没有RAM副本。18432的两轮17K TTFT约5.96秒,与大上限接近,系统可用内存增至8.05GiB。本文将auto:32768保留为峰值对照,把18432作为日常配置候选。
调优之后,剩下的时间在哪里
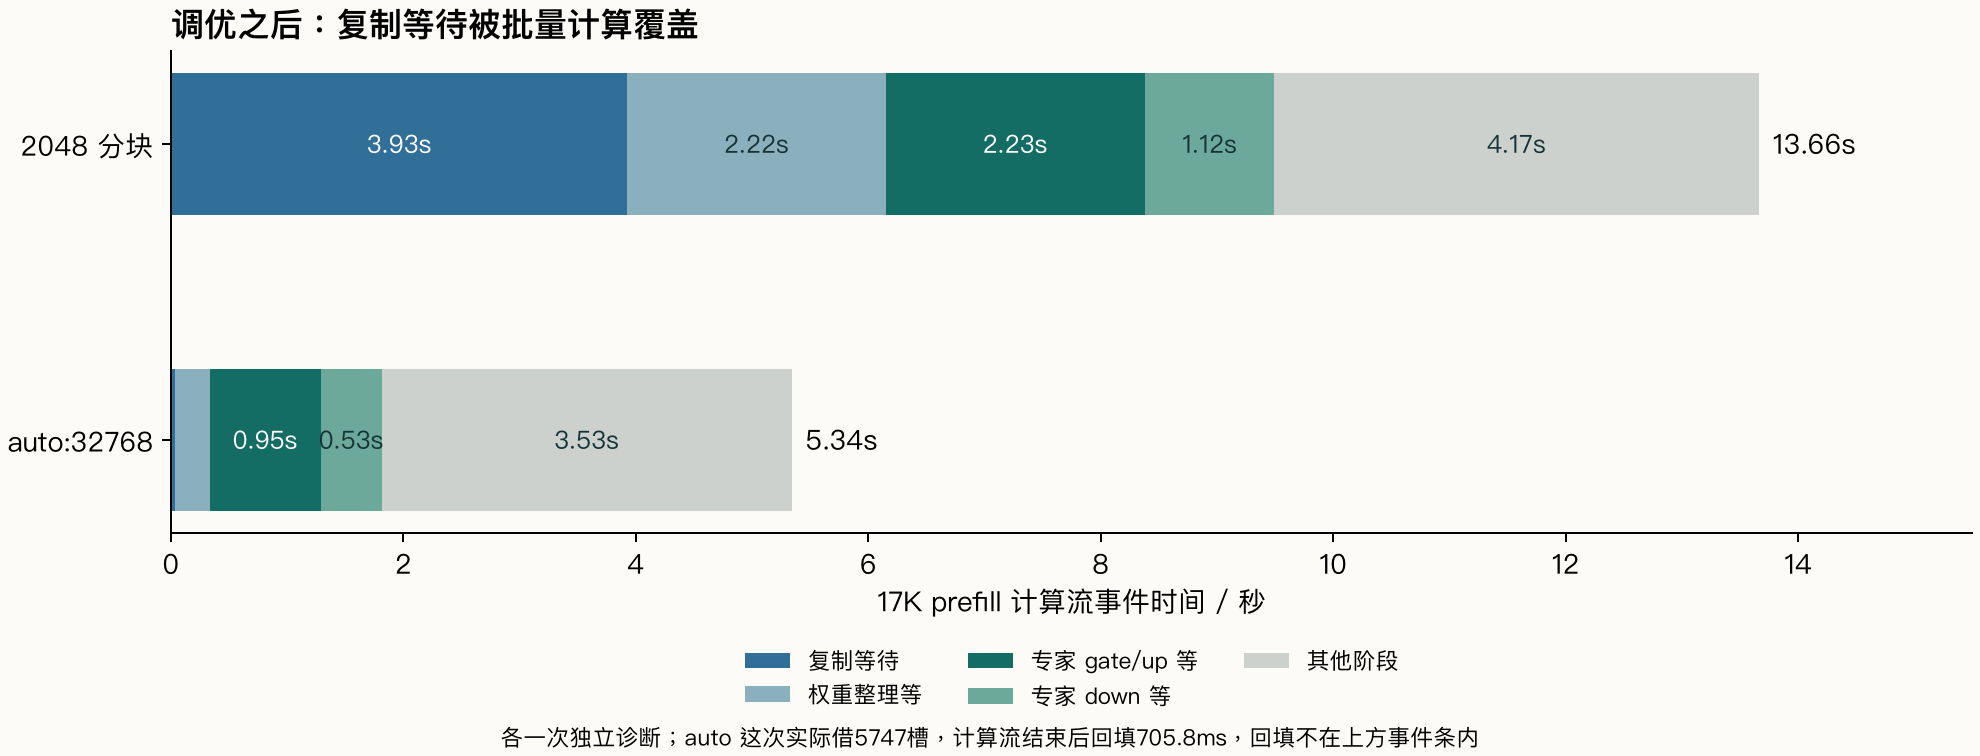
17K 输入的大上限诊断中,计算流时间由13.66降到5.34秒,复制等待由3.927降到0.037秒,权重整理等由2.221降到0.296秒,专家gate/up与down等合计由3.346降到1.480秒。这些数值来自独立诊断,正式TTFT采用关闭插桩的六次中位数。
大块让多次专家遍历合并,复制能够与较长的计算区间重叠。此时计算流结束后,还要把借出的5747槽填回,实测705.8ms;这次客户端TTFT为6.11秒。剩余时间分布在专家计算、hyper-connection、GDN、注意力与回填。后续若继续改引擎,优先观察这些具体阶段。
更快的PCIe可作用于尚在搬运与回填的部分,更大的显存可减少专家出入和借用。它们的收益可以沿用相同请求与时间线验证。本文的调优结果已经显示:选好批量和内存布局,比直接替换成浮点专家路径更有效。
最后留哪套配置
| 配置 | 每任务次数 | 4K TTFT / s | 4K prefill / token/s | 17K TTFT / s | 17K prefill / token/s | 六任务通过 |
|---|---|---|---|---|---|---|
| 未解锁 / 原2048配置 | 6 | 4.187 | 1056.0 | 13.928 | 1249.5 | 34/36 |
| 解锁 / 原2048配置 | 6 | 4.079 | 1084.0 | 13.486 | 1290.2 | 34/36 |
| 解锁 / auto:32768 峰值对照 | 6 | 2.218 | 2005.0 | 5.952 | 2933.0 | 36/36 |
| 解锁 / 18432 日常候选 | 4 | 2.216 | 2009.5 | 5.960 | 2929.1 | 23/24 |
| 任务 | 原配置 → 峰值 decode / token/s | 原配置 → 峰值 E2E / s | 输出 token 中位数 | 通过 |
|---|---|---|---|---|
| 区间合并 | 58.2 → 70.5 | 3.633 → 3.183 | 160 → 160 | 6/6 → 6/6 |
| JSONL 汇总 | 78.8 → 96.0 | 7.069 → 5.895 | 509 → 509 | 6/6 → 6/6 |
| 退避修复 A | 102.4 → 115.2 | 14.902 → 13.105 | 1420 → 1420 | 5/6 → 6/6 |
| 退避修复 B | 106.8 → 121.8 | 4.771 → 4.268 | 427 → 427 | 5/6 → 6/6 |
auto:32768在三个独立启动中完成36/36;17K TTFT中位数5.952秒、prefill2933token/s。相对同为解锁状态的原配置,TTFT减少55.9%。
日常选择18432:两个独立启动完成23/24,17K TTFT5.960秒,并留出约8GiB系统内存。唯一失败为第二次启动、第二轮修复B的10000次用例OverflowError;回答以stop结束,15项测试14项通过。短代码的吞吐、完整耗时和输出长度一并看,生成后的脚本/CI继续负责验收。当前服务已按此配置恢复。
补齐同配置对照,解锁主要快在哪一段
后续把 prefill 和 decode 分开测试。恢复端采用本卡最初日志中的性能选择寄存器原值,FP16/BF16 GEMM 已回到约 76TFLOPS,六组矩阵完整输出哈希与最初未解锁端一致。两端各完成 12 组、160 个正式请求,使用相同引擎、输入、量化、初始专家画像和对应配置。
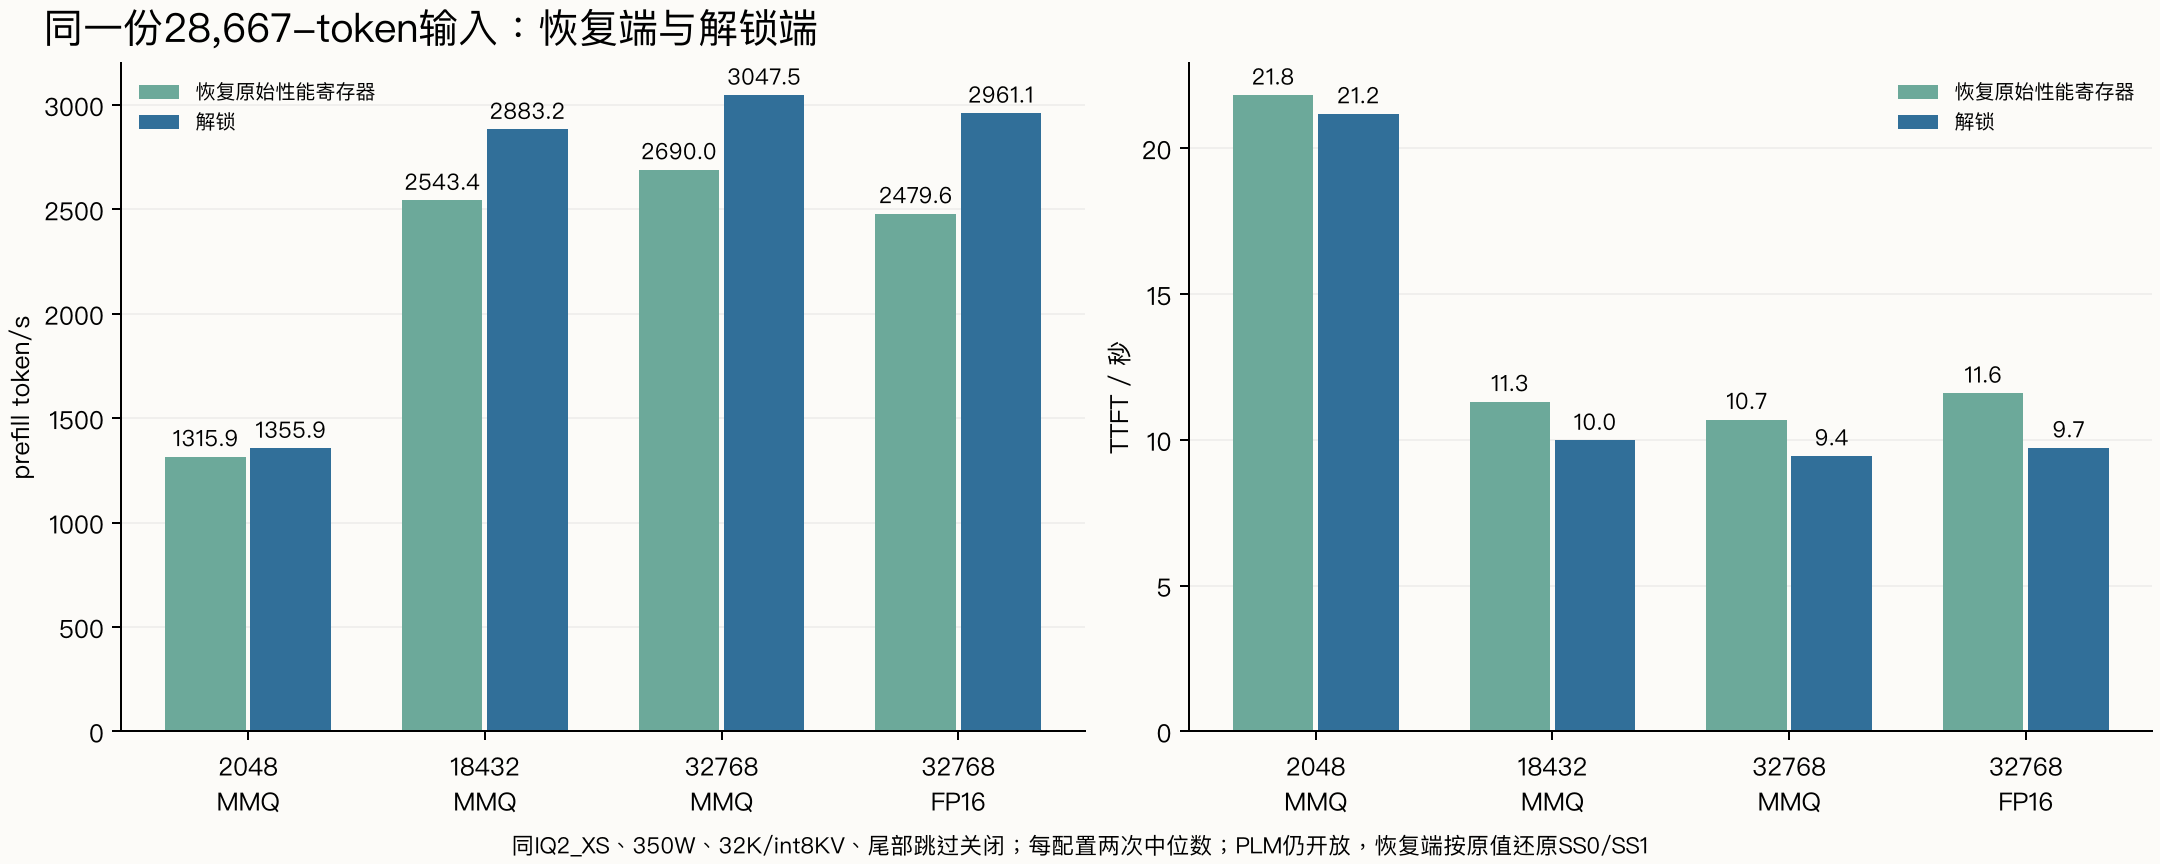
prefill 补测用同一份 28,667-token 合成记录,只生成 1 token,把测量集中在输入处理阶段。大分块下,硬件解锁的收益比原来 2048 分块更明显:
| 同一输入与配置,恢复端 → 解锁端 | prefill / token/s | 解锁带来的吞吐提升 | TTFT / s |
|---|---|---|---|
| 2048 / MMQ | 1315.9 → 1355.9 | +3.0% | 21.824 → 21.181 |
| 18432 / MMQ | 2543.4 → 2883.2 | +13.4% | 11.311 → 9.983 |
| auto:32768 / FP16 专家路径 | 2479.6 → 2961.1 | +19.4% | 11.602 → 9.725 |
18432 / MMQ 两端的专家副本均全部锁页,借出槽位的 RAM 备份也一致。FP16 路径获得更大的相对提升;解锁端的最高绝对 prefill 吞吐仍来自大分块 MMQ,本轮约 3047.5 token/s。
decode 则测同一批四个请求,每个生成 1024 token,分别以单流、两槽、四槽处理。同类代码与混合内容各两轮;单流还对照了缓存容量和 MTP 窗口。各配置的解锁前后吞吐差值约为 −6.2% 至 +6.3%,方向随配置和内容变化,本轮未观察到稳定的 decode 提速。大缓存 / MTP4 的整批吞吐为:同类请求 131.98 → 130.59 token/s,混合请求 89.63 → 86.94 token/s,两轮范围有重叠。
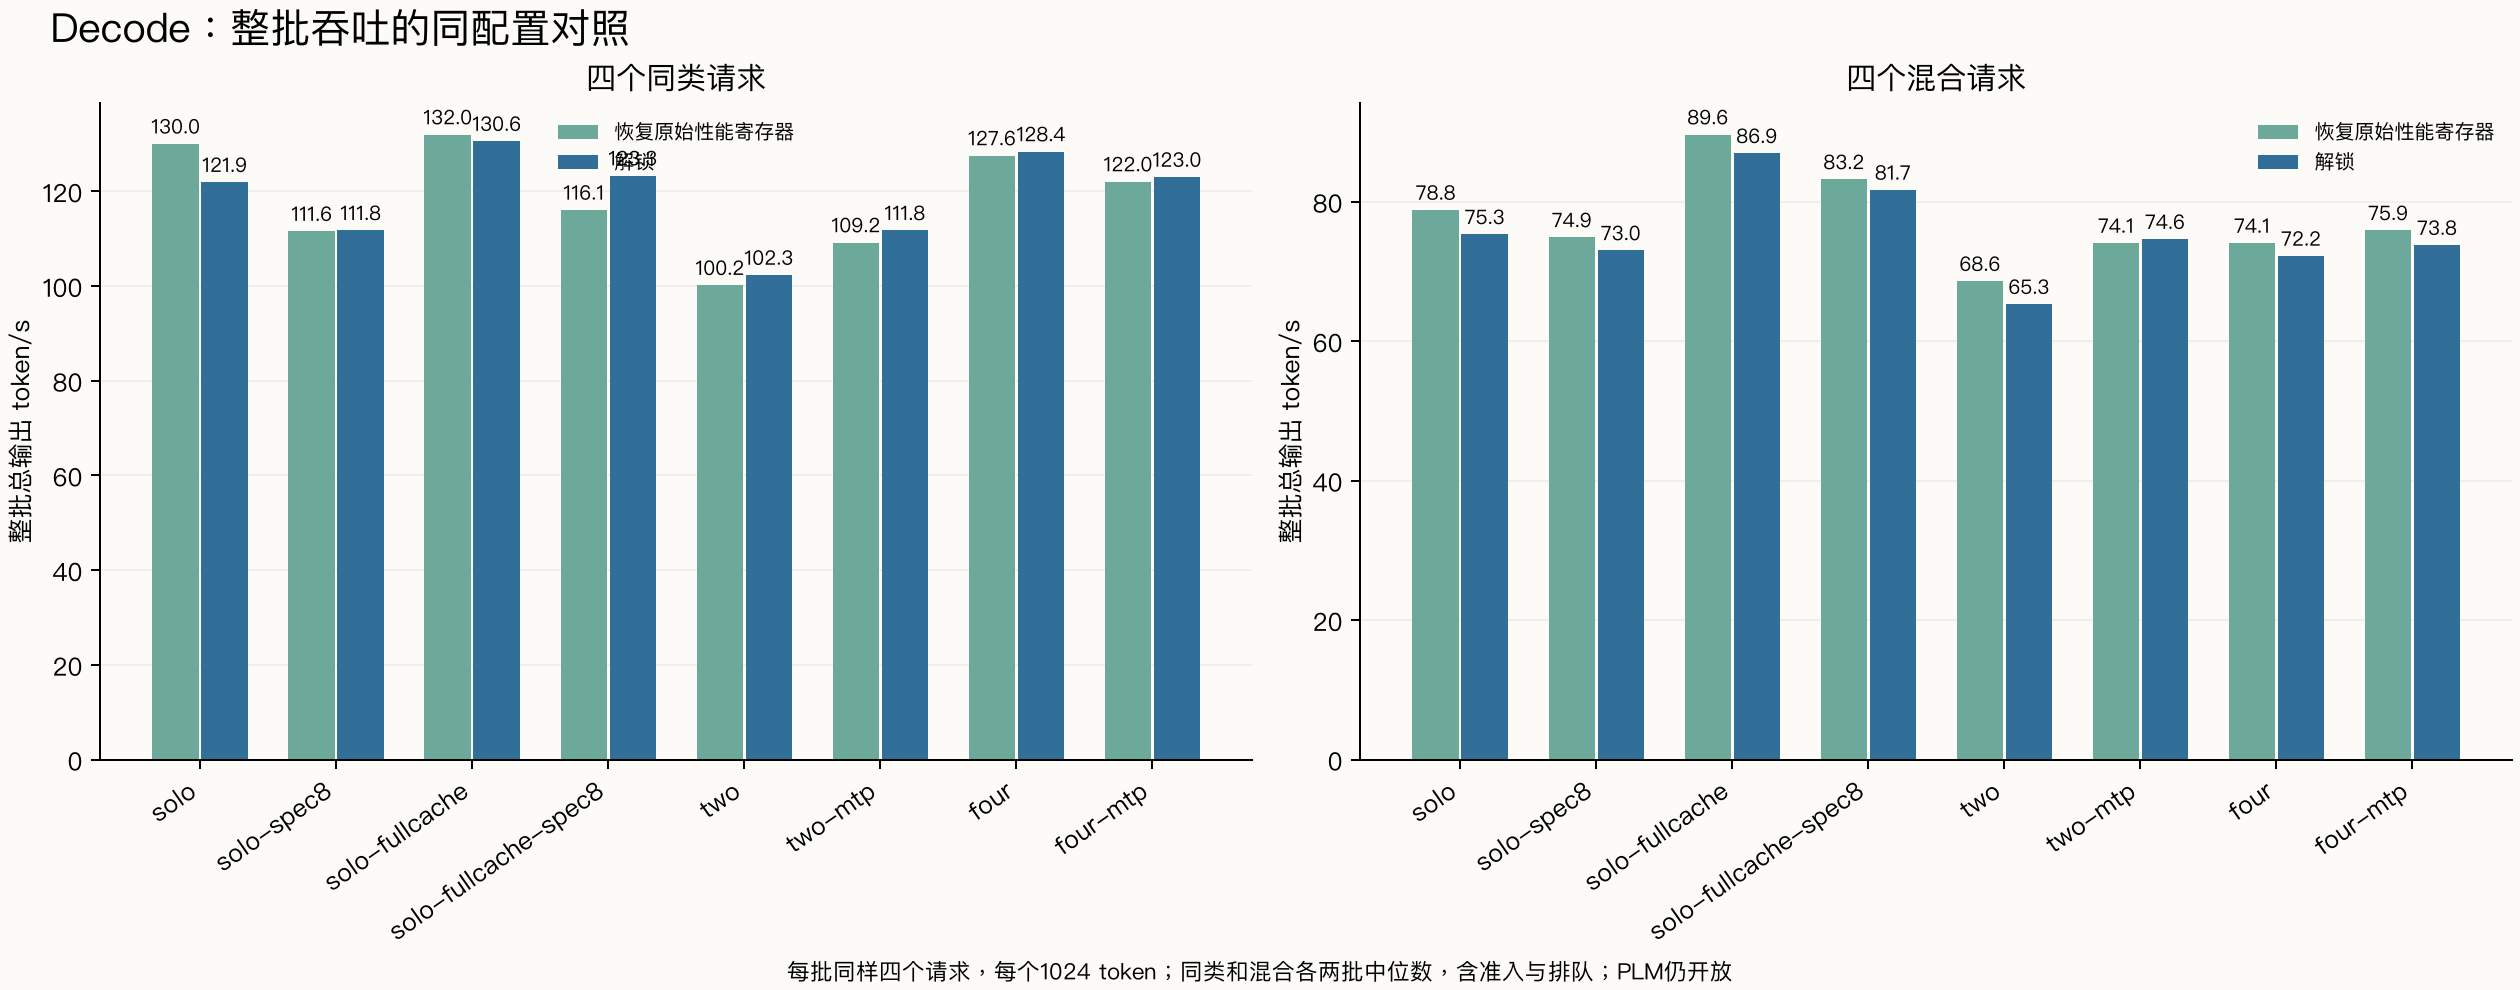
到这里,可以分别记下三笔收益:矩阵算力约提升六成;大分块 prefill 的同配置解锁收益约 13%~19%;前文 17K TTFT 减少 55.9%,来自同一解锁状态下的框架调优。 应用体验上,解锁更有助于缩短长输入等待,持续生成的速度改善仍取决于具体执行路径。分阶段对照与指标定义
Decode 的时间线,把搬运和等待再分细一点
接着完成了 82 个请求与三份 Nsight 时间线,分别记录正常速度、逐节点采样、图级采样和辅助分段。主线程负责推进验证、生成 MTP 草稿和等待交换完成;GPU 内部再执行路由专家、HC 混合、注意力和权重搬运。
在一份生成 512 token 的中文诊断请求中,decode 共 8.13 秒。主线程的验证为 5.69 秒、MTP 草稿 0.38 秒、等待缓存交换线程结束 1.08 秒。验证阶段内部,GPU 搬专家权重的 kernel 合计约 1.20 秒,等待 flag B 的自旋 kernel 约 41ms。这些是嵌套层次,表里的分项与 GPU 活动沿同一时间轴核对。
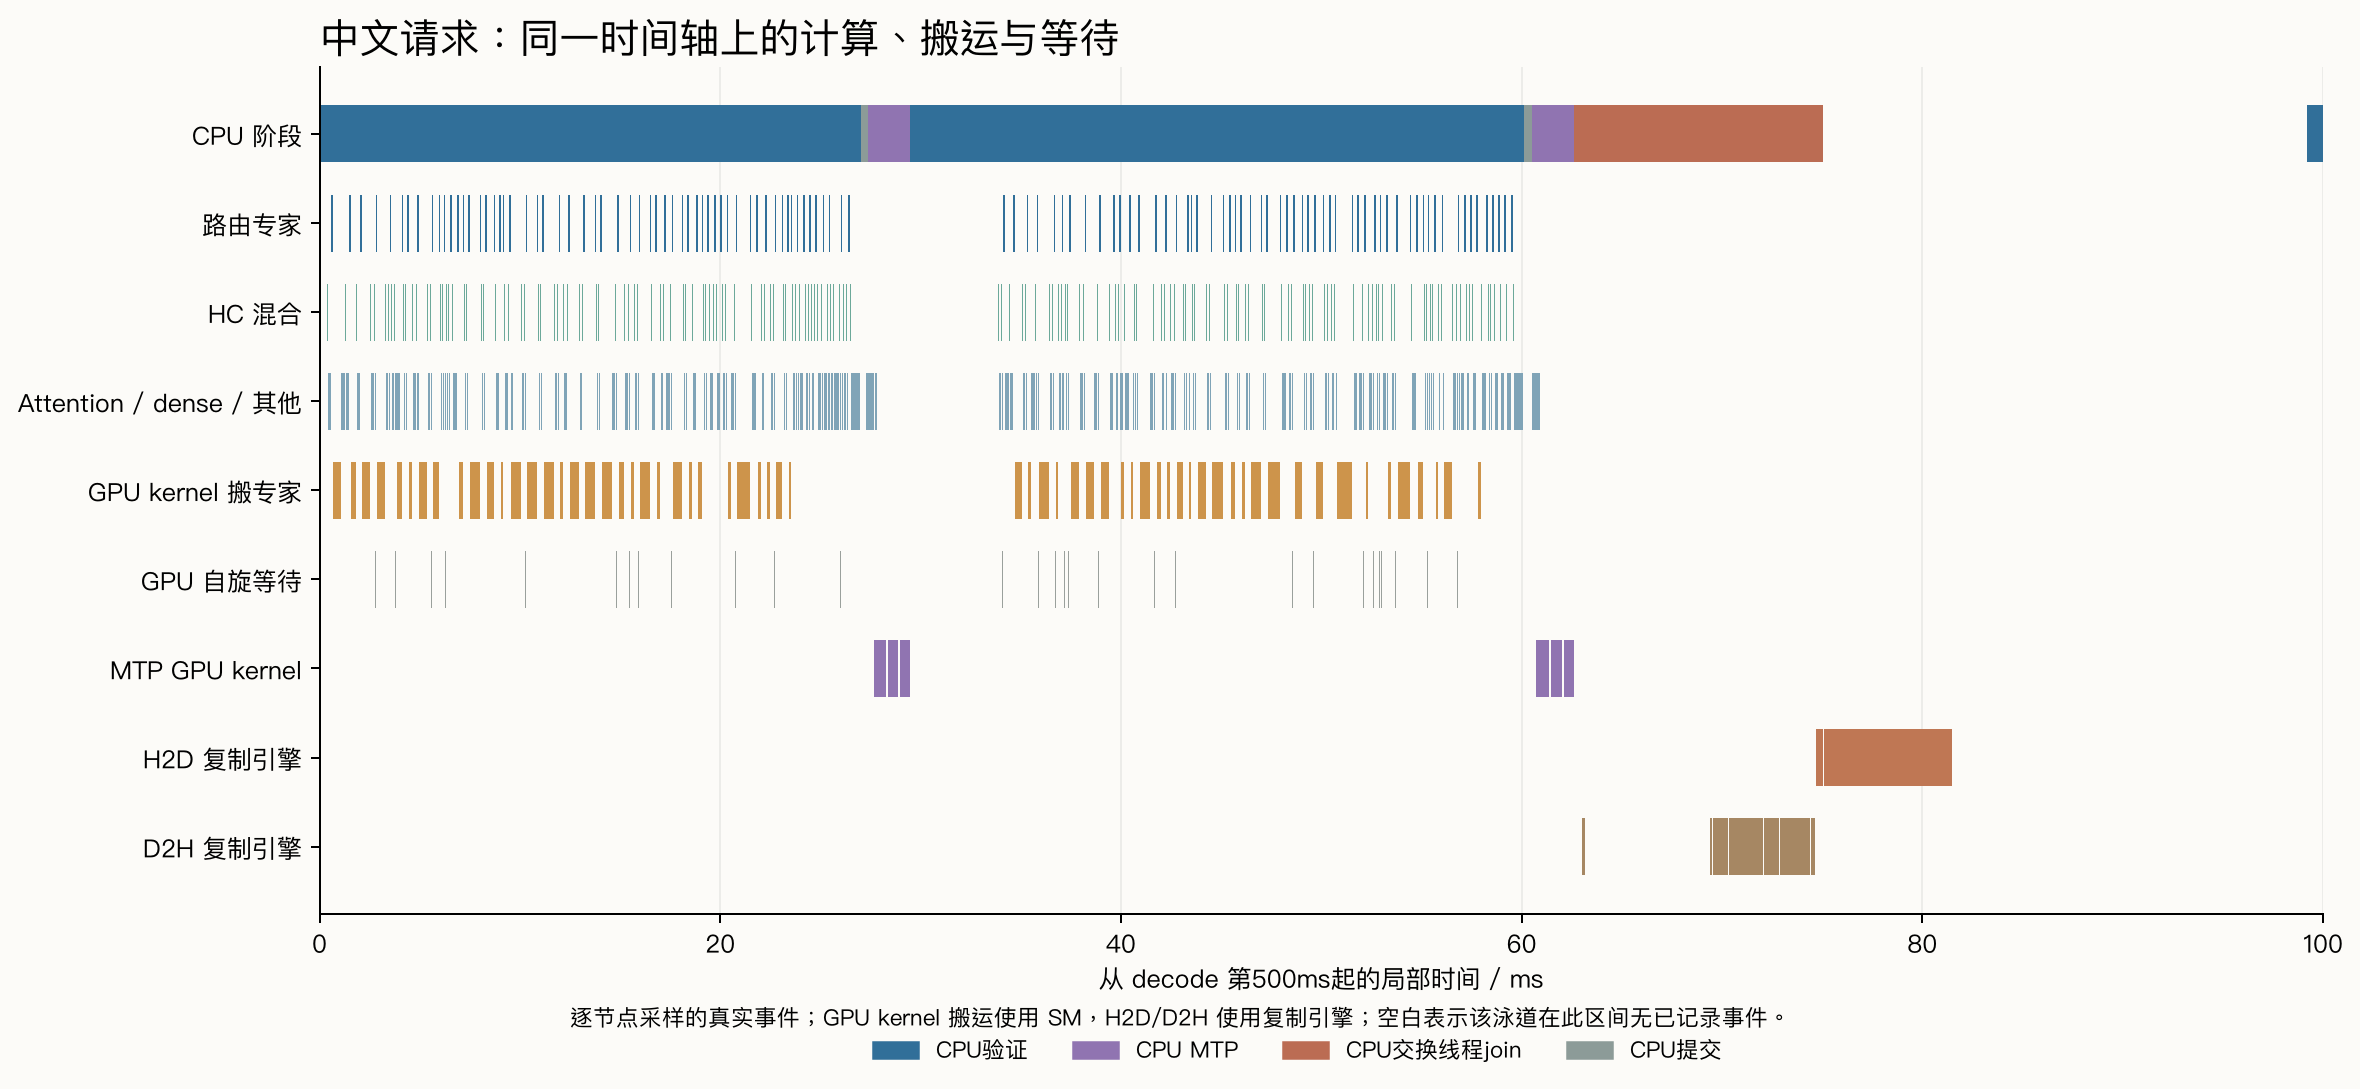
默认路径在 GPU 上执行搬运 kernel,从映射的主机内存读取专家权重;复制引擎还承担冷热专家交换等 H2D/D2H 流量。源码中的 waitB 分段直到搬运 kernel 结束后才记时间,因此较大的 waitB 区间里也包含搬运。把纯 flag 等待与搬运分开以后,后续研究的重点更明确了。
已有开关也做了对照。DMA 与默认路径按正、反顺序各跑独立启动,合并中位数为代码约 +2.6%、中文约 +2.0%,重复范围有重叠。把交换周期从 4 个窗口放宽到 16 个,代码首轮较慢、第二轮才变快;启用 RAM 常驻模式的交换重叠后,主循环外等待下降,verify 内逐层等待增加,净收益仍只有几个百分点。
重叠组还保留了一次最后内容到流式结束约 1.14 秒的等待。后续四次图级采样未重现这条长尾,另有一次约 94ms,其中 CUDA 同步约 0.29ms。它提示收尾也要计入客户端完成时间,原样本原因继续保留待查。
两份固定负载在正常确认组中的输出内容哈希一致。当前日常服务继续使用原配置,DMA 与交换重叠留作候选。decode 分析、计时分层与原始汇总
留给下一轮的四个问题
| 问题 | 本轮已经看到什么 | 下一步怎么验证 |
|---|---|---|
| 主要 kernel 受什么资源限制? | 已分出专家计算、HC、搬运和自旋事件;量化专家采用的执行路径与大矩阵 GEMM 不同 | 对主要 kernel 采集显存吞吐、指令与 warp stall 等硬件计数器,再用无采样请求验证候选实现 |
| 缓存交换还有多少等待可以隐藏? | 交换线程 join 与下一窗口提交有可见成本;现有重叠开关把部分等待推入 verify | 串起逐出专家读回、热专家写入、驻留表提交及逐层消费,比较客户端 TPOT、完整耗时和长尾 |
| DMA 的几个百分点能稳定复现吗? | 正向对照收益较大,反向对照接近持平,合并范围重叠 | 增加交错顺序与独立启动,固定温度、时钟、缓存状态和输入,保留每轮范围 |
| 这些变化能改善实际编码吗? | 固定短输入的 512-token 输出一致;本轮完成了路径分析 | 用长上下文、多轮代码修复和较长输出复测,记录 TTFT、TPOT、E2E、输出长度及执行测试通过率 |
后续沿这四项继续研究。每项都保留当前对照、待验证的解释和完成标准,集中记录在研究清单。
注
本轮为Xeon Platinum8260、32vCPU、系统可见62.76GiB RAM、RTX3090 24GiB,guest可见AVX2,负载PCIe Gen3×16。Strata固定0.1.43 / 7695859,CUDA12.8构建包含sm_86;驱动580.126.09,350W。ModelScope两片IQ2_XS哈希与前篇一致。旧文章使用另一台CPU;本文解锁前后基线全部来自本轮新虚拟机。
固定32K上下文、int8 KV、PLE RAM、resident-experts、7workers、MTP4/minP0.5,关闭尾部专家跳过、prefill CPU分担、前缀和会话缓存。每次恢复相同专家画像,加载和16-token预热另计。原配置与峰值每任务六次,日常候选四次,筛选两次。区间合并峰值组TTFT范围0.509–2.042秒,首个真实请求仍保留。
代码隔离测试限5秒CPU/384MiB地址空间,抽取题精确匹配五字段。本文六类固定任务用于速度定位和回归;完整HumanEval+/Polyglot分数保留在前篇。独立诊断与速度组分开,原始失败和资源上限结果均保留。
本机虚拟机重启和一次NVIDIA reset后仍保留解锁状态。后续解绑驱动,将SS0/SS1写回本卡初始日志原值,FP16/BF16恢复约76TFLOPS,六组矩阵完整输出哈希与最初未解锁端一致;测试后矩阵吞吐与寄存器再次核验。PLM仍开放,本次记录为软件恢复原始性能选择寄存器。分阶段两端共320个正式请求已完成。
补测的28.7K合成prefill每输入两次、固定输出1 token;decode每批四个1024-token请求,各组合两轮。后续82请求含26次预热、56个正常/诊断请求。逐节点采样增加约23%至38%开销,GPU事件用于定位,候选速度采用无采样对照;引擎分段profile关闭部分融合与共享专家并行,单独保留。